
Theo NVIDIA, thị trường GPU cloud được dự báo sẽ vượt mốc 25 tỷ USD vào năm 2030, trong đó nhu cầu đối với các dòng GPU H100 và H200 là động lực tăng trưởng chính. Doanh nghiệp, startup và các phòng lab nghiên cứu đang đặt câu hỏi: nên tiếp tục dùng H100 – dòng GPU đã chứng minh hiệu quả, hay nên nâng cấp lên H200?
Bài blog này cung cấp góc nhìn chi tiết về thông số kỹ thuật, benchmark hiệu năng, các ứng dụng thực tế, giá và xu hướng ứng dụng của NVIDIA H100 vs H200, giúp bạn đưa ra quyết định đúng cho năm 2026 và xa hơn.
Vì sao so sánh NVIDIA H100 vs H200 lại quan trọng?
Nhu cầu tính toán tăng tốc bằng GPU đang bùng nổ. Từ việc huấn luyện các mô hình ngôn ngữ lớn (LLM) đến vận hành các hệ thống tính toán hiệu năng cao (HPC) và phục vụ inference thời gian thực, GPU đã trở thành xương sống của hạ tầng AI hiện đại.
NVIDIA H100 Tensor Core GPU, ra mắt năm 2022, nhanh chóng trở thành GPU flagship của ngành cho cả AI training và inference, đứng sau những mô hình state-of-the-art như GPT-4 của OpenAI hay Claude của Anthropic. Thực tế, H100 quan trọng đến mức các nhà phân tích ước tính hơn 500.000 card H100 đã được xuất xưởng riêng trong năm 2023, mang về cho NVIDIA doanh thu hàng tỷ USD.
Nhưng quá trình tiến hóa không dừng ở đó. Cuối năm 2023, NVIDIA giới thiệu H200 GPU, vẫn xây dựng trên kiến trúc Hopper, nhưng được nâng cấp với công nghệ bộ nhớ HBM3e thế hệ mới. Với dung lượng bộ nhớ lớn hơn, băng thông cao hơn và hiệu năng tốt hơn, H200 được thiết kế cho làn sóng tiếp theo của workload generative AI và HPC ở quy mô exascale.
Tổng quan NVIDIA H100 GPU
Thông số và kiến trúc
NVIDIA H100 GPU được xây dựng trên vi kiến trúc Hopper và tối ưu cho AI và HPC.
Các thông số chính (NVIDIA, 2023):
- CUDA Cores: 14.592
- Tensor Cores: Tensor Core thế hệ 4, cung cấp tới 60 teraflops FP64 và 1.000 teraflops FP16
- Bộ nhớ: 80 GB HBM3
- Băng thông bộ nhớ: 3,35 TB/s
- Công nghệ tiến trình: TSMC 4N
Đây là bước nhảy ~3× về hiệu năng so với thế hệ trước A100, đặc biệt ở throughput huấn luyện AI.
Các ứng dụng của H100
NVIDIA H100 Tensor Core GPU được thiết kế cho các workload AI hiệu năng cao, đa mục đích – từ huấn luyện các mô hình foundation khổng lồ đến vận hành hệ thống inference thời gian thực trong môi trường production. Đây là một bước nhảy thế hệ về mật độ compute, băng thông bộ nhớ và khả năng scale trên các bài toán AI, phân tích dữ liệu và tính toán khoa học.
Huấn luyện mô hình AI
Kiến trúc Hopper và Transformer Engine trên H100 được tối ưu để huấn luyện các mô hình AI cực lớn.
- Large Language Models (LLMs): Cho phép huấn luyện hiệu quả các mô hình như GPT-class, LLaMA 3, Mistral hoặc GreenMind, rút ngắn thời gian training tới 4× so với A100.
- Computer Vision: Tăng tốc các kiến trúc CNN và transformer dùng cho perception stack xe tự lái và phân tích ảnh vệ tinh.
- Speech và NLP: Giảm độ trễ cho các mô hình nhận dạng giọng nói và dịch như Whisper hoặc các hệ thống dựa trên BERT, rất quan trọng cho các công cụ giao tiếp thời gian thực.
Ví dụ: Các doanh nghiệp triển khai cluster DGX H100 multi-node báo cáo giảm tới 30% chi phí mỗi lần fine-tune LLM so với cluster A100, nhờ tối ưu mixed-precision và băng thông NVLink.
AI inference và serving thời gian thực
H100 đặc biệt mạnh ở inference độ trễ thấp cho generative AI, cung cấp throughput rất lớn cho mô hình đã deploy.
- Ứng dụng Generative AI: Hỗ trợ phục vụ API khối lượng lớn cho chatbot, copilots và trợ lý đa modal xây trên các open LLM như Falcon, GreenMind hoặc Mistral.
- Recommendation Systems: Làm backbone cho hệ thống gợi ý nội dung cá nhân hóa trong nền tảng streaming và e-commerce, xử lý hàng tỷ lượt inference mỗi ngày.
- Triển khai ở edge: Kết hợp với NVIDIA NIM hoặc Triton Inference Server, H100 cho phép serving nhiều mô hình một cách hiệu quả trong môi trường enterprise hoặc cloud.
Ví dụ: Throughput inference trên H100 với vLLM hoặc Triton có thể vượt 10.000 token/giây trên các LLM đã tối ưu, rất phù hợp cho API generative AI traffic cao.
Phân tích dữ liệu doanh nghiệp và pipeline AI
Với khả năng tăng tốc GPU cho các framework dữ liệu như RAPIDS, Spark RAPIDS và cuDF, H100 mở rộng giá trị vượt ra ngoài huấn luyện mô hình.
- Data Engineering: Cho phép ETL và feature engineering thời gian thực trên data lake kích thước terabyte.
- Business Intelligence (BI): Tăng tốc render dashboard, truy vấn phân tích và phát hiện bất thường.
- AI-Powered Databases: Tích hợp với các hệ thống cơ sở dữ liệu tăng tốc GPU như Heavy.AI và BlazingSQL để phân tích ở quy mô chưa từng có.
Ví dụ: Các tổ chức tài chính sử dụng RAPIDS trên H100 báo cáo cải thiện tốc độ mô phỏng rủi ro danh mục tới 45× so với cluster chỉ dùng CPU.
Workflow AI đa modal và generative
Băng thông bộ nhớ rất cao của H100 (HBM3 tới 3,35 TB/s) và khả năng song song hóa cực lớn khiến nó rất phù hợp cho workload đa modal kết hợp text, image và audio.
- Video Understanding: Captioning và phát hiện đối tượng thời gian thực trong giám sát video hoặc pipeline media.
- Healthcare Imaging: Chẩn đoán hỗ trợ AI kết hợp dữ liệu hình ảnh và báo cáo văn bản.
- Creative AI: Hỗ trợ các diffusion model như Stable Diffusion XL và pipeline tạo video từ văn bản.
Ví dụ: Kết hợp với tối ưu TensorRT-LLM của NVIDIA, việc render ảnh bằng diffusion trên H100 nhanh hơn A100 khoảng 2–3×.
Khám phá cluster H100 trên GreenNode, chạy thử LLM hoặc pipeline dữ liệu hiện tại để xem mức giảm thời gian huấn luyện và chi phí trên mỗi job.
Tổng quan NVIDIA H200 GPU
Thông số và các cải tiến mới
NVIDIA H200, ra mắt cuối năm 2023, là phiên bản nâng cấp của dòng Hopper với bộ nhớ HBM3e, mang lại cả dung lượng lẫn băng thông cao hơn.
Các thông số chính (NVIDIA, 2024):
- CUDA Cores: Tương tự H100 (14.592)
- Tensor Cores: Tensor Core thế hệ 4 với một số tinh chỉnh
- Bộ nhớ: 141 GB HBM3e (so với 80 GB trên H100)
- Băng thông bộ nhớ: 4,8 TB/s (cao hơn ~42% so với H100)
- Hiệu quả năng lượng: Cải thiện TCO tới 50% so với H100
Benchmark hiệu năng
- Lợi thế bộ nhớ: H200 có dung lượng bộ nhớ lớn hơn ~76% và băng thông cao hơn ~43% so với H100.
- Benchmark LLM: Các bài test MLPerf trên Llama2-70B cho thấy H200 đạt 31.712 token/giây, trong khi H100 đạt 21.806 token/giây, tương đương cải thiện ~45%.
- AI inference: NVIDIA báo cáo H200 cho hiệu năng inference nhanh hơn tới 1,9× cho các workload generative AI.
- HPC: H200 đem lại cải thiện tới 110× về hiệu năng mô phỏng cho các ứng dụng khoa học.
Các use case của NVIDIA H200 GPU
NVIDIA H200 Tensor Core GPU là bước tiến tiếp theo của kiến trúc Hopper, được thiết kế để đẩy giới hạn của inference AI, fine-tuning và tính toán hiệu năng cao. Với 141 GB HBM3e và băng thông 4,8 TB/s, H200 có dung lượng bộ nhớ lớn hơn 1,44× và băng thông cao hơn 1,8× so với H100, rất phù hợp với các workload AI và HPC khổng lồ cần cả khả năng scale và hiệu suất.
AI inference ở quy mô lớn
H200 được thiết kế hướng tới inference throughput cao, latency thấp, cho phép tổ chức triển khai dịch vụ AI quy mô lớn một cách hiệu quả.
- Large Language Models (LLMs): Lý tưởng để host các LLM rất lớn (open hoặc proprietary) trên một card GPU, giảm nhu cầu model parallelism.
- Ứng dụng Generative AI: Tối ưu cho serving chatbot, copilots và hệ thống tạo nội dung thời gian thực, xử lý nhiều token/giây hơn với độ trễ thấp hơn.
- Enterprise inference APIs: Kết hợp với NVIDIA Triton Inference Server hoặc NIM microservices, H200 tăng tốc triển khai mô hình production trên nhiều ngành.
Ví dụ: Benchmark cho thấy H200 có thể tăng throughput inference tới 60% so với H100 trên các mô hình transformer lớn, giúp serving nền tảng generative AI nhanh hơn, rẻ hơn.
Fine-tuning và tùy biến LLM
Dung lượng bộ nhớ mở rộng (141 GB HBM3e) khiến H200 trở thành một “máy fine-tune” mạnh mẽ cho các mô hình foundation, đặc biệt trong các bài toán cần context window lớn hoặc chuỗi đầu vào rất dài.
- Fine-tune theo domain: Cho phép retrain hiệu quả mô hình base cho các lĩnh vực như tài chính, healthcare hoặc legal AI mà không cần shard mô hình qua nhiều GPU.
- Các phương pháp parameter-efficient (LoRA, adapter): Hỗ trợ batch size lớn hơn và fine-tune với context dài với hiệu quả sử dụng bộ nhớ cao hơn.
- Hiệu quả training: Kết hợp với NVIDIA NeMo và TensorRT-LLM, team có thể fine-tune các mô hình hàng tỷ tham số với chi phí điện và thời gian thấp hơn.
Ví dụ: Nhiều doanh nghiệp báo cáo rằng cluster H200 có thể giảm thời gian fine-tune cho mô hình đa tỷ tham số tới 40% so với cấu hình H100.
HPC và mô phỏng khoa học
H200 tiếp tục củng cố vị thế của NVIDIA trong HPC và mô hình khoa học, cung cấp băng thông bộ nhớ kỷ lục cho các mô phỏng quy mô rất lớn.
- Mô phỏng khí hậu và thời tiết: Hỗ trợ workload exascale với độ chính xác cải thiện và thời gian hoàn thành ngắn hơn.
- Mô phỏng vật lý và kỹ thuật: Cho phép mesh độ phân giải cao hơn trong CFD, khoa học vật liệu và mô phỏng năng lượng.
- Genomics và bioinformatics: Tăng tốc xử lý sequencing quy mô lớn, phát hiện molecule và bài toán protein folding dùng AI.
Ví dụ: Các cluster nghiên cứu như siêu máy tính ABCI 3.0 của Nhật sử dụng H200 để kết hợp AI và HPC, đạt tốc độ mô phỏng chưa từng có cho cả workload khoa học lẫn generative.
Khám phá H200 trên GreenNode ngay hôm nay, thử fine-tune hoặc serving mô hình lớn với HBM3e 141 GB và so sánh trực tiếp với cấu hình H100 hiện tại.
Sự khác nhau giữa NVIDIA H100 và H200
Dung lượng và băng thông bộ nhớ
H100: 80 GB HBM3, 3,35 TB/s
H200: 141 GB HBM3e, 4,8 TB/s
H200 gần như nhân đôi dung lượng bộ nhớ và tăng băng thông hơn 40%. Nâng cấp này giúp H200 xử lý các mô hình AI lớn hơn và workload HPC nặng dữ liệu hiệu quả hơn.
So sánh hiệu năng huấn luyện AI
Trong khi NVIDIA H100 đã rất mạnh cho việc huấn luyện các mô hình AI state-of-the-art, H200 đi xa hơn bằng cách cải thiện throughput và rút ngắn thời gian training cho các workload LLM và generative AI vượt quá giới hạn bộ nhớ của H100.
Hiệu quả và khả năng scale cho LLM
NVIDIA H100 vẫn là lựa chọn hiệu quả cho các mô hình AI “chuẩn” hiện tại, trong khi H200 được thiết kế cho việc scale vượt lên kích thước mô hình ngày nay, hỗ trợ batch size lớn hơn và quản lý tham số hiệu quả hơn.
Pricing và khả dụng trong năm 2025
H100 hiện đã phổ biến trên các cloud instance và hệ thống DGX, với mức giá vẫn cao nhưng đang dần ổn định. H200 được kỳ vọng đắt hơn bởi công nghệ bộ nhớ nâng cấp và ban đầu sẽ chủ yếu xuất hiện trên các dịch vụ cloud cao cấp và hệ thống DGX phân khúc cao.
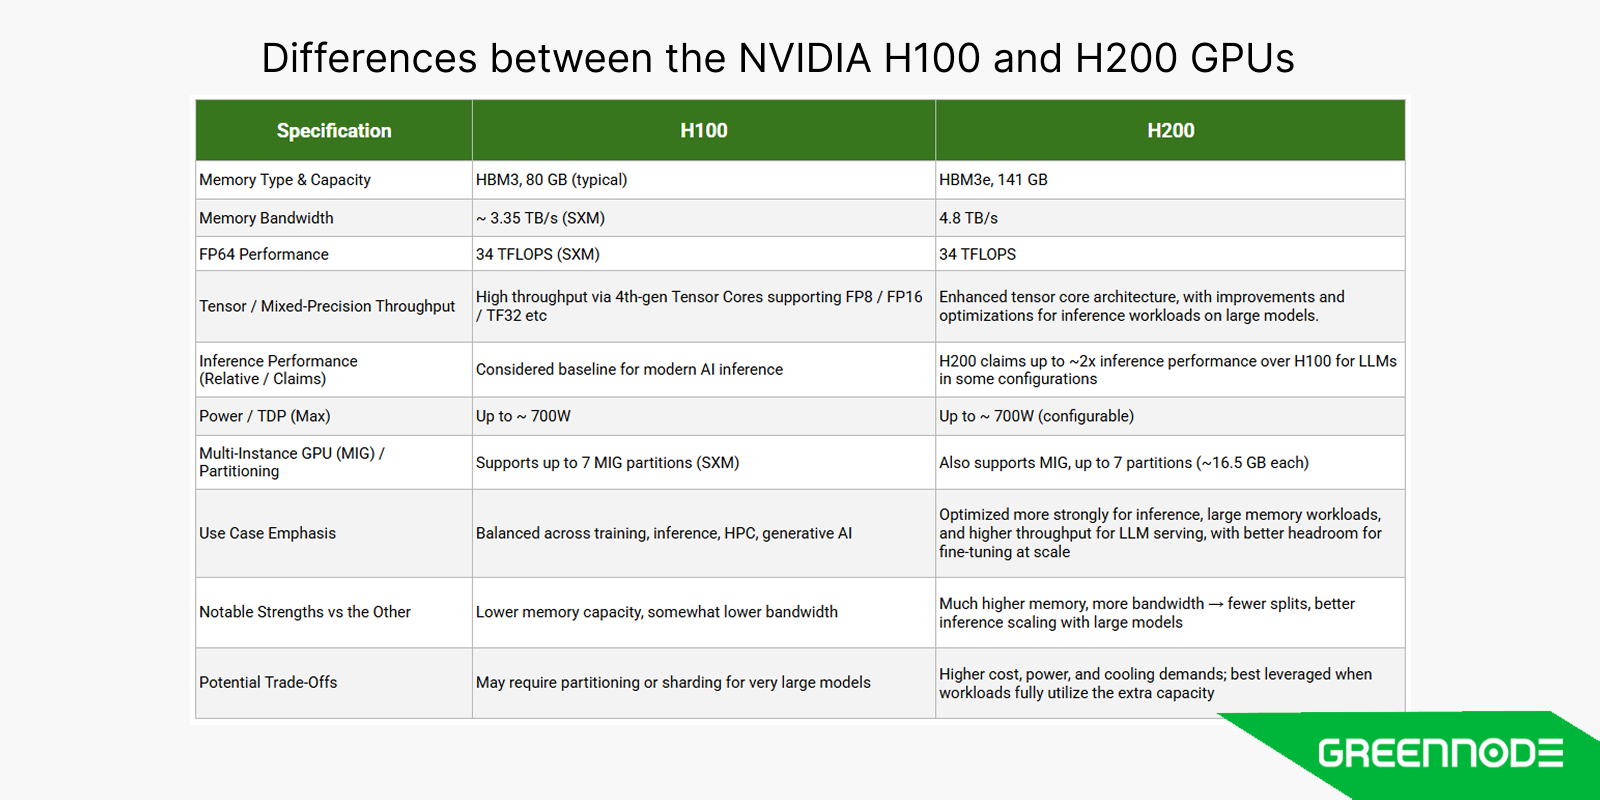
NVIDIA H100 vs H200: nên chọn GPU nào?
Việc lựa chọn giữa NVIDIA H100 và H200 phụ thuộc rất nhiều vào yêu cầu workload, ngân sách và quy mô triển khai của bạn.
Chọn H100 nếu:
- Bạn cần GPU phổ biến, tối ưu về chi phí.
- Workload của bạn vừa vặn trong dung lượng 80 GB HBM3.
- Bạn chủ yếu chạy inference AI hoặc huấn luyện các mô hình kích thước vừa.
Chọn H200 nếu:
- Bạn huấn luyện LLM với hàng tỷ tham số.
- Bạn cần dung lượng bộ nhớ lớn (141 GB) cho các bộ dữ liệu rất lớn.
- Bạn cần throughput tối đa cho generative AI hoặc HPC.
- Ngân sách cho phép mức giá premium.
Tóm lại, H100 vẫn là lựa chọn thực tế nhất cho phần lớn doanh nghiệp và startup, trong khi H200 được định vị như GPU “future-ready” cho các tổ chức đang đẩy giới hạn scale của AI.
Sẵn sàng khai thác sức mạnh NVIDIA H100 và H200 cùng GreenNode?
Tương lai của AI, cloud và tính toán hiệu năng cao đang được định hình bởi những GPU như NVIDIA H100 và H200. Dù bạn đang scale training, chạy mô phỏng HPC hay deploy inference thời gian thực, thành công không chỉ phụ thuộc vào hardware, mà còn vào việc tìm đúng partner để vận hành.
Tại GreenNode, chúng tôi cung cấp:
- Giá thuê GPU thấp hơn so với các cloud provider lớn
- Khả năng truy cập tức thì vào hạ tầng GPU compute (H100 & H200)
- Đội ngũ hỗ trợ 24/7 hiểu rõ workload AI của bạn
Tăng tốc hành trình AI của bạn ngay hôm nay với giải pháp GPU compute từ GreenNode. Liên hệ đội ngũ nếu bạn muốn đặt một buổi tư vấn ngắn.
FAQs
1. Những khác biệt chính giữa NVIDIA H100 và H200 là gì?
H200 gần như nhân đôi dung lượng bộ nhớ (141 GB HBM3e so với 80 GB HBM3) và tăng băng thông ~42%, khiến nó phù hợp hơn cho các mô hình AI rất lớn và workload HPC nặng dữ liệu.
2. H200 có tốt hơn H100 cho việc huấn luyện AI không?
Có. Bộ nhớ HBM3e và băng thông cao hơn giúp H200 cải thiện throughput training và xử lý được những bộ dữ liệu, mô hình lớn hơn so với H100.
3. Giá H200 sẽ như thế nào so với H100 vào năm 2026?
H200 sẽ được định giá cao hơn do công nghệ bộ nhớ nâng cấp và nguồn cung ban đầu hạn chế. Các cloud provider được kỳ vọng sẽ cung cấp instance H200 với mức giá premium.
4. Startup có thể truy cập GPU H100 và H200 qua các nhà cung cấp cloud không?
Có. GreenNode hiện đã cung cấp cả H100 và H200 dưới dạng GPU instance, cho phép startup và đội AI/ML truy cập trực tiếp sức mạnh xử lý của hai dòng GPU này mà không cần đầu tư hạ tầng phần cứng riêng.
