
Mọi dự án phân tích và AI hiện đại đều bắt đầu từ một câu hỏi: làm sao để đưa dữ liệu vào hệ thống?
Trước khi có thể tạo ra insight hay huấn luyện mô hình, dữ liệu phải được thu thập, vận chuyển và đưa vào đúng nơi, đảm bảo nó sạch, có cấu trúc và sẵn sàng để sử dụng. Quá trình đó được gọi là data ingestion (thu nạp dữ liệu), và nó tạo nên xương sống của mọi pipeline dữ liệu. Tuy nhiên, 80% các data warehouse trên đám mây xác định việc thu nạp dữ liệu là nút thắt cổ chai phổ biến nhất trong việc mở rộng quy mô các khối lượng công việc phân tích (Databricks).
Trong bài viết này, chúng ta sẽ phân tích data ingestion thực sự là gì: định nghĩa, các loại hình, quy trình cốt lõi, và làm nổi bật những công cụ hàng đầu mà các đội ngũ dữ liệu đang sử dụng hiện nay.
Data Ingestion là gì?
Theo IBM, data ingestion là quá trình thu thập và nhập dữ liệu từ nhiều nguồn khác nhau vào một hệ thống lưu trữ hoặc xử lý tập trung, chẳng hạn như data warehouse, data lake, hoặc engine phân tích thời gian thực. Đây là giai đoạn đầu tiên của pipeline dữ liệu, đảm bảo rằng thông tin, dù có cấu trúc, bán cấu trúc, hay phi cấu trúc, đều sẵn sàng cho các tác vụ tiếp theo như chuyển đổi, phân tích, và machine learning.
Nói một cách đơn giản hơn, data ingestion là cách dữ liệu thô di chuyển từ nơi nó được tạo ra (ứng dụng, thiết bị IoT, API, cảm biến, log, hoặc các nguồn cấp dữ liệu bên ngoài) đến nơi nó được phân tích. Nếu không có nó, các nhà khoa học dữ liệu, chuyên viên phân tích và công cụ kinh doanh sẽ không có gì để làm việc.
Mục đích cốt lõi của data ingestion là tạo ra một luồng dữ liệu đáng tin cậy và tự động xuyên suốt tổ chức. Điều này giúp:
- Truy cập kịp thời vào thông tin để ra quyết định.
- Tính nhất quán giữa các hệ thống và bộ phận.
- Khả năng mở rộng khi số lượng và khối lượng nguồn dữ liệu tăng lên.
- Độ chính xác bằng cách đảm bảo cùng một phiên bản dữ liệu đúng đắn nuôi dưỡng các mô hình phân tích và AI.
Vì sao Data Ingestion quan trọng đối với kiến trúc dữ liệu hiện đại
Dữ liệu đang được tạo ra ở khắp mọi nơi, từ tương tác của khách hàng và các thiết bị kết nối đến hệ thống nội bộ và dịch vụ đám mây. Data ingestion hiệu quả đóng vai trò là cầu nối giữa dữ liệu thô và insight có thể hành động, khiến nó trở thành nền tảng của kiến trúc dữ liệu hiện đại. Đây là lý do vì sao nó quan trọng:
Tập trung hóa và khả năng truy cập: Data ingestion cho phép các tổ chức hợp nhất các nguồn dữ liệu rời rạc, từ hệ thống CRM, ứng dụng SaaS, thiết bị IoT, đến cơ sở dữ liệu on-premise, vào một kho lưu trữ tập trung duy nhất. Điều này tạo ra một cái nhìn thống nhất về hoạt động kinh doanh và loại bỏ các silo dữ liệu vốn thường dẫn đến những insight trùng lặp hoặc mâu thuẫn.
Insight thời gian thực và khả năng phản ứng nhanh: Với sự trỗi dậy của streaming ingestion, doanh nghiệp giờ đây có thể hành động dựa trên dữ liệu ngay tại thời điểm nó được tạo ra. Streaming ingestion hỗ trợ các trường hợp ứng dụng như phát hiện gian lận, bảo trì dự đoán, và trải nghiệm khách hàng cá nhân hóa, nơi từng mili giây có thể tạo nên sự khác biệt giữa thành công và cơ hội bị bỏ lỡ.
Nền tảng cho phân tích, AI và tuân thủ: Mọi dashboard, mô hình, hay đề xuất AI đều phụ thuộc vào data ingestion đáng tin cậy. Nó đảm bảo các công cụ phân tích luôn lấy được dữ liệu mới, nhất quán và được quản trị tốt, điều cực kỳ quan trọng để duy trì độ chính xác và tuân thủ các quy định về dữ liệu như GDPR hay PDPD.
Pipeline Data Ingestion
Một pipeline data ingestion là nền tảng của bất kỳ kiến trúc dữ liệu hiện đại nào. Đây là luồng có cấu trúc di chuyển thông tin từ nơi nó được tạo ra, chẳng hạn như ứng dụng, cảm biến, hoặc cơ sở dữ liệu, đến nơi nó được phân tích, thường là trong một data warehouse, data lake, hoặc hệ thống phân tích thời gian thực. Một pipeline ingestion được thiết kế tốt đảm bảo dữ liệu đến đích nhanh chóng, an toàn, và ở định dạng có thể sử dụng được, tạo nên bước đầu tiên hướng tới các phân tích và AI có ý nghĩa.
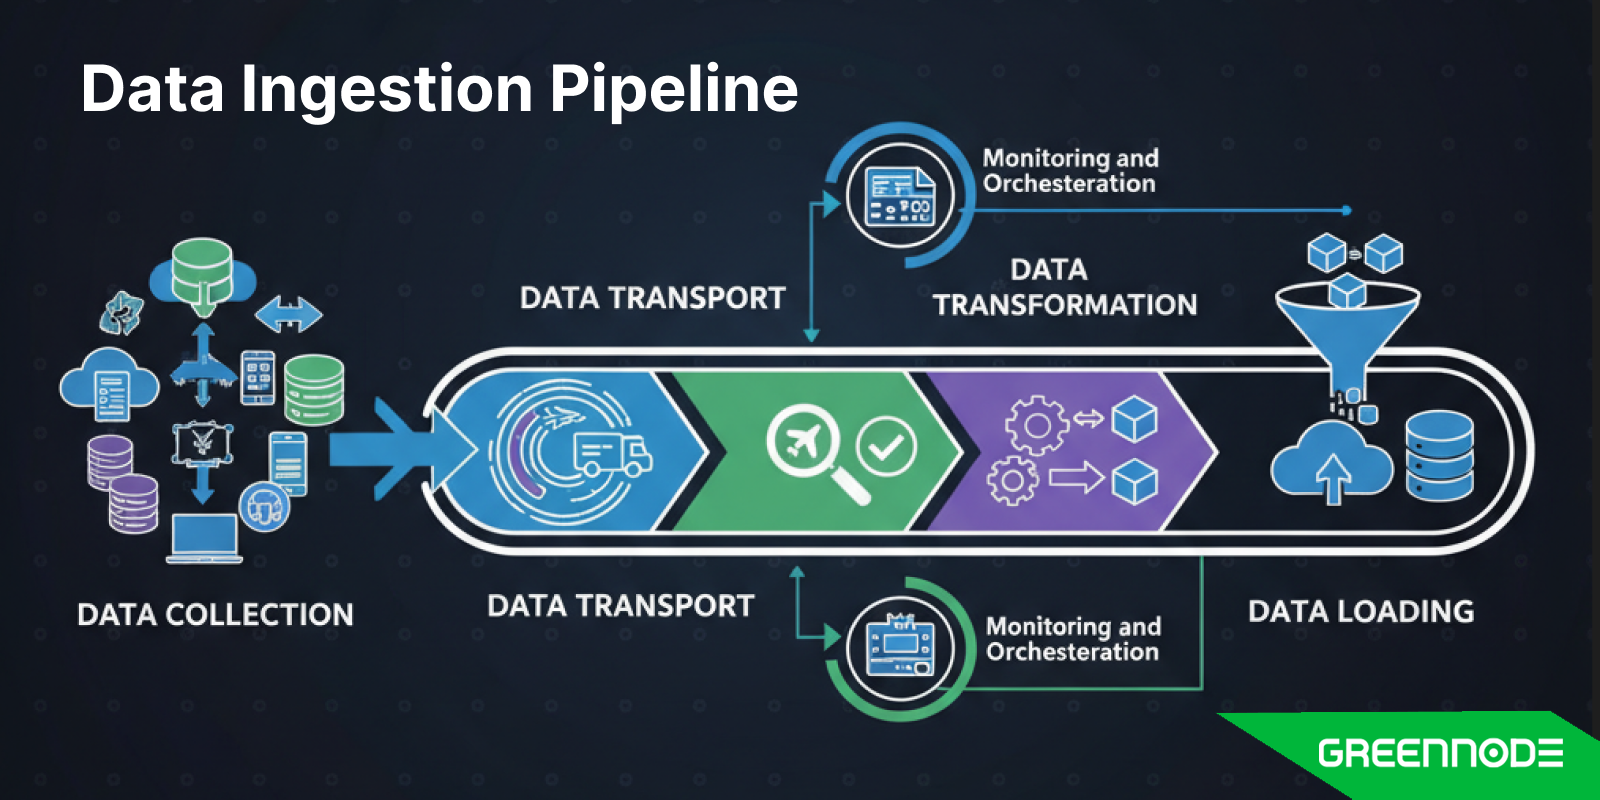
Các giai đoạn chính của một pipeline data ingestion hiện đại bao gồm:
- Thu thập dữ liệu (Data Collection)
- Vận chuyển dữ liệu (Data Transport)
- Xác thực dữ liệu (Data Validation)
- Chuyển đổi dữ liệu (Data Transformation)
- Tải dữ liệu (Data Loading)
- Giám sát và điều phối (Monitoring and Orchestration)
Bây giờ, hãy cùng phân tích sâu hơn từng giai đoạn của pipeline data ingestion.
Thu thập dữ liệu: Đây là bước đầu tiên của pipeline, nơi thông tin được thu thập từ nhiều nguồn khác nhau bao gồm API, nền tảng SaaS, thiết bị IoT, tệp log, hoặc cơ sở dữ liệu truyền thống. Tùy theo yêu cầu kinh doanh, dữ liệu có thể được thu nạp theo lô tại các khoảng thời gian định kỳ hoặc truyền liên tục theo thời gian thực. Batch ingestion thường được sử dụng cho các cập nhật lớn nhưng không thường xuyên, chẳng hạn như báo cáo doanh số hàng ngày hoặc báo cáo hiệu suất hàng tuần, trong khi streaming ingestion xử lý dữ liệu cần được chú ý ngay lập tức, như giao dịch tài chính, số liệu cảm biến IoT, hoặc log hoạt động của người dùng. Mục tiêu ở giai đoạn này là thiết lập các kết nối nhất quán, có khả năng mở rộng tới tất cả các nguồn dữ liệu để không bỏ sót bất kỳ thông tin quý giá nào.
Vận chuyển dữ liệu: Sau khi dữ liệu được thu thập, nó chuyển sang giai đoạn vận chuyển, nơi nó được truyền từ nguồn đến một lớp ingestion hoặc môi trường staging. Giai đoạn này thường dựa vào các message broker và công cụ di chuyển dữ liệu để đảm bảo luồng dữ liệu chảy liên tục và an toàn. Độ tin cậy, tốc độ, và khả năng chịu lỗi là yếu tố then chốt ở đây vì hệ thống phải xử lý được các gián đoạn mạng, thử lại (retry), và mã hóa mà không làm mất bất kỳ bản ghi nào. Về bản chất, giai đoạn này đóng vai trò như một "xa lộ tốc độ cao" kết nối dữ liệu thô với các hệ thống sẽ diễn giải nó.
Xác thực dữ liệu: Sau khi dữ liệu đến khu vực staging, nó trải qua bước xác thực, đảm bảo rằng thông tin chính xác, đầy đủ, và nhất quán. Đây là một điểm kiểm tra chất lượng quan trọng: dữ liệu được kiểm tra xem có thiếu trường, sai kiểu dữ liệu, giá trị nằm ngoài phạm vi, hoặc các mục nhập trùng lặp hay không. Nếu phát hiện lỗi, pipeline sẽ tự động sửa hoặc đánh dấu để xem xét. Việc xác thực đảm bảo chỉ có dữ liệu sạch, đáng tin cậy mới được chuyển tiếp xuống các bước sau.
Chuyển đổi dữ liệu: Đây là nơi dữ liệu đã được xác thực được chuyển đổi thành định dạng có thể sử dụng được, chuẩn hóa, và được tối ưu hóa cho việc phân tích hoặc machine learning. Điều này có thể bao gồm việc chuẩn hóa (normalization) để loại bỏ sự dư thừa, tổng hợp (aggregation) để tóm tắt các tập dữ liệu lớn, hoặc tiêu chuẩn hóa để đảm bảo quy ước đặt tên, đơn vị, và định dạng thống nhất. Trong nhiều hệ thống, việc chuyển đổi diễn ra ngay trong pipeline ingestion, được gọi là ETL (Extract, Transform, Load), trong khi ở các hệ thống khác, nó diễn ra sau khi tải dữ liệu. Mục đích vẫn giống nhau: làm cho dữ liệu nhất quán, có cấu trúc, và dễ phân tích.
Tải dữ liệu: Trong bước này, dữ liệu đã được chuẩn bị sẽ được ghi vào đích cuối cùng, chẳng hạn như một data warehouse trên đám mây, một data lake, hoặc một nền tảng lakehouse. Tại đây, dữ liệu được tổ chức để tối ưu hiệu suất và khả năng truy cập, thường thông qua việc phân vùng (partitioning), lập chỉ mục (indexing), hoặc đệm (caching). Một quy trình tải dữ liệu được tối ưu hóa tốt đảm bảo các công cụ business intelligence, dashboard, và hệ thống machine learning có thể truy cập dữ liệu mới nhất mà không bị trễ.
Giám sát và điều phối: Cuối cùng, một pipeline data ingestion trưởng thành bao gồm việc giám sát và điều phối để duy trì độ tin cậy theo thời gian. Các công cụ giám sát theo dõi các chỉ số như độ trễ, thông lượng, và chất lượng dữ liệu, trong khi các framework điều phối lên lịch quy trình làm việc và quản lý các phụ thuộc. Việc giám sát liên tục giúp các đội ngũ phát hiện sự cố sớm, duy trì độ mới của dữ liệu, và đảm bảo tuân thủ các chính sách quản trị dữ liệu.
Các loại Data Ingestion
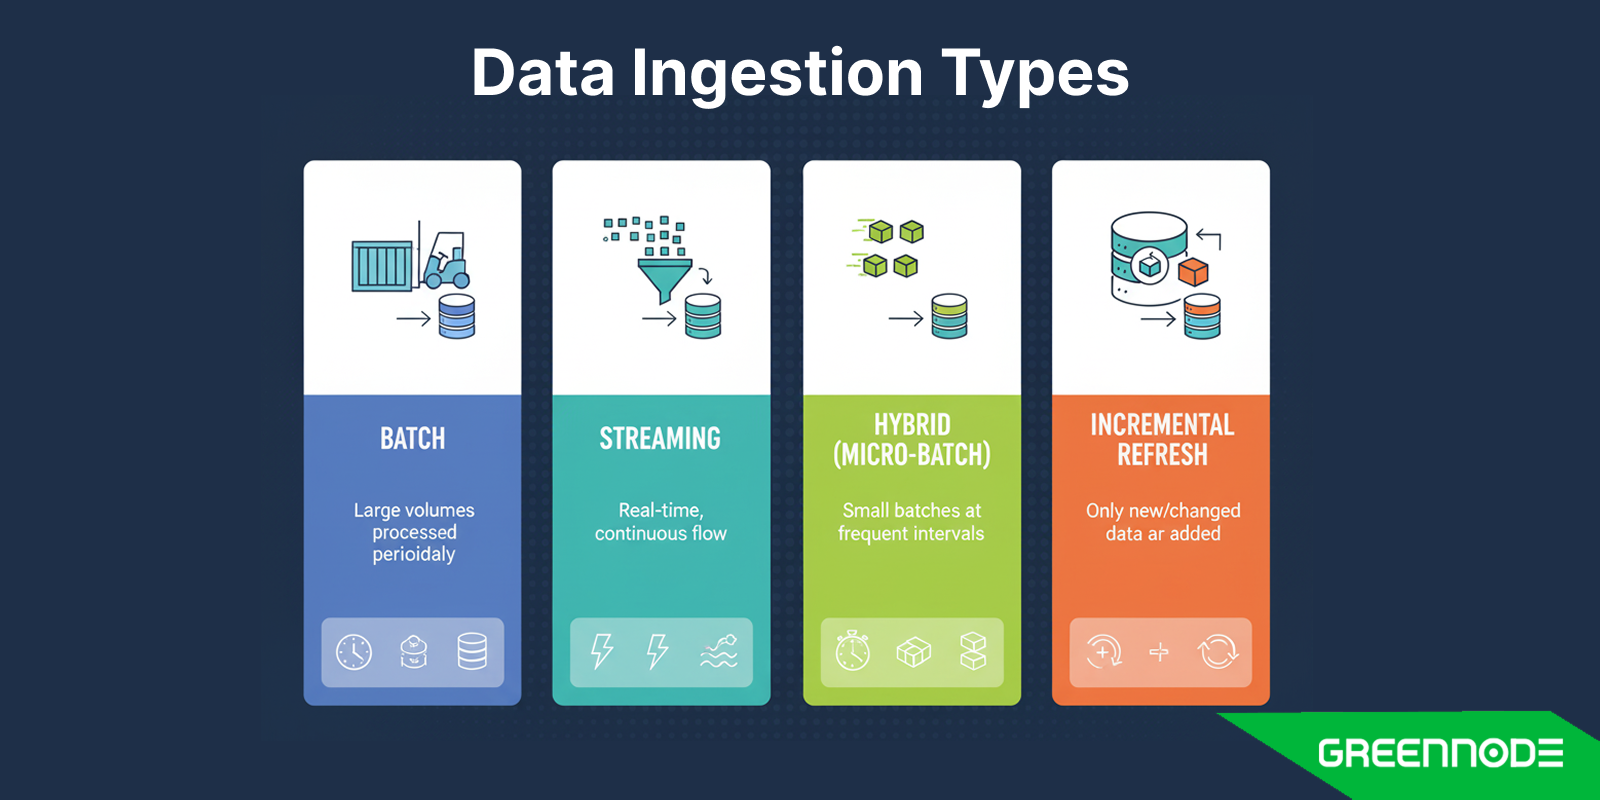
Data ingestion có thể có nhiều hình thức khác nhau tùy thuộc vào tần suất thu thập dữ liệu và tốc độ dữ liệu cần sẵn sàng để phân tích. Nhìn chung, các phương pháp ingestion được chia thành bốn nhóm chính: batch, streaming, hybrid (hay micro-batch), và incremental refresh. Hiểu rõ từng cách tiếp cận giúp các đội ngũ dữ liệu lựa chọn chiến lược phù hợp với mục tiêu kinh doanh, yêu cầu hiệu suất, và hạ tầng của họ.
Batch Ingestion
Batch ingestion là quá trình thu thập và truyền dữ liệu tại các khoảng thời gian định kỳ, chẳng hạn như hàng giờ, hàng ngày, hoặc hàng tuần, thay vì liên tục. Trong cách tiếp cận này, dữ liệu từ nhiều nguồn được nhóm lại với nhau, xử lý, và tải vào hệ thống đích như một lô lớn duy nhất.
Batch ingestion đặc biệt hữu ích cho các khối lượng công việc mà cập nhật theo thời gian thực là không cần thiết hoặc không khả thi. Ví dụ, một nhà bán lẻ có thể tổng hợp các giao dịch bán hàng hàng ngày vào ban đêm, hoặc một đội ngũ tài chính có thể xử lý báo cáo cuối ngày để cập nhật dashboard vào sáng hôm sau. Phương pháp này đơn giản, tiết kiệm chi phí, và phù hợp để xử lý các tập dữ liệu lịch sử lớn hoặc đồng bộ hóa dữ liệu định kỳ giữa các hệ thống.
Tuy nhiên, batch ingestion cũng có những hạn chế: nó tạo ra độ trễ giữa thời điểm dữ liệu được tạo ra và thời điểm nó sẵn sàng để phân tích. Trong các tình huống đòi hỏi độ chính xác theo từng phút, các tổ chức thường chuyển sang các phương pháp streaming hoặc hybrid.
Streaming (Real-Time) Ingestion
Ngược lại, streaming ingestion (đôi khi được gọi là real-time ingestion) liên quan đến việc liên tục thu thập và truyền tải dữ liệu ngay khi nó được tạo ra.
Cách tiếp cận này rất cần thiết trong các trường hợp ứng dụng như giám sát cảm biến IoT, phát hiện gian lận, quảng cáo trực tuyến, hoặc cá nhân hóa người dùng theo thời gian thực. Ví dụ, một công ty logistics có thể theo dõi tín hiệu GPS trực tiếp từ hàng nghìn phương tiện, hoặc một ngân hàng có thể gắn cờ các giao dịch đáng ngờ chỉ trong vài giây.
Streaming ingestion dựa vào các công nghệ có khả năng xử lý các luồng dữ liệu thông lượng cao, độ trễ thấp. Dù đòi hỏi hạ tầng phức tạp hơn, nó mang lại sự linh hoạt mà các hệ thống phân tích và AI hiện đại yêu cầu, đảm bảo các quyết định được đưa ra dựa trên thông tin mới nhất hiện có.
Hybrid hoặc Micro-Batch Ingestion
Nằm giữa batch và streaming là hybrid ingestion, còn được gọi là micro-batch ingestion. Phương pháp này kết hợp những điểm tốt nhất của cả hai: nó thu thập dữ liệu theo các lô nhỏ, thường xuyên, chẳng hạn như mỗi vài phút một lần, cho phép cập nhật gần như theo thời gian thực mà không có chi phí phát sinh của việc streaming liên tục.
Hybrid ingestion mang lại sự linh hoạt cho các tổ chức muốn có dữ liệu cập nhật nhưng không cần xử lý theo từng giây. Nó thường được sử dụng trong các pipeline business intelligence, hệ thống giám sát, hoặc phân tích log, nơi mục tiêu là cân bằng giữa độ mới của dữ liệu và hiệu quả chi phí.
Hybrid ingestion đặc biệt có giá trị khi xử lý các khối lượng công việc hỗn hợp, chẳng hạn, một công ty có thể sử dụng streaming cho các sự kiện quan trọng (như cảnh báo lỗi) trong khi dựa vào micro-batch cho các chỉ số ít nhạy cảm về thời gian hơn.
Incremental so với Full Refresh
Một sự phân biệt quan trọng khác trong chiến lược ingestion là giữa tải tăng dần (incremental loading) và làm mới toàn bộ (full refresh).
Full refresh thay thế toàn bộ dữ liệu hiện có trong hệ thống đích bằng phiên bản mới nhất từ nguồn. Cách tiếp cận này đảm bảo tính đầy đủ của dữ liệu nhưng có thể tốn thời gian và tài nguyên, đặc biệt đối với các tập dữ liệu lớn. Nó thường được sử dụng khi schema cơ bản thay đổi hoặc khi khối lượng dữ liệu đủ nhỏ để tải lại hoàn toàn.
Ngược lại, incremental ingestion chỉ xử lý các bản ghi mới hoặc đã được cập nhật kể từ lần tải cuối cùng. Phương pháp này giảm đáng kể thời gian xử lý và băng thông, khiến nó lý tưởng cho các tập dữ liệu quy mô lớn hoặc thay đổi liên tục. Các công cụ ETL và framework ingestion hiện đại thường hỗ trợ tải tăng dần bằng cách sử dụng timestamp, change-data-capture (CDC), hoặc theo dõi phiên bản.
Bằng cách kết hợp logic incremental với batch hoặc streaming ingestion, các tổ chức có thể tối ưu hóa cả tốc độ lẫn hiệu quả, đảm bảo các pipeline luôn được cập nhật mà không lãng phí tài nguyên tính toán hoặc lưu trữ.
Lợi ích kinh doanh của một quy trình Data Ingestion được tinh gọn
Một quy trình data ingestion được thiết kế tốt định hình tốc độ và hiệu quả mà một tổ chức có thể hành động dựa trên dữ liệu của mình. Khi các pipeline ingestion đáng tin cậy, tự động, và có khả năng mở rộng, chúng mở ra một loạt lợi ích kinh doanh có thể đo lường được, vượt xa phạm vi của bộ phận IT.
Nâng cao khả năng dân chủ hóa dữ liệu
Data ingestion được tinh gọn phá vỡ các silo dữ liệu, giúp thông tin dễ dàng truy cập trên các bộ phận và đơn vị kinh doanh. Thay vì các đội ngũ biệt lập quản lý các tập dữ liệu riêng biệt, mọi người đều có thể lấy dữ liệu từ cùng một nguồn thống nhất, đáng tin cậy. Khả năng tiếp cận này thúc đẩy văn hóa dựa trên dữ liệu, nơi các chuyên viên phân tích, người làm marketing, và ban lãnh đạo có thể khám phá insight trực tiếp mà không cần chờ đợi sự can thiệp kỹ thuật.
Giảm chi phí vận hành và công sức thủ công
Các pipeline ingestion tự động loại bỏ việc xử lý dữ liệu thủ công lặp đi lặp lại, giải phóng các đội ngũ kỹ thuật khỏi việc viết vô số script hoặc sửa lỗi các lần truyền dữ liệu thất bại. Điều này không chỉ giảm chi phí vận hành mà còn giảm nguy cơ sai sót do con người trong các quy trình quan trọng.
Một ví dụ thực tế đến từ một công ty năng lượng toàn cầu đã hợp tác với Grant Thornton để tự động hóa việc thu nạp dữ liệu kiểm toán. Kết quả rất ấn tượng: thời gian xử lý giảm từ 24 giờ xuống chỉ còn 4 giờ mỗi quý, một sự cải thiện 83%, cho phép các đội ngũ tài chính tập trung vào phân tích thay vì chuẩn bị dữ liệu. Tự động hóa ở lớp ingestion trực tiếp chuyển hóa thành khoản tiết kiệm thời gian và chi phí có thể đo lường được.
Ra quyết định nhanh hơn và chính xác hơn
Dữ liệu mất giá trị khi nó cũ đi. Một quy trình ingestion được tinh gọn đảm bảo dữ liệu mới, đã được xác thực đến với người dùng doanh nghiệp và hệ thống AI gần như theo thời gian thực, cải thiện tốc độ và chất lượng của các insight.
Cải thiện chất lượng và độ tin cậy của dữ liệu
Một pipeline ingestion hiệu quả thực thi việc xác thực, làm sạch, và kiểm tra tính nhất quán khi dữ liệu di chuyển từ nguồn đến đích. Điều này đảm bảo thông tin nuôi dưỡng các dashboard phân tích hoặc mô hình machine learning là chính xác và đáng tin cậy.
Khả năng mở rộng và tương thích với tương lai
Một framework ingestion được tinh gọn cho phép các tổ chức mở rộng quy mô một cách suôn sẻ khi các nguồn dữ liệu tăng lên và khối lượng dữ liệu phát triển. Dù là tích hợp một nền tảng SaaS mới, tích hợp các nguồn cấp dữ liệu IoT, hay mở rộng sang các thị trường mới, một kiến trúc ingestion linh hoạt hỗ trợ sự tăng trưởng mà không làm gián đoạn các pipeline hiện có.
Khám phá các công cụ Data Ingestion
Lựa chọn đúng công cụ data ingestion là yếu tố thiết yếu để xây dựng một pipeline dữ liệu đáng tin cậy, có khả năng mở rộng, và hiệu quả. Dưới đây là các nhóm chính của công cụ ingestion và các ví dụ được sử dụng rộng rãi trong ngành.
Công cụ Data Ingestion mã nguồn mở
Các công cụ ingestion mã nguồn mở mang lại sự linh hoạt và khả năng tùy chỉnh cho các đội ngũ kỹ thuật muốn toàn quyền kiểm soát luồng dữ liệu. Chúng lý tưởng cho các tổ chức có nguồn lực kỹ thuật lành nghề và nhu cầu triển khai on-premise hoặc hybrid.
Công cụ được khuyến nghị:
Apache Kafka – Một nền tảng streaming phân tán để xử lý các nguồn cấp dữ liệu thời gian thực và pipeline dựa trên sự kiện.
Apache NiFi – Một công cụ trực quan để xây dựng luồng dữ liệu, hỗ trợ thiết kế kéo-thả và định tuyến chi tiết.
Airbyte – Một nền tảng ELT mã nguồn mở với hàng trăm connector dựng sẵn cho API, cơ sở dữ liệu, và các công cụ SaaS.
Dịch vụ Ingestion Cloud-Native và được quản lý
Các công cụ ingestion cloud-native cung cấp các dịch vụ được quản lý hoàn toàn, xử lý việc mở rộng quy mô, giám sát, và bảo trì hạ tầng. Những nền tảng này phù hợp nhất cho các tổ chức hoạt động trong các hệ sinh thái đám mây như AWS, Azure, hoặc Google Cloud.
Công cụ được khuyến nghị:
AWS Kinesis – Quản lý streaming thời gian thực quy mô lớn cho các ứng dụng như phân tích clickstream và telemetry IoT.
Azure Data Factory – Một dịch vụ tích hợp dữ liệu serverless cho batch và streaming ingestion với quy trình làm việc kéo-thả.
Google Cloud Dataflow – Cung cấp xử lý batch và stream thống nhất được xây dựng trên Apache Beam, tích hợp liền mạch với BigQuery.
Nền tảng tích hợp ETL và ELT
Các nền tảng ETL (Extract, Transform, Load) và ELT (Extract, Load, Transform) bao gồm cả ingestion như một phần của việc tích hợp dữ liệu rộng hơn. Chúng giúp tự động hóa việc thu thập dữ liệu từ nhiều nguồn khác nhau, áp dụng các bước chuyển đổi và đưa dữ liệu vào các môi trường sẵn sàng cho phân tích.
Công cụ được khuyến nghị:
Fivetran – Cung cấp data ingestion tự động, tăng dần từ các ứng dụng SaaS và cơ sở dữ liệu vào các data warehouse trên đám mây.
Matillion – Tập trung vào ETL cloud-native và các phép chuyển đổi trong warehouse cho Snowflake, BigQuery, và Redshift.
Talend Data Integration – Cung cấp khả năng quản trị cấp doanh nghiệp và ingestion thời gian thực với các công cụ chất lượng dữ liệu tích hợp sẵn.
Nền tảng Streaming thời gian thực và dựa trên sự kiện
Các nền tảng streaming ingestion cho phép di chuyển dữ liệu liên tục và phân tích với độ trễ thấp. Chúng được xây dựng cho các ứng dụng đòi hỏi khả năng hiển thị và phản hồi tức thì, chẳng hạn như phát hiện gian lận, giám sát IoT, hoặc dashboard trực tiếp.
Công cụ được khuyến nghị:
Confluent Platform – Một bản phân phối Kafka cấp doanh nghiệp cung cấp các cụm được quản lý, connector, và schema registry.
Redpanda – Một engine streaming hiệu năng cao, tương thích với Kafka, được tối ưu hóa cho độ trễ thấp và hiệu quả.
Striim – Nền tảng tích hợp dữ liệu thời gian thực và streaming sự kiện hỗ trợ các môi trường đám mây lai.
Tìm hiểu GreenNode vDB Kafka
Công cụ điều phối và quản lý quy trình làm việc
Các công cụ điều phối phối hợp các công việc ingestion, quản lý sự phụ thuộc, và tự động thử lại khi có sự cố. Chúng đảm bảo các pipeline dữ liệu chạy đáng tin cậy và đúng lịch trình.
Công cụ được khuyến nghị:
Apache Airflow – Công cụ lên lịch quy trình làm việc tiêu chuẩn ngành cho các pipeline dữ liệu, được xây dựng trên Directed Acyclic Graphs (DAGs).
Prefect – Một công cụ điều phối hiện đại kết hợp sự đơn giản với khả năng quan sát và thực thi lai.
Dagster – Một framework điều phối được thiết kế cho các tài sản dữ liệu, nhấn mạnh tính mô-đun và khả năng kiểm thử.
Cách chọn công cụ và chiến lược Data Ingestion phù hợp
Việc lựa chọn đúng chiến lược và công cụ data ingestion là yếu tố then chốt để xây dựng một hệ sinh thái phân tích hoặc AI nhanh, có khả năng mở rộng, và đáng tin cậy. Quy trình này bao gồm việc hiểu dữ liệu của bạn, thiết lập kỳ vọng về hiệu suất, cân bằng chi phí, và đảm bảo quản trị. Dưới đây là hướng dẫn từng bước giúp bạn đánh giá các lựa chọn của mình một cách hiệu quả.
Xác định trường hợp sử dụng kinh doanh và đặc điểm dữ liệu: Bắt đầu bằng cách xác định vấn đề mà pipeline dữ liệu của bạn cần giải quyết. Hiểu rõ loại, khối lượng, và tần suất dữ liệu mà tổ chức của bạn tạo ra.
Đánh giá yêu cầu về thông lượng, độ trễ và quy mô: Phương pháp ingestion phù hợp phụ thuộc vào lượng dữ liệu bạn cần di chuyển và tốc độ bạn cần nó sẵn sàng.
Cân nhắc chi phí và giới hạn hạ tầng: Hiệu quả chi phí thường phụ thuộc vào cách ingestion được quản lý và nơi nó được lưu trữ.
Đánh giá quản trị, bảo mật, tuân thủ và chất lượng dữ liệu: Một pipeline ingestion được tinh gọn phải duy trì bảo mật và tuân thủ trong khi vẫn đảm bảo dữ liệu luôn sạch và đáng tin cậy.
Việc lựa chọn chiến lược ingestion phù hợp phụ thuộc vào việc gắn kết công nghệ với mục tiêu kinh doanh. Các hệ thống batch mang lại sự đơn giản và tiết kiệm chi phí; streaming cho phép sự tức thời và linh hoạt; các phương pháp hybrid cân bằng cả hai. Bằng cách cân nhắc trường hợp sử dụng, mục tiêu hiệu suất, giới hạn hạ tầng, và nhu cầu tuân thủ, bạn có thể thiết kế một pipeline không chỉ giúp dữ liệu dễ tiếp cận mà còn đáng tin cậy.
Các thách thức phổ biến của Data Ingestion và cách khắc phục
Ngay cả với những công cụ và chiến lược tốt nhất, việc xây dựng một pipeline data ingestion vẫn không thiếu thách thức. Khi khối lượng dữ liệu, định dạng, và nhu cầu kinh doanh phát triển, các tổ chức phải dự đoán trước các nút thắt cổ chai về kỹ thuật và vận hành. Dưới đây là một số thách thức phổ biến nhất của data ingestion và cách giải quyết thực tế.
Silo dữ liệu, sự trôi dạt schema và sự đa dạng định dạng: Một trong những rào cản lớn nhất trong data ingestion là xử lý các nguồn dữ liệu phân mảnh, lưu trữ thông tin ở các định dạng và cấu trúc khác nhau. Silo dữ liệu khiến việc duy trì tính nhất quán trở nên khó khăn, trong khi schema drift, khi cấu trúc dữ liệu thay đổi mà không có thông báo, có thể làm hỏng pipeline hoặc gây ra lỗi.
- Áp dụng một schema registry (ví dụ: Confluent Schema Registry) để theo dõi các phiên bản dữ liệu và tự động xử lý các thay đổi cấu trúc.
- Sử dụng các định dạng dữ liệu tiêu chuẩn như Parquet, Avro, hoặc JSON để tăng khả năng tương tác giữa các hệ thống.
- Khuyến khích sự hợp tác liên phòng ban để ngăn chặn các hệ thống biệt lập và đảm bảo các nguồn dữ liệu mới tuân theo các tiêu chuẩn ingestion đã được xác định.
Sự đánh đổi giữa độ trễ và chi phí: Data ingestion nhanh hơn thường đi kèm với chi phí cao hơn. Các hệ thống streaming thời gian thực đòi hỏi tài nguyên tính toán liên tục, trong khi batch ingestion có thể tiết kiệm chi phí hơn nhưng tạo ra độ trễ. Tìm ra sự cân bằng phù hợp giữa hiệu suất và ngân sách là điều then chốt.
- Xác định các SLA rõ ràng về độ mới của dữ liệu vì không phải mọi trường hợp sử dụng đều cần dữ liệu thời gian thực.
- Sử dụng cách tiếp cận hybrid hoặc micro-batch để đạt được hiệu suất gần thời gian thực mà không phải chịu chi phí tính toán liên tục.
- Tối ưu hóa việc định tuyến dữ liệu bằng cách lọc sự kiện hoặc message queue để giảm lưu lượng không cần thiết.
- Giám sát mức sử dụng và mở rộng tài nguyên linh hoạt với các tính năng đám mây.
Giám sát, khả năng quan sát và sự cố trong ingestion: Các pipeline dữ liệu dễ gặp phải những lỗi âm thầm: tải không đầy đủ, bản ghi trùng lặp, hoặc mất tin nhắn. Nếu không có khả năng quan sát mạnh mẽ, những vấn đề này có thể không được chú ý cho đến khi chúng ảnh hưởng đến kết quả phân tích hoặc AI.
- Triển khai các dashboard giám sát pipeline tập trung bằng các công cụ như Apache Airflow, Prefect, hoặc Datadog.
- Ghi log và theo dõi các chỉ số ingestion như thông lượng, độ trễ, và tỷ lệ lỗi theo thời gian thực.
- Thiết lập cảnh báo tự động và cơ chế thử lại để xử lý các sự cố tạm thời một cách suôn sẻ.
- Thường xuyên xác thực dữ liệu đã thu nạp so với số liệu nguồn để phát hiện sớm việc mất hoặc trùng lặp dữ liệu.
Khả năng mở rộng và các nguồn dữ liệu thay đổi: Khi các tổ chức phát triển, các nguồn dữ liệu, API, và hệ thống kinh doanh mới liên tục được bổ sung. Các pipeline ingestion tĩnh không thể dễ dàng thích ứng với sự tăng trưởng này.
- Thiết kế ingestion theo hướng mô-đun; mỗi nguồn nên hoạt động độc lập với các connector hoặc template có thể tái sử dụng.
- Sử dụng các kiến trúc cloud-native và có tính đàn hồi để tự động mở rộng quy mô khi khối lượng dữ liệu tăng lên.
- Sử dụng các framework mở như Apache Beam hoặc điều phối dựa trên Kubernetes để hỗ trợ nhiều môi trường và các tích hợp trong tương lai.
- Thực hiện đánh giá ingestion hàng quý để xem xét liệu các công cụ, định dạng, và API có còn phù hợp với nhu cầu kinh doanh hay không.
Câu hỏi thường gặp về Data Ingestion
1. Data ingestion khác với ETL hoặc ELT như thế nào?
Data ingestion tập trung vào việc di chuyển dữ liệu hiệu quả từ nơi này sang nơi khác, trong khi ETL (Extract, Transform, Load) và ELT (Extract, Load, Transform) bổ sung thêm các bước chuyển đổi và làm sạch.
Nói cách khác, data ingestion là việc đưa dữ liệu vào, còn ETL/ELT là việc làm cho nó có thể sử dụng được. Trong các pipeline dữ liệu hiện đại, ingestion thường hoạt động song song với các công cụ ETL để tự động hóa toàn bộ luồng.
2. Các loại data ingestion chính là gì?
Có ba loại data ingestion chính:
- Batch ingestion – Truyền dữ liệu tại các khoảng thời gian cố định (ví dụ: hàng giờ, hàng ngày).
- Streaming ingestion – Di chuyển dữ liệu liên tục theo thời gian thực khi sự kiện xảy ra.
- Hybrid hoặc micro-batch ingestion – Kết hợp cả hai, gửi các lô nhỏ thường xuyên để có insight gần như theo thời gian thực.
Việc lựa chọn loại phù hợp phụ thuộc vào mức độ mới của dữ liệu bạn cần và khối lượng bạn xử lý.
3. Các công ty có thể đảm bảo chất lượng dữ liệu trong quá trình ingestion như thế nào?
Chất lượng dữ liệu bắt đầu từ lớp ingestion. Các tổ chức nên:
- Xác thực kiểu và định dạng dữ liệu trong quá trình ingestion.
- Loại bỏ trùng lặp và lọc các bản ghi không hợp lệ hoặc bị lỗi.
- Theo dõi nguồn gốc dữ liệu (data lineage) để truy vết lỗi về nguồn gốc.
- Sử dụng các công cụ kiểm tra chất lượng tích hợp sẵn từ các công cụ như Informatica, Databricks Auto Loader, hoặc Talend để phát hiện sớm sự không nhất quán.
