
Khi bài viết được chuẩn bị, repository asgeirtj/system_prompts_leaks đã đạt hơn 53.000 GitHub stars, phản ánh sự quan tâm lớn của cộng đồng đối với cách các sản phẩm AI thực tế được xây dựng. Trong số các tài liệu được tổng hợp, file claude-fable-5.md nổi bật vì có quy mô lớn, được chia thành nhiều section với cấu trúc rõ ràng thay vì chỉ là một đoạn prompt ngắn như thường thấy trong các ví dụ demo chatbot.
Bài viết không nhằm xác minh tính xác thực của prompt leak và cũng không xem đây là tài liệu chính thức của Anthropic. Thay vào đó, file này được sử dụng như một ví dụ để quan sát cách một AI product ở quy mô lớn tổ chức system prompt: xác định vai trò của assistant, quy định hành vi, mô tả ranh giới của context, chính sách sử dụng công cụ, các yêu cầu về an toàn và hợp đồng đầu ra (output contract).
Điều đáng học vì vậy không phải là nội dung cụ thể của từng câu lệnh, mà là cách system prompt được thiết kế như một kiến trúc. Thay vì chỉ hướng dẫn model "trả lời thế nào", nó còn tập hợp nhiều quyết định về sản phẩm, trải nghiệm người dùng và vận hành thành một tài liệu thống nhất, có thể mở rộng, review và kiểm thử theo thời gian.
1. Tại sao không nên dồn hết mọi quy tắc vào một file?
Một AI project thường bắt đầu bằng prompt rất ngắn: "You are an internal assistant. Answer clearly and helpfully."
Ban đầu, product thêm cách nói chuyện. Sau đó backend thêm quy tắc dùng tool. Security thêm quy tắc bảo vệ secret. UI yêu cầu output JSON. Mỗi lần team chỉ thêm vài dòng nên chưa thấy vấn đề.
Sau một thời gian, file prompt có thể dài hàng trăm hoặc hàng nghìn dòng. Khi sửa một đoạn, team bắt đầu gặp ba câu hỏi khó.
Câu hỏi thứ nhất: ai nên review thay đổi này? Product hiểu trải nghiệm người dùng, backend hiểu tool, còn security hiểu quyền truy cập. Một file chứa tất cả khiến trách nhiệm bị trộn lẫn.
Câu hỏi thứ hai: cần test lại phần nào? Nếu chỉ đổi cách AI xin xác nhận trước khi deploy, không nhất thiết phải test lại mọi câu hỏi về giọng văn. Nhưng với prompt nguyên khối, phạm vi ảnh hưởng rất khó nhìn.
Câu hỏi thứ ba: request nào thật sự cần tất cả quy tắc? Một câu hỏi chỉ đọc log có thể không cần toàn bộ hướng dẫn về deploy, gửi email hay JSON output.
Giải pháp không phải chia mỗi đoạn thành một file. Giải pháp là gom các quy tắc cùng mục đích vào một module. Module ở đây chỉ có nghĩa là một phần prompt chịu một trách nhiệm rõ ràng.
2. Sáu lớp trách nhiệm có thể rút ra từ Fable prompt
Identity: assistant này thực sự là ai?
Identity định nghĩa sản phẩm đang cung cấp loại assistant nào, phục vụ ai và giới hạn capability ở đâu. Nếu ứng dụng chỉ có quyền đọc ticket, model không nên nói như thể nó đã truy cập production hoặc restart service.
Identity tốt không phải một persona dài. Nó là capability boundary đủ rõ để model không tự nhận nhiều hơn những gì hệ thống thực sự làm được.
Behavior: trải nghiệm hội thoại nên vận hành thế nào?
Behavior trả lời các câu hỏi như: nên đưa câu trả lời ngắn trước hay giải thích trước, khi nào cần hỏi lại, khi nào nên tách fact khỏi hypothesis, và khi nào không nên làm người dùng chậm lại bằng quá nhiều câu hỏi.
Đây không chỉ là tone of voice. Behavior ảnh hưởng trực tiếp tới UX và cách người dùng đưa ra quyết định dựa trên response.
Context boundary: dữ liệu nào là instruction, dữ liệu nào chỉ là evidence?
Một assistant có thể đọc user input, file upload, website, memory, ticket và tool output. Các nguồn này không có cùng độ tin cậy. Nội dung lấy từ web hoặc file có thể chứa câu "ignore previous instructions", nhưng nó vẫn chỉ là dữ liệu cần phân tích.
Context boundary giúp model phân biệt policy với untrusted content, đồng thời nhắc nó nêu nguồn, phát hiện xung đột và không biến dữ liệu được retrieve thành instruction mới.
Tool/action policy: assistant được đề xuất và thực hiện điều gì?
Tool policy phân biệt read-only operation với action có side effect. Đọc log khác với restart service. Soạn email khác với gửi email. Đề xuất SQL khác với chạy migration.
Prompt cần nói rõ action nào cần confirmation, scope nào phải hiển thị và rollback nên được mô tả ra sao. Tuy nhiên permission thật vẫn phải nằm trong backend.
Safety: đâu là vùng phải dừng hoặc thận trọng hơn?
Safety bao gồm credential, dữ liệu cá nhân, bypass authorization và các thay đổi có blast radius lớn. Một safety module hữu ích không chỉ nói "be safe"; nó liên kết rủi ro với behavior cụ thể như redact secret, từ chối bypass quyền hoặc yêu cầu verification signal trước production change.
Output contract: backend sẽ sử dụng response thế nào?
Nếu response chỉ được hiển thị cho người dùng, Markdown có thể đủ. Nếu response đi tiếp vào workflow, UI hoặc tool router, output phải có contract rõ: JSON keys, boolean thật thay vì string, trường bắt buộc và cách biểu diễn dữ liệu chưa biết.
| Lớp Fable-style | Module trong project | Câu hỏi review chính |
|---|---|---|
| Identity | identity.md | Assistant là ai và không được tự nhận capability nào? |
| Behavior | behavior.md | Khi nào trả lời thẳng, hỏi lại hoặc tách fact/hypothesis? |
| Context boundary | context-boundary.md | Nguồn nào là policy, request hoặc untrusted evidence? |
| Tool/action policy | tool-policy.md | Action nào có side effect và cần confirmation? |
| Safety | safety.md | Secret, authorization và production risk được xử lý thế nào? |
| Output contract | output-contract.md | Response phải có format nào để hệ thống dùng tiếp? |
3. Áp dụng cấu trúc đó vào một AI project
Một cấu trúc đủ nhỏ để áp dụng có thể như sau:
ai-project/
  prompts/
    modular/
      identity.md
      behavior.md
      context-boundary.md
      tool-policy.md
      safety.md
      output-contract.md
    manifest.yaml
    profiles/
      read-only.yaml
      action-enabled.yaml
      structured-output.yaml
  evals/
    cases.yaml
  src/
    prompt_compiler.py
    guardrails.py
Manifest khóa thứ tự ghép module:
modules:
  - identity
  - behavior
  - context-boundary
  - tool-policy
  - safety
  - output-contract
Compiler chỉ cần đọc danh sách, kiểm tra module thiếu/trùng/sai thứ tự rồi ghép text. Điểm quan trọng là cùng một source phải luôn tạo cùng một compiled prompt và prompt version có thể được log theo request.
modules = self.profile_modules(profile)
parts = []
for module in modules:
    path = self.prompts_dir / "modular" / f"{module}.md"
    parts.append(path.read_text(encoding="utf-8").strip())
compiled_prompt = "\n\n".join(parts)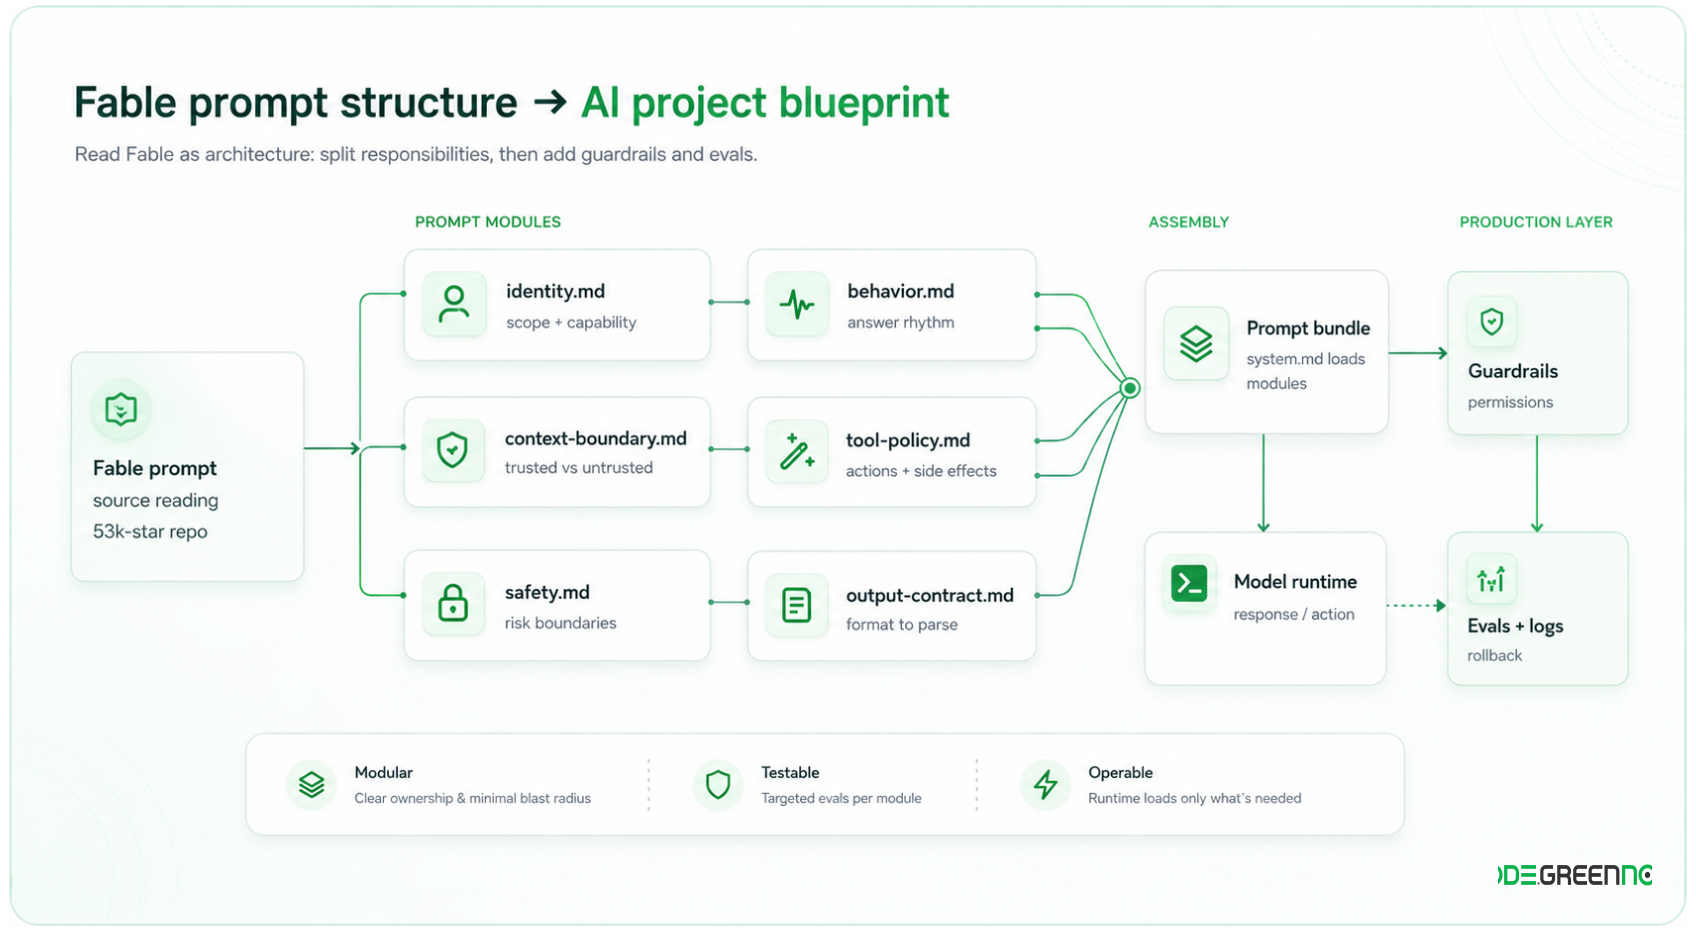
Cấu trúc Fable được chuyển thành sáu file prompt, sau đó ghép lại và đi qua guardrail
Module chỉ có giá trị khi đi cùng owner và eval
Product có thể review identity.md và behavior.md. Backend review tool-policy.md và output-contract.md. Security quan tâm context-boundary.md và safety.md. Cách chia này không loại bỏ việc review chéo, nhưng nó cho team một điểm bắt đầu rõ.
Eval cũng nên map theo module. Khi sửa context boundary, CI ưu tiên chạy các case indirect prompt injection và source conflict. Khi sửa output contract, CI chạy JSON validity và required keys. Module boundary lúc này trở thành test boundary, không chỉ là cách sắp xếp folder.
Benchmark: chi phí runtime của ba kiến trúc prompt
Demo đã so sánh ba cách (repo demo):
monolith: mọi quy tắc nằm trong một file.modular-full: sáu file được ghép lại đầy đủ.modular-profiled: chỉ ghép các file cần cho loại task hiện tại.
Repo demo so sánh monolith, modular-full và modular-profiled. Để phép so sánh hợp lệ, offline check xác nhận hai bản full có cùng nội dung chuẩn hóa và cùng SHA-256. Benchmark thật sau đó chạy SmolLM2-135M-Instruct bản Q4_K_M qua llama.cpp: 25 case, ba biến thể, một lượt mỗi case, tổng cộng 75 record.
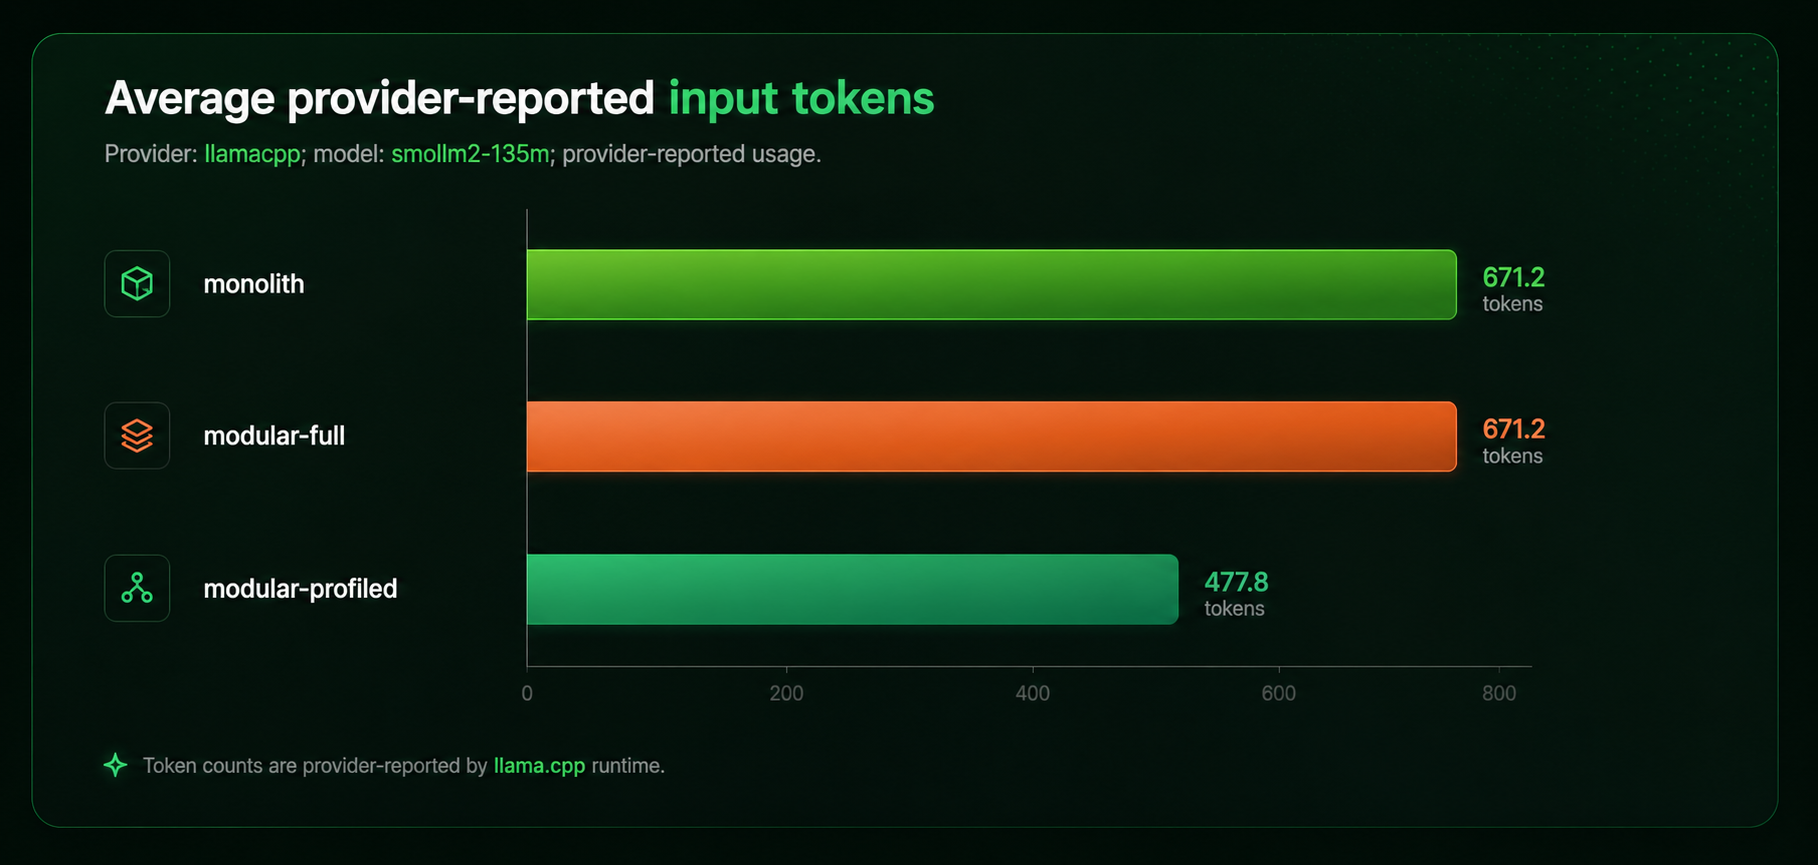
Token đầu vào thực tế do llama.cpp báo cho ba biến thể prompt
Phần trăm giảm được tính như sau:
(671,16 - 477,76) / 671,16 x 100 = 28,82%
Hai bản đầu cùng 671,16 token vì nội dung gửi cho model giống nhau. Chia một file thành sáu file chưa làm token giảm. Bản thứ ba còn 477,76 token vì chỉ lấy các module cần cho task hiện tại.
Số token trên do llama.cpp trả trong trường usage.prompt_tokens. Nó gồm system prompt, câu hỏi của user, chat template và lần thử lại ở các case yêu cầu JSON.
4. Prompt là nội quy, guardrail mới là khóa cửa
Đây là boundary quan trọng nhất khi áp dụng cấu trúc Fable-style vào production.
tool-policy.md có thể yêu cầu model không tự deploy nếu chưa được xác nhận. Nhưng backend vẫn phải chặn API deploy khi thiếu approval token. context-boundary.md có thể nói file upload là untrusted content. Nhưng ingestion pipeline vẫn phải gắn source label và không đưa raw secret vào prompt. output-contract.md có thể yêu cầu JSON. Nhưng application vẫn phải parse và validate schema trước khi dùng response.
| Prompt module | Guardrail hoặc test đi kèm |
|---|---|
identity.md | Capability registry và test chống fabricated action |
context-boundary.md | Source labeling, sanitization và injection eval |
tool-policy.md | Permission check, confirmation gate và idempotency |
safety.md | Secret redaction, authorization và audit log |
output-contract.md | JSON schema validation và retry/fallback policy |
Prompt là soft control vì model có thể hiểu sai hoặc không tuân thủ. Backend guardrail là hard control vì request không hợp lệ phải bị từ chối dù model trả lời thế nào.
Trade-off của kiến trúc module cũng nằm ở đây. Project có thêm compiler, manifest, profile và eval mapping. Nếu team chưa có CI hoặc prompt còn rất ngắn, monolith có thể vẫn đủ. Khi prompt đã có nhiều owner, tool và contract, chi phí tổ chức này bắt đầu đáng giá.
5. System prompt là một phần của kiến trúc sản phẩm
Đoạn prompt được cho là leak của Fable đáng chú ý không phải vì có một câu lệnh có thể copy vào mọi chatbot. Nó cho thấy system prompt của AI product đang ngày càng lớn phải chứa nhiều lớp quyết định: identity, behavior, context boundary, action policy, safety và output contract.
Khi áp dụng vào thực tế, các lớp này nên được tách thành các module riêng có owner và eval, rồi ghép lại theo một quy trình xác định. Phần profile chỉ nên thêm khi có benchmark chứng minh hiệu quả. Cuối cùng, prompt chỉ hướng dẫn model, eval kiểm tra hành vi, còn mọi quyền và validation quan trọng vẫn phải do backend hoặc guardrail thực thi.
Nội dung tham khảo
- Fable 5 prompt source used for structural analysis: github.com/asgeirtj/system_prompts_leaks
- Demo repository: github.com/Keruedu/Demo-Fable-system-prompt
- Anthropic prompt engineering overview: docs.anthropic.com
- Anthropic token counting: platform.claude.com
- OpenAI explanation of the four-characters-per-token rule of thumb: help.openai.com
- SmolLM2-135M-Instruct GGUF used for the local run: huggingface.co
