
Việc lựa chọn giữa transfer learning và fine-tuning là một bước quan trọng trong việc xây dựng các quy trình machine learning và mô hình ngôn ngữ lớn (LLM) ngày nay. Khi các mô hình đã được huấn luyện sẵn trở thành nền tảng cho mọi thứ, từ thị giác máy tính đến các trợ lý AI cấp doanh nghiệp, các đội ngũ phải quyết định nên tái sử dụng những mô hình này nguyên trạng hay đầu tư điều chỉnh chúng sâu hơn để phù hợp với lĩnh vực của mình.
Sự khác biệt này không chỉ mang tính học thuật: nó ảnh hưởng đến thời gian huấn luyện, mức tiêu thụ GPU, độ chính xác của mô hình, và cuối cùng là hiệu suất hoạt động của giải pháp trong môi trường thực tế. Bài viết này sẽ phân tích sự khác biệt giữa transfer learning và fine-tuning, giúp bạn lựa chọn hướng đi phù hợp để tối ưu cả nguồn lực lẫn kết quả trong các dự án machine learning của mình.
Transfer Learning là gì?
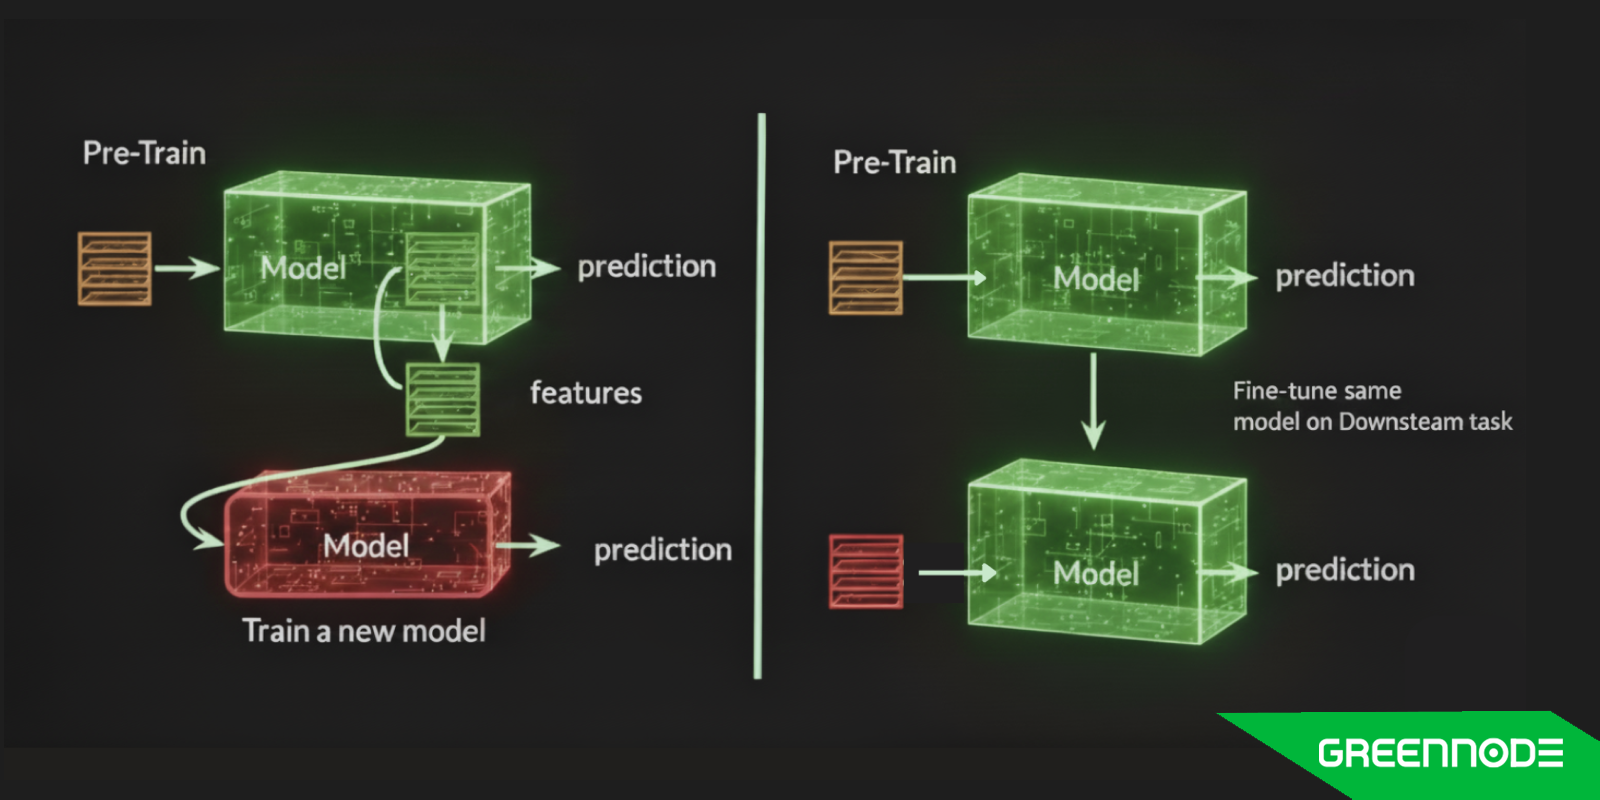
Transfer learning là một kỹ thuật trong machine learning, trong đó một mô hình đã được huấn luyện cho một tác vụ được tái sử dụng làm điểm khởi đầu cho một tác vụ khác, thường có liên quan. Thay vì xây dựng mô hình từ đầu, bạn tận dụng kiến thức đã được tích lũy trong một mô hình lớn, đã được huấn luyện sẵn, chẳng hạn như mô hình được huấn luyện trên ImageNet cho thị giác máy tính hoặc BERT cho ngôn ngữ tự nhiên. Bằng cách giữ nguyên phần lớn các tham số gốc và chỉ điều chỉnh các lớp cuối cùng, transfer learning giúp đạt được kết quả tốt với ít dữ liệu hơn, thời gian huấn luyện ngắn hơn và chi phí tính toán thấp hơn.
Ý tưởng cốt lõi ở đây là hiệu quả: thay vì học lại các đặc trưng tổng quát (đường viền trong hình ảnh, cấu trúc câu trong văn bản), bạn chỉ tập trung vào những phần đặc thù cho vấn đề của mình. Ví dụ, trong thị giác máy tính, các lớp đầu của một mô hình đã huấn luyện sẵn nắm bắt các mẫu hình phổ quát như hình dạng hoặc kết cấu, trong khi chỉ các lớp cuối mới cần điều chỉnh để phân loại hình ảnh y tế hoặc phát hiện lỗi trong sản xuất.
Cách tiếp cận này đặc biệt có giá trị khi dữ liệu bị hạn chế hoặc nguồn lực có giới hạn, khiến nó trở thành phương pháp được sử dụng rộng rãi trong nhiều lĩnh vực như NLP, nhận diện hình ảnh và xử lý giọng nói.
Dưới đây là một ví dụ cấu trúc mã trong PyTorch để tinh chỉnh (fine-tuning), được xây dựng dựa trên ví dụ trích xuất đặc trưng trước đó:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import models
# 1. Load a pre-trained model (e.g., ResNet-18)
# We set 'weights' to load the pre-trained weights from ImageNet
model_ft = models.resnet18(weights='IMAGENET1K_V1')
# 2. Freeze all the parameters (feature extraction layers)
# We iterate over the parameters and set requires_grad to False
for param in model_ft.parameters():
    param.requires_grad = False
# 3. Modify the final fully-connected (FC) layer
# ResNet-18's FC layer input features
num_ftrs = model_ft.fc.in_features
# Replace the FC layer with a new one for your specific number of classes (e.g., 2)
num_classes = 2 # Example: Ants and Bees
model_ft.fc = nn.Linear(num_ftrs, num_classes)
# 4. Define Loss Function and Optimizer
# Only the parameters of the new FC layer have requires_grad=True, so only they will be optimized.
criterion = nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(model_ft.fc.parameters(), lr=0.001, momentum=0.9)
# 5. Training Loop (Simplified - you would replace this with your full training logic)
# (Your dataset and dataloaders would be defined here)
# for epoch in range(num_epochs):
#     for inputs, labels in dataloaders['train']:
#         # ... training steps ...
#         optimizer_ft.zero_grad()
#         outputs = model_ft(inputs)
#         loss = criterion(outputs, labels)
#         loss.backward()
#         optimizer_ft.step()
Fine-Tuning là gì?
Fine-tuning là quá trình lấy một mô hình đã được huấn luyện sẵn và cập nhật các tham số của nó trên một tập dữ liệu mới để mô hình có thể hoạt động tốt cho một tác vụ cụ thể. Khác với transfer learning, nơi phần lớn trọng số của mô hình gốc được giữ cố định, fine-tuning cho phép một số hoặc toàn bộ các lớp tiếp tục học trong quá trình huấn luyện. Điều này giúp mô hình có khả năng thích ứng cao hơn, đặc biệt khi tác vụ mục tiêu khác với tác vụ mà mô hình ban đầu được huấn luyện.
Về bản chất, fine-tuning tạo ra sự cân bằng: nó tận dụng kiến thức tổng quát đã được tích lũy trong một mô hình lớn đã huấn luyện sẵn, đồng thời điều chỉnh để phù hợp với những sắc thái riêng của một lĩnh vực mới. Ví dụ, một mô hình ngôn ngữ như BERT có thể được tinh chỉnh cho phân tích cảm xúc, trả lời câu hỏi hoặc phân loại văn bản y tế. Tương tự, một mô hình hình ảnh được huấn luyện trên ImageNet có thể được tinh chỉnh để phát hiện bệnh trong ảnh X-quang hoặc phân loại lỗi trong sản phẩm công nghiệp.
Fine-tuning có thể được thực hiện theo nhiều cách khác nhau:
- Fine-tuning toàn bộ (Full fine-tuning): tất cả các lớp đều được cập nhật, thường với tốc độ học (learning rate) thấp hơn để tránh phá vỡ các đặc trưng hữu ích đã học được từ trước.
- Fine-tuning một phần (Partial fine-tuning): chỉ các lớp sau được mở khóa (unfreeze), trong khi các lớp đầu vẫn được giữ cố định.
- Fine-tuning tiết kiệm tham số (Parameter-efficient fine-tuning - PEFT): các kỹ thuật như LoRA hoặc adapter layer chỉ cập nhật một tập con nhỏ các tham số, giúp giảm chi phí tính toán và bộ nhớ.
Vì điều chỉnh mô hình sâu hơn, fine-tuning thường đòi hỏi nhiều tính toán và tập dữ liệu lớn hơn so với transfer learning. Nhưng khi được áp dụng đúng cách, nó có thể mang lại độ chính xác cao hơn và hiệu suất chuyên biệt theo lĩnh vực.
Dưới đây là một ví dụ cấu trúc mã trong PyTorch để tinh chỉnh (fine-tuning), được xây dựng dựa trên ví dụ trích xuất đặc trưng trước đó:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import models
# 1. Load a pre-trained model (e.g., ResNet-18)
model_ft = models.resnet18(weights='IMAGENET1K_V1')
# 2. Modify the final fully-connected (FC) layer
num_ftrs = model_ft.fc.in_features
num_classes = 2 # Example: Ants and Bees
model_ft.fc = nn.Linear(num_ftrs, num_classes)
# 3. Fine-Tuning - Unfreeze some or all layers
# In fine-tuning, you typically start by training the whole model,
# or unfreezing specific late layers for a small learning rate.
# Option A: Unfreeze ALL parameters for training (Full fine-tuning)
# Since we didn't freeze them in step 1, they are already trainable by default.
# We can skip the 'for param in model_ft.parameters(): param.requires_grad = True' part.
# Option B: Selective unfreezing (e.g., unfreeze the last block)
# To demonstrate selective unfreezing, let's assume we froze everything previously (for clarity, uncomment below):
# for param in model_ft.parameters():
#     param.requires_grad = False
#
# # Now, unfreeze the last convolutional block (layer4) and the new FC layer
# for param in model_ft.layer4.parameters():
#     param.requires_grad = True
#
# for param in model_ft.fc.parameters():
#     param.requires_grad = True
# 4. Define Loss Function and Optimizer
# Crucially, we now pass *all* the parameters we want to train to the optimizer.
# We often use different learning rates for the unfreeze layers vs the new layer.
# Get all trainable parameters (layer4 and fc in Option B)
params_to_update = []
for name, param in model_ft.named_parameters():
    if param.requires_grad == True:
        params_to_update.append(param)

# Set a smaller learning rate (e.g., 0.0001) for the entire model or for the base layers
# and a slightly larger one for the new FC layer if you're using parameter groups.
# Simple Fine-tuning (one learning rate for all trainable params):
criterion = nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(params_to_update, lr=0.0001, momentum=0.9) # Note the very small LR (0.0001)
# Advanced Fine-tuning (different learning rates for different groups):
# optimizer_ft = optim.SGD([
#     {'params': model_ft.layer4.parameters(), 'lr': 0.00001},  # Very low LR for deeper layers
#     {'params': model_ft.fc.parameters(), 'lr': 0.001}        # Higher LR for the new layer
# ], momentum=0.9)
# 5. Training Loop (Simplified)
# (Your dataset and dataloaders would be defined here)
# The training loop is the same, but more parameters are updated.
# for epoch in range(num_epochs):
#     for inputs, labels in dataloaders['train']:
#         # ... training steps ...
#         optimizer_ft.zero_grad()
#         outputs = model_ft(inputs)
#         loss = criterion(outputs, labels)
#         loss.backward()
#         optimizer_ft.step()
Sự khác biệt chính giữa Fine-Tuning và Transfer Learning
Việc lựa chọn giữa transfer learning và fine-tuning thường phụ thuộc vào những đánh đổi thực tế. Cả hai phương pháp đều dựa trên các mô hình đã huấn luyện sẵn, nhưng khác nhau về mức độ mô hình được huấn luyện lại, lượng dữ liệu cần thiết, và sự cân bằng giữa hiệu quả và độ chính xác. Bảng dưới đây làm nổi bật những khác biệt chính trên các khía cạnh quan trọng nhất.
| Khía cạnh | Transfer Learning | Fine-tuning |
| Phạm vi huấn luyện và việc đóng băng lớp (layer freezing) | Phần lớn các lớp được giữ cố định; thường chỉ có lớp phân loại cuối cùng được huấn luyện. | Một số hoặc toàn bộ các lớp được mở khóa và cập nhật trong quá trình huấn luyện. |
| Yêu cầu dữ liệu và sự dịch chuyển lĩnh vực (domain shift) | Hoạt động tốt với tập dữ liệu nhỏ khi tác vụ mới tương đồng với lĩnh vực huấn luyện gốc. | Đòi hỏi nhiều dữ liệu hơn, đặc biệt nếu tác vụ mới khác biệt lớn so với lĩnh vực gốc. |
| Chi phí tính toán và khả năng mở rộng | Chi phí tính toán thấp và huấn luyện nhanh hơn, do ít tham số được cập nhật hơn. | Chi phí tính toán cao hơn và thời gian huấn luyện dài hơn, do nhiều tham số được tối ưu hơn. |
| Đánh đổi hiệu suất và nguy cơ overfitting | Ổn định hơn và ít dễ overfitting hơn, nhưng có thể hoạt động kém nếu lĩnh vực mục tiêu khác biệt quá lớn. | Có thể đạt độ chính xác cao hơn và hiệu suất chuyên biệt theo lĩnh vực, nhưng có nguy cơ overfitting cao hơn nếu dữ liệu bị hạn chế. |
Nói ngắn gọn, transfer learning là lựa chọn hàng đầu khi bạn cần tốc độ, hiệu quả và hiệu suất ổn định với dữ liệu hạn chế, trong khi fine-tuning là lựa chọn tốt hơn khi độ chính xác và khả năng thích ứng theo lĩnh vực là yếu tố then chốt. Hiểu rõ những khác biệt này giúp các đội ngũ đưa ra quyết định sáng suốt về phương pháp phù hợp nhất với dữ liệu, nguồn lực và mục tiêu dự án của mình.
Khi nào nên dùng Transfer Learning và khi nào nên dùng Fine-Tuning
Việc lựa chọn giữa transfer learning và fine-tuning phụ thuộc vào kích thước tập dữ liệu, nguồn lực bạn có, và mức độ đặc thù của tác vụ. Transfer learning hoạt động tốt nhất khi bạn cần một giải pháp nhanh chóng và hiệu quả, trong khi fine-tuning là lựa chọn tốt hơn khi độ chính xác và khả năng thích ứng theo lĩnh vực là quan trọng nhất. Trong một số trường hợp, sự kết hợp cả hai có thể mang lại sự cân bằng phù hợp. Hướng dẫn dưới đây sẽ phân tích khi nào mỗi lựa chọn là hợp lý nhất.
Khi nào nên dùng Transfer Learning
- Tập dữ liệu nhỏ: Lý tưởng khi dữ liệu đã gán nhãn bị hạn chế (ví dụ: hình ảnh y tế, phân loại văn bản chuyên biệt).
- Hạn chế về nguồn lực: Phù hợp khi ngân sách huấn luyện hoặc tài nguyên GPU eo hẹp.
- Lĩnh vực tương đồng: Hoạt động tốt nếu tác vụ mục tiêu gần với lĩnh vực huấn luyện gốc (ví dụ: sử dụng đặc trưng từ ImageNet cho các hình ảnh tự nhiên khác).
- Xây dựng nguyên mẫu nhanh: Hữu ích cho các bằng chứng khái niệm (proof-of-concept) hoặc mô hình cơ sở nhanh chóng.
- Nguy cơ overfitting thấp: Được ưu tiên khi bạn muốn hiệu suất ổn định mà không cần tinh chỉnh phức tạp.
Khi nào nên dùng Fine-Tuning
- Tập dữ liệu lớn, chất lượng cao: Cần thiết để điều chỉnh mô hình sâu hơn (ví dụ: huấn luyện LLM cho văn bản pháp lý hoặc khoa học).
- Sự dịch chuyển lĩnh vực: Tốt nhất khi tác vụ mới khác biệt lớn so với lĩnh vực gốc (ví dụ: điều chỉnh BERT tổng quát cho NLP y sinh).
- Yêu cầu hiệu suất cao: Được sử dụng khi độ chính xác và khả năng khái quát hóa chuyên biệt theo lĩnh vực là yếu tố then chốt.
- Trường hợp ứng dụng doanh nghiệp/sản xuất: Phổ biến trong các ứng dụng mà mô hình tổng quát hoạt động kém nếu không được tùy chỉnh.
- Có đủ nguồn lực tính toán: Thực tế khi thời gian huấn luyện và ngân sách GPU không phải là hạn chế lớn.
Đọc thêm: Fine-tuning RAG Performance with Advanced Document Retrieval System
Khi nào nên dùng phương pháp lai (Adapter, LoRA, Prompt Tuning)
- Mô hình cực lớn: Hữu ích khi việc fine-tuning toàn bộ quá tốn kém.
- Cần sự hiệu quả: Giữ nguyên phần lớn tham số cố định trong khi chỉ điều chỉnh những tập con nhỏ.
- Thích ứng đa lĩnh vực: Linh hoạt cho việc triển khai cùng một backbone trên nhiều tác vụ.
- Tùy chỉnh LLM: Phổ biến để điều chỉnh các mô hình nền tảng (GPT, LLaMA, v.v.) mà không cần huấn luyện lại từ đầu.
Xu hướng tương lai trong Transfer Learning và Fine-Tuning
Fine-Tuning tiết kiệm tham số (LoRA, Adapter, Prefix Tuning)
Khi các mô hình mở rộng lên hàng tỷ tham số, việc huấn luyện lại toàn bộ mạng cho mỗi tác vụ mới trở nên bất khả thi. Điều này đã dẫn đến sự trỗi dậy của các phương pháp fine-tuning tiết kiệm tham số (PEFT). Các kỹ thuật như LoRA (Low-Rank Adaptation), adapter layer, và prefix tuning chỉ cập nhật một phần nhỏ tham số của mô hình trong khi giữ phần lớn còn lại cố định. Cách tiếp cận này giúp giảm nhu cầu tính toán và bộ nhớ, hạ thấp chi phí, đồng thời cho phép điều chỉnh các mô hình ngôn ngữ lớn trên phần cứng phổ thông mà không phải hy sinh quá nhiều độ chính xác.
Vai trò của mô hình nền tảng và học tự giám sát
Sự chuyển dịch hướng tới các mô hình nền tảng được huấn luyện trên các tập dữ liệu khổng lồ và đa dạng đang định hình lại cả chiến lược transfer learning lẫn fine-tuning. Những mô hình này, thường được huấn luyện bằng phương pháp học tự giám sát (self-supervised learning), nắm bắt các biểu diễn đa mục đích có thể được điều chỉnh cho nhiều tác vụ downstream khác nhau. Thay vì huấn luyện từ đầu, các tổ chức giờ đây tập trung vào việc điều chỉnh những nền tảng này bằng cách lựa chọn giữa transfer learning nhẹ, fine-tuning toàn bộ, hoặc các phương pháp tiết kiệm tham số tùy theo mục tiêu của họ. Xu hướng này đẩy nhanh việc triển khai và dân chủ hóa quyền tiếp cận các năng lực AI tiên tiến.
Thích ứng đa phương thức (mô hình Thị giác + Ngôn ngữ)
Biên giới tiếp theo là thích ứng đa phương thức, nơi các mô hình tích hợp nhiều loại dữ liệu khác nhau như văn bản, hình ảnh, giọng nói và video. Các hệ thống đa phương thức đã huấn luyện sẵn như CLIP hoặc Flamingo cho thấy cách transfer learning và fine-tuning có thể được mở rộng vượt ra ngoài một phương thức đơn lẻ.
Việc fine-tuning các mô hình nền tảng đa phương thức mở ra những khả năng mới, từ việc tự động tạo báo cáo trong y tế (kết hợp dữ liệu hình ảnh với ghi chú lâm sàng) đến các trợ lý AI có thể diễn giải và phản hồi cả câu hỏi hình ảnh lẫn văn bản. Khi nhu cầu về các ứng dụng phong phú, đa lĩnh vực ngày càng tăng, thích ứng đa phương thức sẽ trở thành một phần tiêu chuẩn trong bộ công cụ huấn luyện mô hình.
Câu hỏi thường gặp
Fine-tuning có luôn tốt hơn transfer learning không?
Không hẳn. Fine-tuning có thể mang lại độ chính xác cao hơn và hiệu suất chuyên biệt theo lĩnh vực, nhưng nó cũng đòi hỏi nhiều dữ liệu, tính toán và sự tinh chỉnh cẩn thận hơn để tránh overfitting. Transfer learning thường hiệu quả hơn và hoạt động tốt khi dữ liệu bị hạn chế hoặc khi tác vụ mục tiêu tương đồng với lĩnh vực huấn luyện gốc.
Cần bao nhiêu dữ liệu để fine-tune một mô hình?
Lượng dữ liệu cần thiết rất khác nhau tùy thuộc vào kích thước mô hình và độ phức tạp của tác vụ. Với các mô hình nhỏ hơn, vài nghìn mẫu đã gán nhãn có thể là đủ. Các mô hình ngôn ngữ lớn hoặc mô hình thị giác thường sẽ hưởng lợi từ hàng chục nghìn mẫu trở lên. Nhìn chung, mô hình càng lớn thì càng cần nhiều dữ liệu để fine-tuning hiệu quả.
Các phương pháp fine-tuning tiết kiệm tham số như LoRA là gì?
Các kỹ thuật fine-tuning tiết kiệm tham số (PEFT) như LoRA (Low-Rank Adaptation), adapter, và prefix tuning chỉ cập nhật một tập con nhỏ tham số của mô hình trong khi giữ nguyên phần backbone cố định. Điều này giúp giảm chi phí huấn luyện và mức sử dụng bộ nhớ, cho phép điều chỉnh các mô hình cực lớn với nguồn lực tính toán khiêm tốn.
Transfer learning và fine-tuning có thể được kết hợp trong thực tế không?
Có. Một quy trình phổ biến là bắt đầu với transfer learning, đóng băng phần lớn các lớp và chỉ huấn luyện một lớp phân loại mới, sau đó chọn lọc mở khóa các lớp để fine-tuning khi có nhiều dữ liệu hơn hoặc cần độ chính xác cao hơn. Các phương pháp lai như thế này mang lại sự cân bằng giữa hiệu quả và hiệu suất.
