
TL;DR
- GreenNode bán một vòng đời tích hợp, không chỉ là compute giá rẻ: notebook, network volume, model tuning, model registry và inference được kết nối sẵn với nhau, nhắm đến các đội không muốn tự ghép nối nhiều nhà cung cấp riêng lẻ (đúng vấn đề "integration glue" mà chính bài viết về nền tảng AI cho SEA của GreenNode từng nêu).
- Lưu trú dữ liệu tại Việt Nam là điểm khác biệt cốt lõi, không phải giá, nhắm đến các tổ chức tài chính, y tế, và liên quan đến chính phủ chịu ràng buộc tuân thủ trong nước, đánh đổi bằng việc không có khả năng dự phòng đa vùng (chỉ vận hành tại TP.HCM, dù có hạ tầng tại Bangkok).
- Giá theo mức sử dụng nhưng không minh bạch: có ba hình thức trả trước, trả sau, và giữ credit, nhưng mức giá cụ thể không được công bố, được xác định qua đánh giá riêng theo kích thước mô hình, tầng GPU, và lưu lượng dự kiến, gây khó khăn khi so sánh chi phí trước khi dùng.
- Tầng GPU chỉ hỗ trợ mô hình khoảng tối đa 14 tỷ tham số, và không có báo cáo benchmark độc lập bên thứ ba hay SLA uptime công khai. Đây là khoảng trống thực sự với các đội cần mô hình quy mô lớn hoặc cam kết hiệu năng có kiểm chứng.
- Đối tượng phù hợp khá hẹp và cụ thể: kỹ sư ML muốn triển khai từ notebook ra API mà không cần đội DevOps riêng, và tổ chức cần tối ưu ngôn ngữ khu vực (tiếng Việt, Thái, Indonesia): các đội cần AutoML, CI/CD tích hợp sẵn, hoặc dự phòng đa vùng nên cân nhắc lựa chọn khác (ví dụ AWS SageMaker).
Khi doanh nghiệp đã tìm hiểu đến mức đưa GreenNode AI Platform vào danh sách các nền tảng cần cân nhắc, câu hỏi lúc này không còn là "đây là sản phẩm gì" mà là "liệu có phù hợp để triển khai hay không". Bài viết này được xây dựng để trả lời đúng câu hỏi đó: trình bày rõ ràng những gì GreenNode AI Platform làm được, điểm mạnh, những hạn chế hiện tại, và so sánh trực tiếp với AWS SageMaker, RunPod, cũng như phương án tự xây dựng hạ tầng.
GreenNode AI Platform Là Gì?
GreenNode AI Platform là môi trường quản lý toàn bộ vòng đời mô hình AI của GreenNode — từ viết mã huấn luyện, tinh chỉnh (fine-tune), cho đến triển khai mô hình thành API production — được xây dựng trên hạ tầng đặt tại Việt Nam. Thay vì phải kết hợp nhiều nhà cung cấp riêng lẻ cho notebook, lưu trữ, model registry, và inference, GreenNode tích hợp cả bốn thành phần này thành một luồng làm việc thống nhất: Notebook → Network Volume → Model Registry → Inference.
Giá trị cốt lõi của nền tảng không nằm ở việc "cung cấp nhiều compute hơn" — năng lực tính toán hiện đã trở thành hàng hóa phổ thông mà bất kỳ hyperscaler hay neo-cloud nào cũng có thể cung cấp. Điểm khác biệt thực sự của GreenNode AI Platform là toàn bộ vòng đời mô hình, bao gồm cả vị trí lưu trữ dữ liệu huấn luyện, được duy trì trong một môi trường duy nhất tại Việt Nam với cơ chế kiểm soát truy cập theo từng dự án. Đối với các tổ chức mà việc xác định "dữ liệu đang được lưu trữ ở đâu" là một yêu cầu tuân thủ bắt buộc chứ không đơn thuần là một lựa chọn kỹ thuật, đây là yếu tố quan trọng hơn nhiều so với việc tối ưu vài phần trăm chi phí trên mỗi giờ sử dụng GPU.
Các Tính Năng Chính
Notebook instance
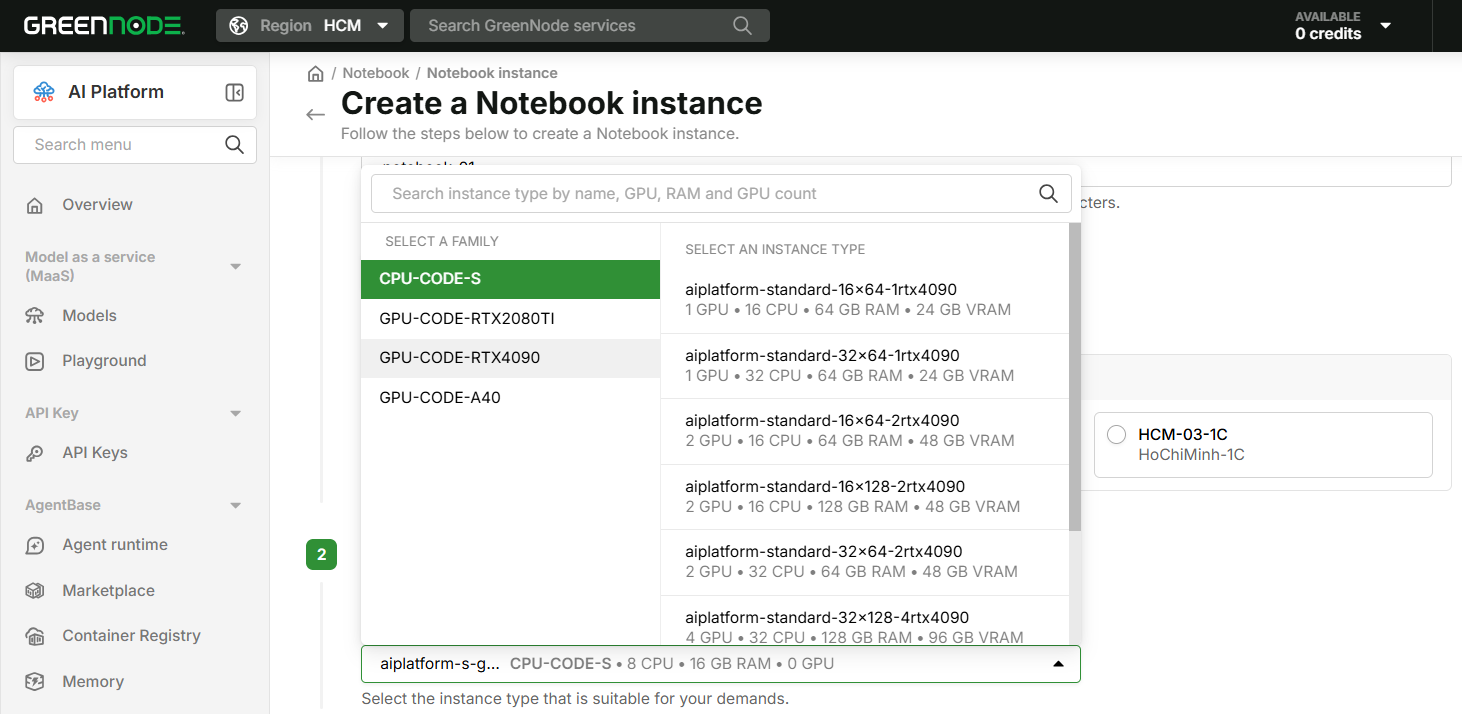
Môi trường lập trình AI tương tác, cho phép AI Engineer viết mã, thử nghiệm, và huấn luyện mô hình trực tiếp trên cloud. Hỗ trợ Jupyter Notebook — môi trường quen thuộc với phần lớn cộng đồng AI/ML; tích hợp sẵn GPU để tăng tốc huấn luyện mô hình (RTX 2080 Ti, RTX 4090, hoặc A40 tùy nhóm instance được lựa chọn); và có chức năng quản lý phiên bản mã nguồn, lưu và theo dõi lịch sử chỉnh sửa để notebook có thể được chia sẻ trong nội bộ đội ngũ. Các trường hợp sử dụng tiêu biểu: viết mã AI, thử nghiệm mô hình, tiền xử lý dữ liệu, và chạy kiểm thử inference. Một điểm cần lưu ý: notebook instance không được cấp public IP, và local block storage sẽ bị xóa khi instance dừng hoạt động — nội dung này được trình bày chi tiết hơn ở phần Hạn Chế.
Network Volume
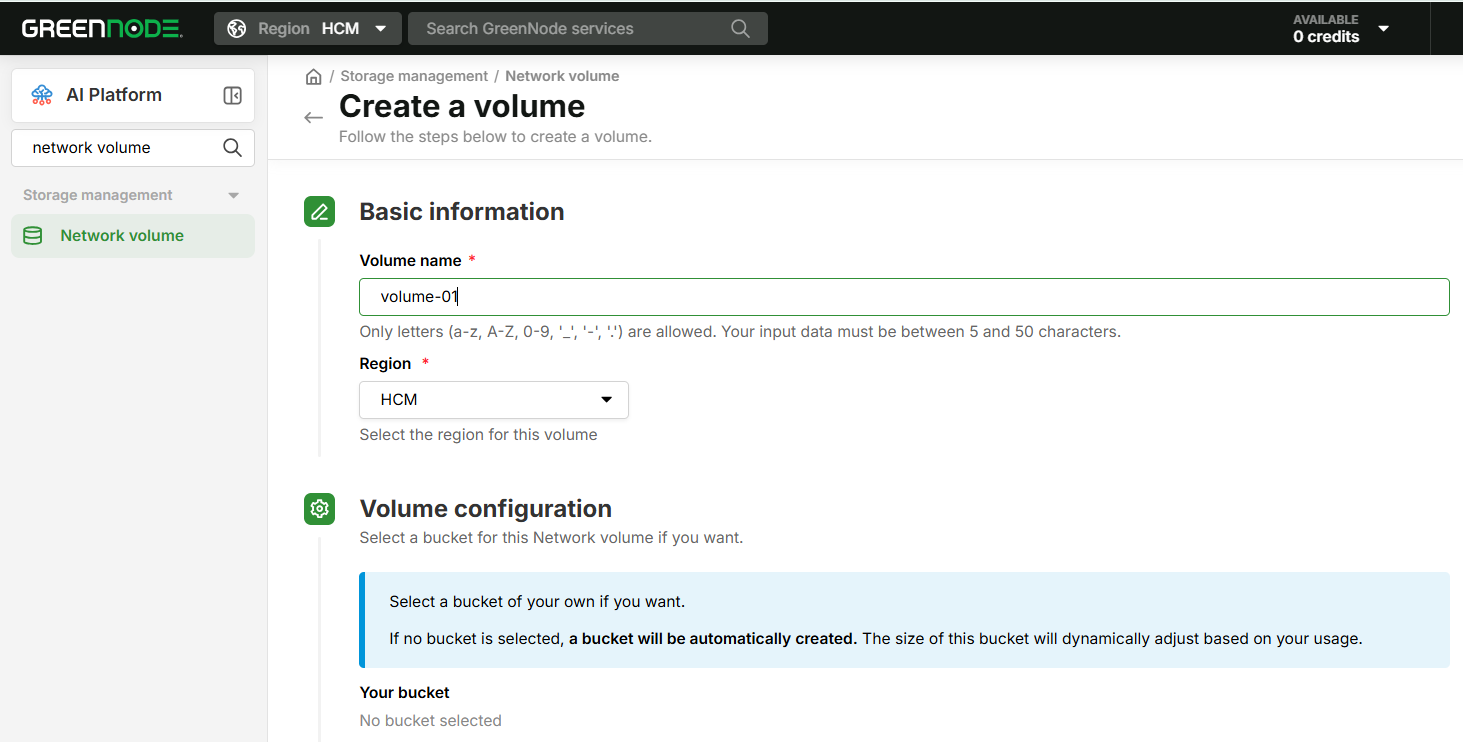
Hệ thống lưu trữ phân tán, cho phép AI Engineer chia sẻ dữ liệu, mô hình, và kết quả huấn luyện giữa các notebook và server mà không cần chuyển giao thủ công. Cung cấp dung lượng linh hoạt, có thể mở rộng phù hợp với nhu cầu xử lý dữ liệu quy mô lớn; tốc độ đọc/ghi nhanh trên nhiều phiên làm việc; và cơ chế bảo mật tích hợp với kiểm soát truy cập theo người dùng hoặc nhóm dự án. Các trường hợp sử dụng tiêu biểu: lưu trữ dataset, mô hình, kết quả huấn luyện, và file log. Trên thực tế, đây là lớp kết nối xuyên suốt của toàn bộ nền tảng — Notebook, Model Registry, và Inference đều có thể mount vào đây, giúp dataset và file mô hình không cần tải lên lại ở mỗi giai đoạn. Dữ liệu tự động đồng bộ vào local storage của notebook khi khởi động và đồng bộ ngược lại khi dừng; ngoài ra có thể push/pull dữ liệu trực tiếp qua CLI aiplatform-util hoặc các công cụ tương thích S3 như s3cmd. Đối với các đội ngũ từng gặp tình trạng mất dữ liệu do notebook gặp sự cố mà không có nơi lưu trữ bền vững, đây là tính năng giải quyết trực tiếp vấn đề đó.
Model Tuning
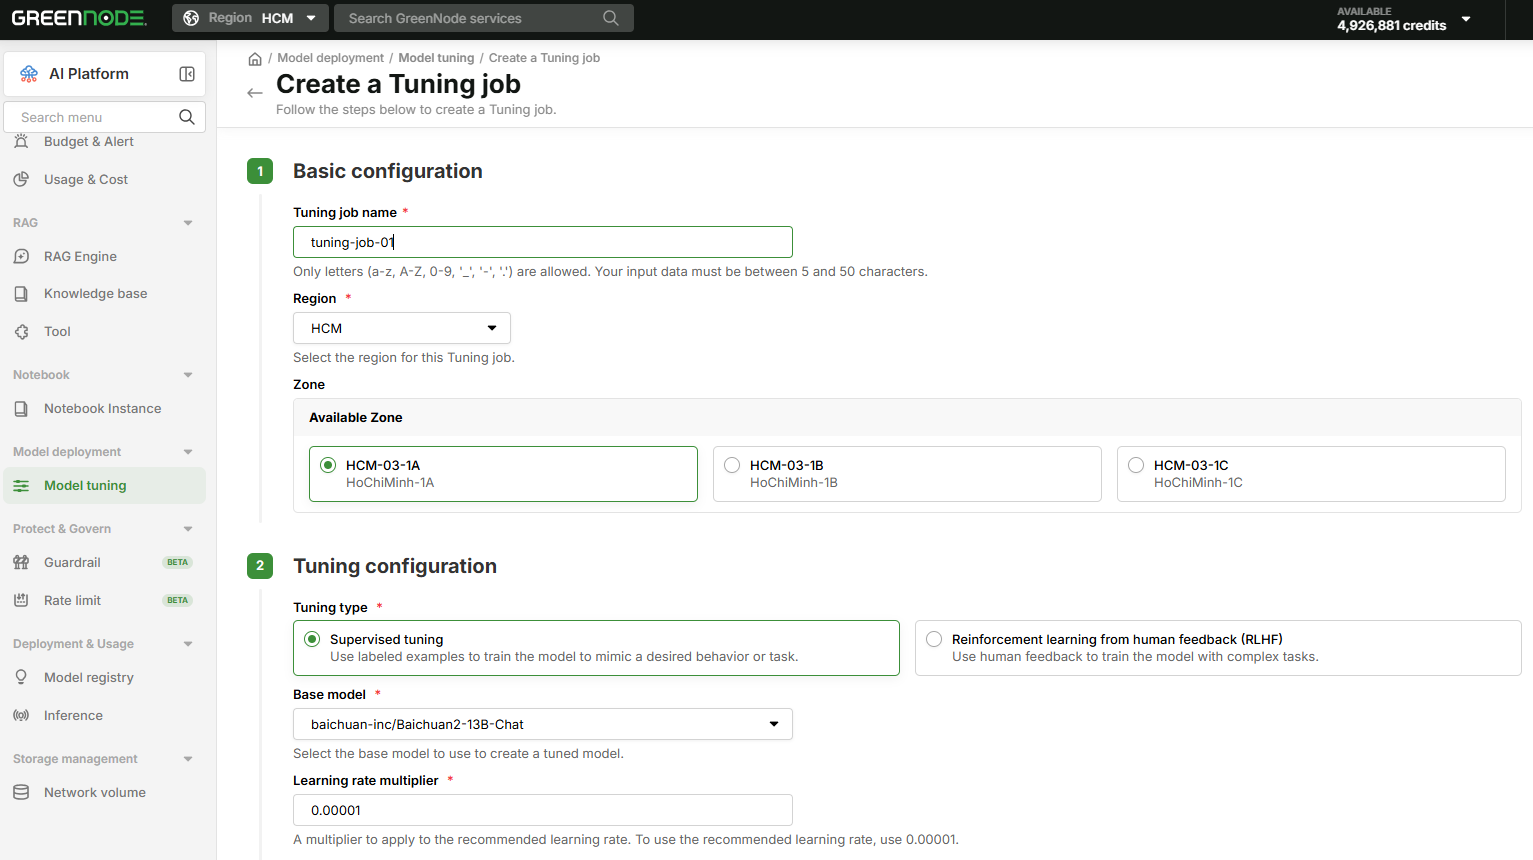
Cho phép AI Engineer tinh chỉnh tham số mô hình (hyperparameter tuning) để đạt hiệu suất tối ưu. Tính năng này tự động hóa việc thử nghiệm tham số bằng cách chạy song song nhiều phiên bản huấn luyện, hỗ trợ các thuật toán tối ưu hóa, và ghi nhận kết quả để đề xuất mô hình chính xác nhất. Các trường hợp sử dụng tiêu biểu: tối ưu mô hình cho nhận diện hình ảnh, xử lý ngôn ngữ tự nhiên (NLP), và phân tích dự đoán.
Model Registry
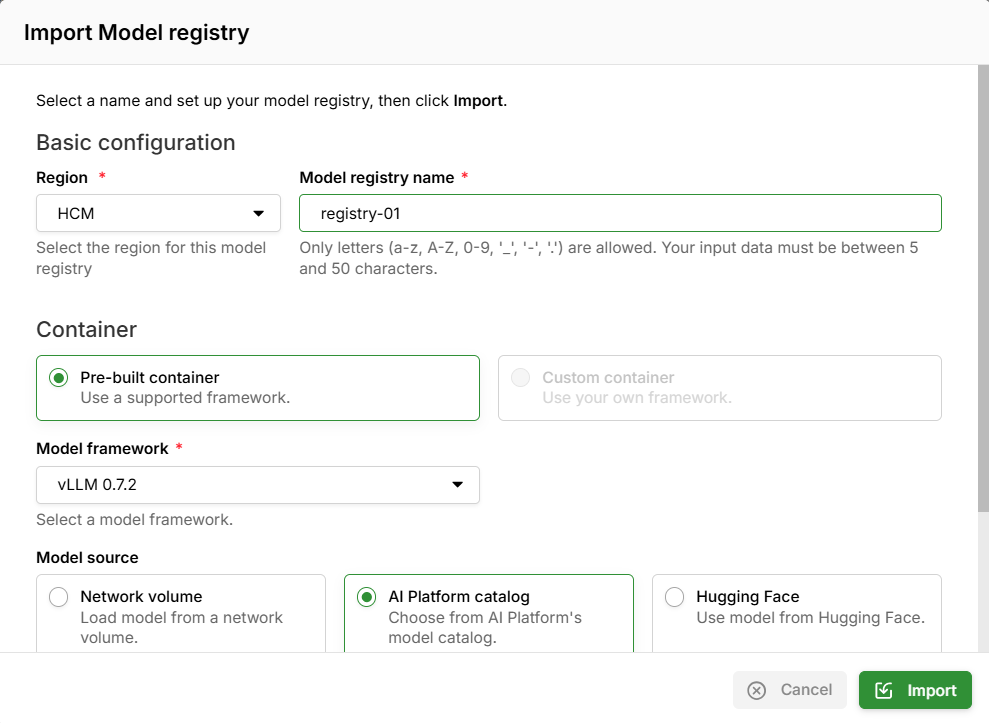
Nơi tập trung để quản lý phiên bản, lưu trữ, và quản trị các mô hình đã huấn luyện trước khi triển khai. Hỗ trợ ba phương thức import tùy theo cách mô hình được đóng gói: mô hình định dạng Triton (ONNX, TensorFlow SavedModel, TorchScript, TensorRT, OpenVINO) từ Network Volume; mô hình phục vụ qua vLLM (từ Network Volume, AI Platform Catalog, hoặc trực tiếp từ Hugging Face); hoặc container tùy chỉnh hoàn toàn với image, cổng kết nối, và cơ chế health check riêng. Phạm vi hỗ trợ này bao phủ phần lớn các kịch bản triển khai thực tế mà không giới hạn người dùng vào một serving framework cố định.
Inference
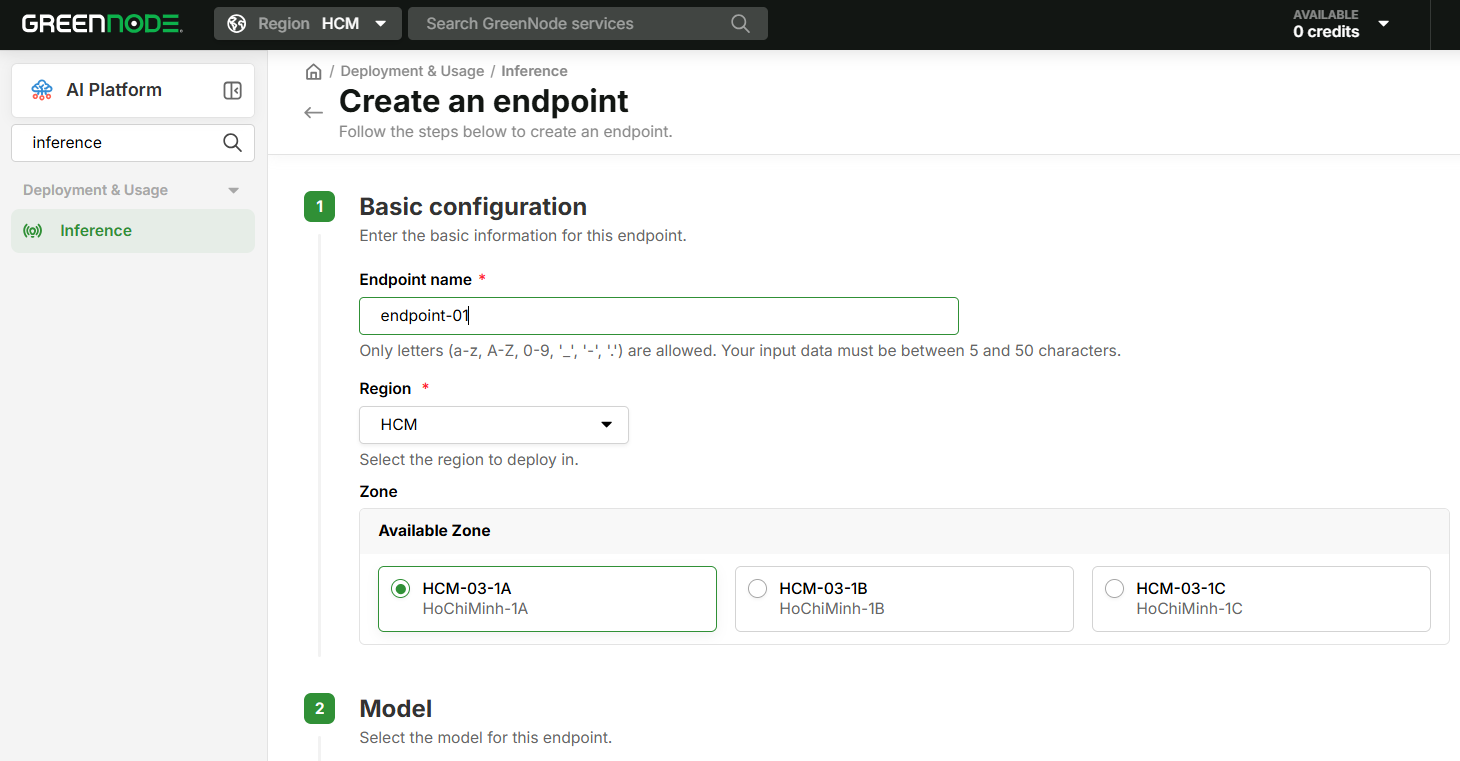
Cho phép doanh nghiệp triển khai mô hình AI và chuyển đổi thành API phục vụ ứng dụng thực tế: triển khai dưới dạng RESTful API để dễ dàng tích hợp vào ứng dụng web, mobile, và chatbot, với inference độ trễ thấp được tối ưu để đảm bảo tốc độ phản hồi nhanh, cùng khả năng quản lý phiên bản mô hình để nâng cấp và kiểm soát hiệu suất một cách an toàn. Các trường hợp sử dụng tiêu biểu: chatbot AI, phân tích hình ảnh/video, và hệ thống gợi ý. Số lượng replica có thể cấu hình cũng cho phép tự động mở rộng (autoscaling) — đây là lớp giúp rút ngắn khoảng cách giữa việc mô hình vận hành được trong notebook và việc đội ngũ sản phẩm có một endpoint sẵn sàng để tích hợp.
Một điểm cần làm rõ về phạm vi sản phẩm: AI Gateway — lớp truy cập thống nhất cho phép kết nối tới nhiều nhà cung cấp mô hình như OpenAI, Google, và DeepSeek — thường được nhắc đến cùng AI Platform trong các nội dung truyền thông của GreenNode. Về mặt cấu trúc, đây là một sản phẩm độc lập trong AI Stack của GreenNode, không phải một tính năng được tích hợp sẵn bên trong AI Platform. Tuy nhiên, hai sản phẩm này được thiết kế để vận hành song song trong cùng một tài khoản và console quản trị — Model-as-a-Service của GreenNode, ví dụ, xử lý request thông qua chính AI Gateway. Do đó, nếu doanh nghiệp cần khả năng định tuyến đa nhà cung cấp mô hình bên cạnh các mô hình đã được tinh chỉnh trên AI Platform, đây là một hạng mục có thể bổ sung dễ dàng trong cùng hệ sinh thái, không cần thiết lập quan hệ với một nhà cung cấp khác.
Giá Cả
GreenNode AI Platform áp dụng mô hình tính phí theo mức sử dụng, với cách tính cụ thể khác nhau theo từng loại tài nguyên:
- Notebook Instance: tính theo compute flavor (cấu hình CPU, RAM, GPU được lựa chọn) cộng với dung lượng Local Block Storage gắn kèm instance.
- Inference Endpoint: tính theo compute flavor (CPU/RAM/GPU) được sử dụng để vận hành mô hình. Khi bật autoscaling, chi phí sẽ được tính theo số lượng replica instance thực tế đang hoạt động tại từng thời điểm, không áp dụng mức phí cố định cho mỗi endpoint.
- Network Volume: tính theo dung lượng lưu trữ thực tế sử dụng (GB), đảm bảo khách hàng chỉ chi trả cho phần tài nguyên đã tiêu thụ.
Bên cạnh đó, GreenNode cung cấp ba hình thức thanh toán áp dụng trên toàn bộ AI Stack:
- Prepaid: thu phí ngay khi khởi tạo tài nguyên (Notebook, endpoint); phần số dư chưa sử dụng sẽ được hoàn trả tự động nếu tài nguyên được xóa trước thời hạn.
- Postpaid: sử dụng trước, thanh toán vào cuối chu kỳ dựa trên mức tiêu thụ thực tế.
- Hold Credit: áp dụng riêng cho Network Volume: hệ thống giữ lại một phần credit và khấu trừ dần theo mức lưu trữ được sử dụng.
Do chi phí thực tế phụ thuộc vào kích thước mô hình, tier GPU (RTX 2080 Ti, RTX 4090, hoặc A40), và khối lượng inference, hai doanh nghiệp cùng sử dụng nền tảng có thể phát sinh mức chi phí khác biệt đáng kể. Đây là lý do chúng tôi làm việc trực tiếp với từng khách hàng để xác định cấu hình phù hợp, thay vì áp dụng một biểu giá cố định chung cho mọi trường hợp.
Trong quy trình tư vấn, GreenNode sẽ cùng khách hàng rà soát các yếu tố cụ thể như kích thước mô hình, lưu lượng dự kiến, tier GPU cần thiết để đưa ra báo giá phù hợp với nhu cầu thực tế, thay vì cung cấp một bảng giá tổng quát không phản ánh đúng khối lượng công việc. Trước khi trao đổi trực tiếp, doanh nghiệp có thể tham khảo bảng yêu cầu phần cứng trong Model Catalog để ước lượng tier GPU cần thiết cho mô hình của mình.
Hiệu Suất Thực Tế
Về nội dung này, cần nêu rõ: GreenNode hiện chưa công bố các báo cáo benchmark độc lập, được xác thực bởi bên thứ ba về độ trễ inference, tỷ lệ SLA uptime, hay tỷ lệ khả dụng GPU. Do đó, bài viết sẽ không đưa ra các con số chưa được xác nhận chính thức. Dựa trên kiến trúc hiện tại của nền tảng, có thể ghi nhận những điểm sau:
- Vùng triển khai: Region hiện được công bố cho Notebook và Network Volume của AI Platform là HCM (TP. Hồ Chí Minh). Đáng chú ý, ở cấp độ hạ tầng, GreenNode đã vận hành một trung tâm dữ liệu AI Cloud quy mô lớn tại Bangkok, Thái Lan (STT BKK1), cho thấy phạm vi hạ tầng thực tế đã vượt ra ngoài Việt Nam — tuy nhiên năng lực tại Bangkok hiện chưa được tích hợp vào sản phẩm AI Platform. Đối với các khối lượng công việc phục vụ người dùng tại Việt Nam, việc host tại HCM mang lại lợi thế về độ trễ so với các region của hyperscaler phải định tuyến qua Singapore. Đối với các khối lượng công việc phục vụ Thái Lan, Indonesia, hay Philippines, việc AI Platform hiện chỉ có một region cần được cân nhắc so với lợi ích về chủ quyền dữ liệu mà nền tảng mang lại — doanh nghiệp nên trao đổi trực tiếp với đội ngũ kinh doanh về lộ trình mở rộng sang Bangkok nếu đây là yếu tố quan trọng.
- Các tier GPU: Các cấu hình GPU hiện có trong Model Catalog của AI Platform (RTX 2080 Ti, RTX 4090, A40) phù hợp với các mô hình có quy mô lên đến khoảng 14 tỷ tham số, căn cứ theo yêu cầu phần cứng đã công bố. Ở cấp độ hạ tầng, GreenNode cung cấp cluster GPU H100 phục vụ các bài toán distributed training quy mô lớn, tuy đây là một dịch vụ tách biệt so với lớp AI Platform được quản lý. Doanh nghiệp có nhu cầu sử dụng H100 nên trao đổi trực tiếp với đội ngũ kinh doanh để xác nhận khả năng cấp phát trong Notebook/Inference hay chỉ khả dụng dưới hình thức hạ tầng bare-metal riêng.
- Uptime: Hiện chưa có tỷ lệ SLA công khai được nêu trong tài liệu sản phẩm. Đối với các yêu cầu về cam kết uptime trong quá trình mua sắm, doanh nghiệp nên đề nghị điều khoản SLA bằng văn bản trong quá trình trao đổi với đội ngũ kinh doanh.
Đối Tượng Phù Hợp
- ML Engineer cần triển khai từ notebook đến API production mà không phải phối hợp với một đội ngũ hạ tầng hoặc DevOps riêng biệt.
- CTO / Kiến trúc sư hệ thống tại các tổ chức mà yêu cầu "hạ tầng AI đặt tại Việt Nam" là điều kiện bắt buộc, đặc biệt trong bối cảnh Luật AI của Việt Nam (có hiệu lực từ tháng 3/2026) và Luật Bảo vệ Dữ liệu Cá nhân.
- Đội ngũ trong lĩnh vực Tài chính - Ngân hàng và Y tế xử lý dữ liệu (hồ sơ KYC, hồ sơ y tế) thuộc diện không được phép rời khỏi lãnh thổ quốc gia theo quy định pháp luật, cần huấn luyện và inference diễn ra trong cùng một môi trường được quản trị.
- Đội ngũ tinh chỉnh mô hình cho ngôn ngữ địa phương — các doanh nghiệp tại Việt Nam, Thái Lan, và Indonesia cần một mô hình đạt độ chính xác cao khi vận hành bằng ngôn ngữ địa phương. Các LLM tổng quát được huấn luyện chủ yếu trên tiếng Anh thường có độ chính xác suy giảm đáng kể khi xử lý tiếng Việt, tiếng Thái, hay Bahasa Indonesia, đặc biệt với văn bản chuyên ngành như hợp đồng, hồ sơ y tế, hay nội dung hỗ trợ khách hàng. Thay vì tinh chỉnh từ một mô hình gốc tiếng Anh, doanh nghiệp có thể bắt đầu từ các lựa chọn trong Model Catalog như SeaLLMs hoặc Qwen — các mô hình đã được tối ưu cho ngôn ngữ Đông Nam Á — và tiếp tục tinh chỉnh bằng Notebook và Network Volume.
Nền tảng sẽ chưa phải lựa chọn tối ưu đối với các doanh nghiệp cần cluster H100/A100 quy mô lớn được cấp phát trực tiếp trong lớp AI Platform tự phục vụ (Notebook/Inference), thay vì dưới hình thức hạ tầng bare-metal riêng, hoặc cần một nền tảng có sẵn công cụ AutoML và hệ thống quản trị (governance) toàn diện.
Hạn Chế
Để đảm bảo tính khách quan cho quá trình đánh giá:
- Hiện chỉ hỗ trợ một region ở cấp sản phẩm. AI Platform hiện chỉ vận hành tại HCM, chưa có khả năng dự phòng đa region hay hiện diện tại Thái Lan, Indonesia, Singapore ở cấp sản phẩm, mặc dù hạ tầng của GreenNode đã có trung tâm dữ liệu tại Bangkok.
- Chưa có lớp AutoML. Model Tuning hỗ trợ tìm kiếm hyperparameter, nhưng chưa có tính năng tự động lựa chọn mô hình toàn diện như SageMaker Autopilot.
- Chưa công bố khả năng orchestration CI/CD. Các đội ngũ cần pipeline-as-code có sẵn (tương tự SageMaker Pipelines) sẽ cần tự xây dựng lớp này trên nền API.
- Local storage của Notebook có tính tạm thời theo thiết kế. Local block storage bị xóa khi dừng instance; dữ liệu chưa được đồng bộ vào Network Volume trước khi dừng sẽ không được lưu lại. Đây là một yêu cầu về quy trình vận hành, không phải lỗi hệ thống, nhưng cần được lưu ý đối với người dùng mới.
So Sánh Với Các Lựa Chọn Khác
| GreenNode AI Platform | AWS SageMaker | RunPod | Tự Xây Dựng Hạ Tầng | |
|---|---|---|---|---|
| Chủ quyền dữ liệu | Chỉ tại Việt Nam (HCM), theo thiết kế | Các region toàn cầu bao gồm Singapore; không có region tại Việt Nam | 30+ region toàn cầu; không có cam kết chủ quyền dữ liệu riêng cho Việt Nam | Tùy theo lựa chọn triển khai của doanh nghiệp |
| Phạm vi vòng đời | Notebook → Storage → Registry → Inference, được kết nối liền mạch sẵn có | Bao phủ đầy đủ vòng đời nhưng chia thành nhiều sub-service tính phí riêng lẻ, từ gán nhãn dữ liệu, notebook, đến huấn luyện, triển khai, và giám sát | Chỉ cung cấp compute GPU storage, không có sẵn registry, giao diện notebook, hay gateway | Toàn bộ vòng đời do doanh nghiệp tự xây dựng và duy trì |
| Mô hình giá | Tính theo mức sử dụng, chưa công bố biểu giá công khai | Trả theo mức sử dụng, tính phí theo từng thành phần; các instance tiền tố ml. của SageMaker thường cao hơn 20–40% so với EC2 tương đương | Công bố mức giá GPU theo giây, khoảng 0,12 USD/giờ đến hơn 7 USD/giờ tùy tier GPU | Chi phí đầu tư phần cứng hoặc thuê GPU cloud, cộng thêm chi phí vận hành nội bộ |
| Mức độ dễ sử dụng | Giao diện quản lý xuyên suốt vòng đời, yêu cầu tối thiểu về DevOps | Đầy đủ tính năng nhưng có đường cong học tập tương đối dốc đối với các tổ chức ngoài hệ sinh thái AWS | Đơn giản đối với việc thuê GPU; các thành phần khác cần tự triển khai | Toàn quyền kiểm soát, đòi hỏi đội ngũ platform/DevOps chuyên trách |
| Hỗ trợ ngôn ngữ khu vực | Có sẵn các mô hình ngôn ngữ Đông Nam Á được tuyển chọn trong Model Catalog (SeaLLMs, Qwen), sẵn sàng tinh chỉnh | Không có model catalog riêng cho khu vực Đông Nam Á | Không có model catalog tuyển chọn sẵn; doanh nghiệp tự chuẩn bị mô hình gốc và pipeline tinh chỉnh | Doanh nghiệp tự tìm kiếm, điều chỉnh, và kiểm định mô hình gốc cho ngôn ngữ khu vực |
| Phù hợp nhất với | Doanh nghiệp tại Việt Nam/Đông Nam Á cần chủ quyền dữ liệu và toàn bộ vòng đời trong một nền tảng | Tổ chức đã gắn bó với hệ sinh thái AWS, có cam kết chi tiêu và đáp ứng yêu cầu compliance (HIPAA, SOC2) qua AWS | Startup ưu tiên tối ưu chi phí, cần GPU linh hoạt mà không cần công cụ quản lý vòng đời | Tổ chức lớn đã có đội ngũ hạ tầng và yêu cầu compliance/kiểm soát riêng biệt |
Kết Luận
GreenNode AI Platform là lựa chọn phù hợp đối với các doanh nghiệp có yêu cầu bắt buộc về chủ quyền dữ liệu tại Việt Nam và mong muốn vận hành toàn bộ quy trình từ notebook đến API trong một môi trường quản trị thống nhất, không cần thành lập đội ngũ platform riêng để kết nối các dịch vụ. Đây là giải pháp phù hợp với các tổ chức trong lĩnh vực Tài chính - Ngân hàng, Y tế, và các đơn vị liên quan đến khu vực công tại Việt Nam, cũng như các đội ngũ ML Engineer cần triển khai mô hình thành endpoint nhanh chóng mà không phụ thuộc vào DevOps. Nền tảng cũng là điểm khởi đầu phù hợp đối với các đội ngũ tinh chỉnh mô hình cho tiếng Việt, tiếng Thái, hay Bahasa Indonesia — các mô hình SeaLLMs và Qwen trong Model Catalog cung cấp một điểm xuất phát tốt hơn so với LLM tổng quát tiếng Anh, một hạng mục hiện chưa có sẵn trên SageMaker hay RunPod.
Đối với các doanh nghiệp cần khả năng dự phòng đa region trên toàn Đông Nam Á, GPU tier H100/A100 được cấp phát trực tiếp trong lớp AI Platform tự phục vụ, một hệ thống AutoML toàn diện, hoặc biểu giá tự phục vụ công khai để so sánh trước khi liên hệ, các phương án như hệ sinh thái toàn diện của AWS SageMaker hoặc chi phí compute cạnh tranh của RunPod có thể là điểm khởi đầu phù hợp hơn ở thời điểm hiện tại — đi kèm với việc doanh nghiệp cần tự xây dựng thêm các thành phần khác trong vòng đời mô hình.
Bước tiếp theo: đối với các doanh nghiệp coi chủ quyền dữ liệu và một luồng làm việc Notebook → Model Registry → Inference tích hợp sẵn là ưu tiên hàng đầu, vui lòng liên hệ với chúng tôi để nhận báo giá phù hợp với mô hình và lưu lượng sử dụng thực tế.
Câu hỏi thường gặp
Có nền tảng nào toàn diện để triển khai và tối ưu mô hình machine learning không?
Có — các nền tảng như GreenNode AI Platform, AWS SageMaker, và RunPod được xây dựng để bao phủ toàn bộ vòng đời ML trong một hệ thống duy nhất. Ví dụ, GreenNode AI Platform kết nối Notebook (phát triển), Model Tuning (tối ưu hyperparameter), Model Registry (quản lý phiên bản), và Inference (triển khai) thành một luồng làm việc thống nhất, giúp các đội ngũ không phải ghép nối nhiều công cụ riêng lẻ cho việc huấn luyện, tối ưu, và phục vụ mô hình.
Đâu là những nền tảng tốt nhất để triển khai và quản lý AI inference ở quy mô lớn năm 2026?
Lựa chọn phù hợp phụ thuộc vào ưu tiên của từng doanh nghiệp. AWS SageMaker có hệ sinh thái rộng nhất và công cụ autoscaling mạnh, phù hợp với doanh nghiệp lớn đã gắn bó với AWS. RunPod là lựa chọn tốt cho các đội ngũ muốn GPU compute linh hoạt với chi phí thấp và sẵn sàng tự quản lý phần còn lại của hệ thống. GreenNode AI Platform phù hợp với các đội ngũ cần inference endpoint có khả năng autoscaling replica ngay tại Việt Nam, đặc biệt khi chủ quyền dữ liệu là yêu cầu bắt buộc song song với việc mở rộng quy mô triển khai.
Nền tảng cloud nào ở Đông Nam Á hỗ trợ fine-tune LLM mà không cần tự quản lý hạ tầng?
GreenNode AI Platform là một trong số ít lựa chọn có trụ sở tại Đông Nam Á đáp ứng được yêu cầu này — cho phép các đội ngũ fine-tune mô hình (bao gồm các lựa chọn tối ưu cho khu vực Đông Nam Á như SeaLLMs và Qwen trong Model Catalog) thông qua môi trường Notebook và Model Tuning được quản lý sẵn, mà không cần tự cấp phát hay duy trì server GPU. Đây là lựa chọn đặc biệt phù hợp với các đội ngũ tại Việt Nam, Thái Lan, và Indonesia cần việc fine-tune diễn ra trong một môi trường host tại địa phương vì lý do chủ quyền dữ liệu.
