
Đây là phần đầu tiên trong loạt 4 bài viết về cách xây dựng một “bộ não thứ hai” để dùng hằng ngày mà không cần vector DB. Phần 1 đặt nền móng cho toàn bộ series: vì sao RAG kiểu “chunk + cosine” thường hụt hơi khá nhanh, và cách ý tưởng LLM Wiki của Andrej Karpathy giúp nhìn lại bài toán này theo một hướng khác.
Vì sao RAG kiểu “chunk + vector” không phải lúc nào cũng là câu trả lời đúng?
Phần lớn các tutorial kiểu “chat với ghi chú của bạn” hiện nay đều đi theo cùng một công thức:
- Chia tài liệu thành các đoạn 500–1000 token.
- Embedding từng đoạn vào một vector DB.
- Khi có truy vấn: embedding câu hỏi → cosine top-k → nhét kết quả vào prompt → để LLM trả lời.
Cách này hoạt động được, nhưng rất nhanh sẽ lộ ra hai vết nứt lớn.
Độ tương đồng không đồng nghĩa với độ liên quan. Một đoạn văn có embedding gần với câu hỏi không có nghĩa là nó thật sự chứa câu trả lời. Đặc biệt với những câu hỏi cần suy luận như “so sánh A và B” hay “tóm tắt các bước”, top-k thường chỉ trả về những đoạn nghe có vẻ liên quan chứ không thật sự trả lời câu hỏi.
Ranh giới giữa các chunk là tùy ý. Bạn không kiểm soát được điểm cắt rơi vào đâu — rất nhiều trường hợp chunk bị cắt giữa câu, giữa đoạn lập luận, hoặc giữa một ý đang triển khai. LLM lúc đó chỉ nhìn thấy các mảnh thông tin rời rạc, rồi nối chúng lại bằng kiến thức bên ngoài để tạo ra một câu trả lời trôi chảy nhưng có thể bị “ảo giác”. Càng nhiều tài liệu, vấn đề này càng nặng hơn.
Khám phá cách tiếp cận khác của Karpathy
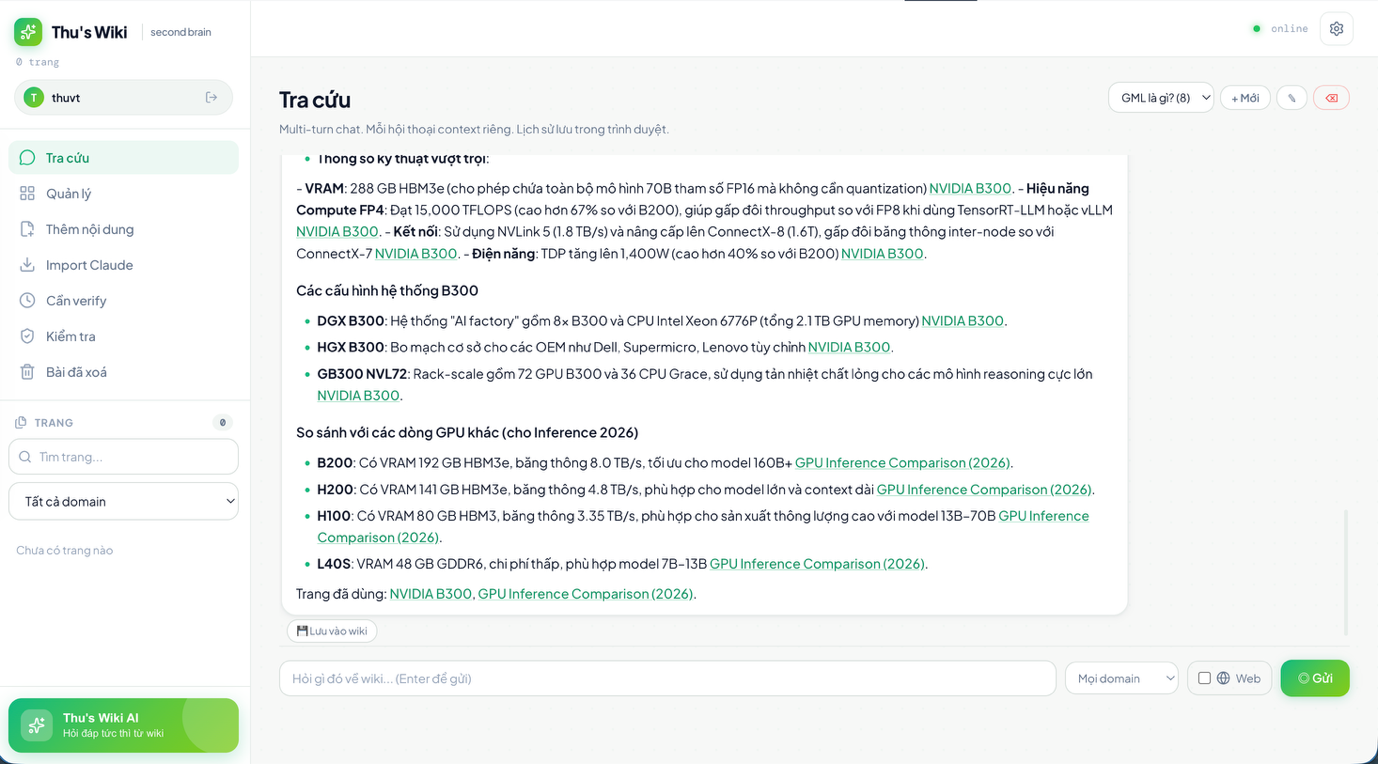
Cuối năm 2024, Andrej Karpathy đưa ra một ý tưởng ngắn gọn nhưng rất đáng chú ý: thay vì lưu văn bản thô rồi tìm theo độ giống nhau, hãy để LLM chắt lọc tài liệu nguồn thành một trang wiki có cấu trúc trước. Sau đó, khi bạn đặt câu hỏi, LLM sẽ đọc trực tiếp phần wiki này. Tri thức khi ấy đã được cô đọng sẵn, nên không còn cần một cơ chế retrieval quá cầu kỳ nữa.
Cách tiếp cận này tạo ra hai thay đổi nền tảng:
- Đơn vị lưu trữ là một trang khái niệm, không phải một chunk. Mỗi trang gói gọn một ý, ví dụ như “RAG là gì” hay “Bi-temporal schema”, và được LLM viết lại với heading, bullet và liên kết chéo.
- “Retrieval” trở thành việc đổ cả wiki vào prompt. Khi wiki còn nhỏ, cỡ vài trăm trang trở xuống, các mô hình có context 80k token hiện nay hoàn toàn có thể nuốt trọn mà không cần embeddings hay vector DB.
Điểm đáng giá nhất là bạn sẽ có một knowledge base mà con người đọc được, kiểm tra được và có thể chỉnh tay, thay vì một khối dữ liệu mà chỉ máy mới hiểu.
Cấu trúc ba thư mục
wiki-root/
raw/     # nguồn gốc ban đầu — bất biến, định danh theo nội dung bằng sha256
wiki/    # các trang đã được chắt lọc — 1 trang = 1 file .json
log.md   # nhật ký append-only của mọi thao tác
Lý do nên tách như vậy:
raw/là gốc để kiểm toán. Không bao giờ chỉnh sửa. Tên file theo dạng<sha256-rút-gọn>_<slug>.<ext>, để tránh lưu trùng cùng một nội dung và có thể phát hiện “drift” khi nguồn bên ngoài thay đổi.wiki/là phần LLM sẽ đọc khi trả lời truy vấn. Đây là nơi có thể chỉnh sửa, thay thế hoặc lưu trữ các phiên bản kế tiếp.log.mdghi lại các bản ghi dạng{ts, action, title, ...}theo kiểu mỗi dòng là một JSON và chỉ thêm mới. Nếu có sự cố, bạn có thể lần ngược lại để replay.
Một trang wiki trông như thế nào?
{
  "title": "Retrieval-Augmented Generation",
  "summary": "Kết hợp truy xuất tài liệu với sinh nội dung để LLM trả lời có nguồn.",
  "content": "## RAG là gì\nRAG kết hợp truy xuất và sinh nội dung...\n\n## Vector RAG và Reasoning RAG\n...",
  "tags": ["rag", "llm", "retrieval"],
  "links": ["Vector DB", "Embedding"],
  "domain": "Learning",
  "source": "Lewis et al. 2020",
  "source_authority": 0.95,
  "confidence": 0.9,
  "ingested_at": "2026-05-10T...",
  "updated_at": "2026-05-20T..."
}
Có ba điểm đáng chú ý ở đây:
contentlà markdown do LLM viết lại từ nguồn, chứ không phải bản sao thô. Nội dung được dọn gọn, có heading và có thể chèn[[wikilinks]]sang các trang khác.source_authority(0–1) gắn với chính nguồn dữ liệu: tài liệu chính thức = 1.0, paper = 0.9, blog = 0.5, “một tweet nào đó” = 0.3. Cònconfidencechấm điểm cho chính nội dung trang do LLM tạo ra.tagsvàdomainlà các bộ lọc rẻ nhưng hữu ích.domainlà một giá trị đơn như Work / Learning / Personal..., còntagslà tập nhãn mở, có thể gắn nhiều giá trị.
Pipeline ingest: LLM chắt lọc, không chia nhỏ
Toàn bộ pipeline gồm bốn bước:
raw text / PDF / URL
↓ lưu thành raw/<sha>_<slug>.txt (định danh theo nội dung)
↓
prompt compile cho LLM:
"Đọc nguồn này → tạo 1–3 trang wiki, mỗi trang là một khái niệm,
dùng [[wikilinks]] để tham chiếu tới các trang đã có."
↓
JSON: { pages: [{title, content, tags, links}, ...] }
↓
save_page (upsert theo title) → wiki/<slug>.json + log.md
Một phác thảo backend tối thiểu:
async def ingest_text(content: str, source_label: str, authority: float):
    sha = sha256(content)
    raw_ref = save_raw(content, source_label, sha)
    pages = await llm_compile_to_pages(content, source_label, authority)
    # LLM trả về: [{"title": "...", "content": "## ...",
    #               "tags": [...], "links": [...]}, ...]
    saved = []
    for p in pages:
        await save_page({**p,
                         "source_sha256": sha,
                         "source_authority": authority})
        saved.append(p["title"])
    return saved
Prompt compile, rút gọn:
You are a wiki compiler. Read the source below and produce 1–3 pages.
Rules:
- Each page = one core concept. No catch-all pages.
- Use ## / ### headings, bullets, short examples.
- Cross-reference other pages with [[Concept Name]]. PREFER linking to
  existing pages (see "Existing pages" list below).
- DO NOT fabricate — write only what the source supports.
- confidence = 0.9 if the source is clear; 0.6 if it's vague.
Existing pages: {{titles}}
Source (authority = {{authority}}):
{{raw_text}}
Return JSON ONLY:
{"pages":[{"title":"...","content":"## ...","tags":[...],
           "links":[...],"confidence":0.85}]}
Có hai lưu ý thực tế:
- JSON output của LLM khá mong manh. Nên dùng một hàm kiểu
tolerant_json_loadsvới vài vòng sửa lỗi và parse lại, thay vì gọi thẳngjson.loads. Các model mở như Gemma hay Llama khá hay sinh ra các escape thừa như\$,\(, nên cần dọn trước khi parse. - LLM có giới hạn context. Nếu bạn nhét nguyên một file PDF 50 trang vào một lần compile, chất lượng đầu ra sẽ giảm. Cách xử lý hợp lý hơn là chia theo cấu trúc tự nhiên như mục lục hoặc heading, thay vì chia theo token một cách cơ học.
[[Wikilinks]] giúp tri thức tự dệt thành mạng
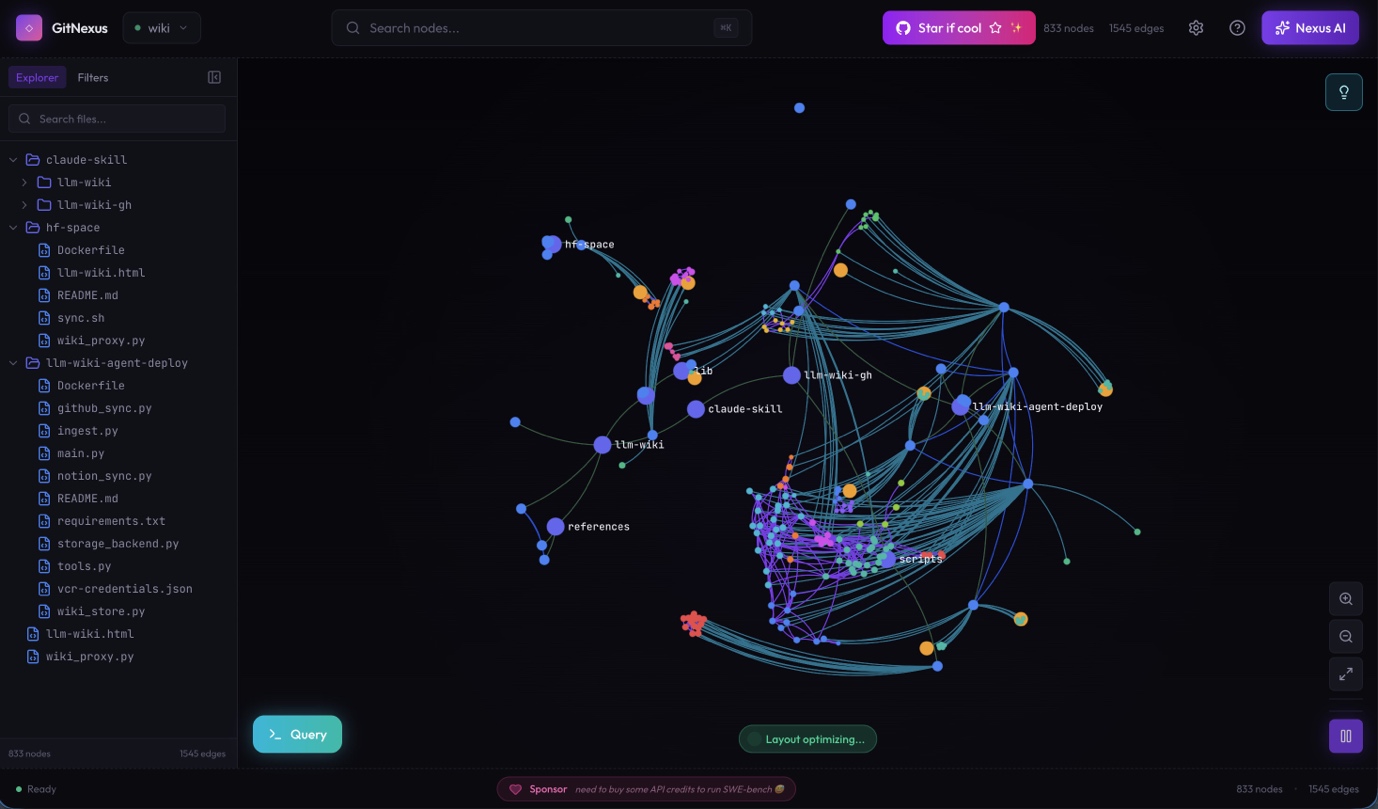
Insight cốt lõi của wiki là: đồ thị tốt hơn danh sách. Mỗi trang có thể nhúng [[Tên Trang]] để trỏ sang các trang khác. Khi render:
const wikiRe = /\[\[([^\]]+)\]\]/g;
const html = text.replace(wikiRe, (_, t) =>
  `<span class="wikilink" data-page="${t}">${t}</span>`);
Khi click, hệ thống sẽ mở trang tương ứng. Trong lúc compile, prompt cũng yêu cầu LLM ưu tiên liên kết tới các trang đã tồn tại thông qua danh sách existing_titles được truyền vào. Càng dùng lâu, đồ thị tri thức càng dày hơn — đây gần như là một dạng “retrieval miễn phí”: khi đang đọc trang RAG, bạn thấy [[Vector DB]] ngay trong nội dung, chỉ cần bấm là sang trang đó. Không cần search, không cần embedding.
Một chi tiết nhỏ nhưng rất hữu ích: nếu [[Name]] chưa khớp với bất kỳ trang nào, hãy render nó như một “broken link” với màu khác. Đây thực ra là một lời nhắc rất hay cho người viết — knowledge base tự sinh ra TODO list cho chính nó.
save_page với nguyên tắc “update-in-place”
Cùng một tiêu đề thì nên merge, không tạo ra “v2”.
async def save_page(page: dict):
    title = page["title"]
    existing = get_page(title)
    now_ts = now()
    merged = {
        "title": title,
        "summary": page.get("summary", ""),
        "content": page["content"],   # ghi đè bằng bản compile mới từ LLM
        "tags": page.get("tags", []),
        "links": page.get("links", []),
        "source_authority": page["source_authority"],
        # Giữ lại dấu vết
        "ingested_at": (existing or {}).get("ingested_at", now_ts),
        "updated_at": now_ts,
        # ... (các trường bi-temporal — sẽ nói ở Phần 2)
    }
    page_path(title).write_text(json.dumps(merged, ensure_ascii=False))
    append_log("update" if existing else "create", title=title)
“Update-in-place” là một nguyên tắc rất quan trọng: tránh để hệ thống trôi dần thành “RAG”, “RAG v2”, “RAG final”, “RAG real (final)”. Một khái niệm → đúng một trang. Versioning nên nằm trong log.md và trong cơ chế bi-temporal sẽ được giới thiệu ở Phần 2, chứ không nên nằm ở tên file.
Khi nào nên ứng dụng mô hình này?
Mô hình này phù hợp cho bạn để ứng dụng khi:
- Knowledge base cá nhân hoặc nhóm nhỏ, dưới khoảng 1000 trang. Khi đó, việc đổ toàn bộ wiki vào context 80k token vẫn còn khả thi.
- Các domain cần kết nối khái niệm theo dạng đồ thị, thay vì chỉ tra cứu chính xác từng dòng dữ liệu.
- Khi bạn muốn một KB mà con người có thể đọc, chỉnh tay và kiểm toán được.
- Các nguồn có tính diễn giải như paper, blog post, transcript — nơi việc chắt lọc mang lại nhiều giá trị.
Tuy nhiên, mô hình sẽ không phù hợp cho các trường hợp dưới đây:
- KB cực lớn, hàng triệu tài liệu — chi phí compile bằng LLM sẽ quá đắt.
- Các nhu cầu tra cứu chính xác như bảng giá hay product code — lúc này SQL mới là công cụ phù hợp.
- Các nguồn có cấu trúc cao như CSV hay API log — không nhất thiết phải chắt lọc thành wiki.
Khi wiki của bạn vượt mốc khoảng 80k token, vẫn có những hướng mở rộng mà không cần quay về vector DB — ví dụ như ingest theo mục lục (mỗi section là một page) hoặc chia theo domain để LLM chỉ đọc đúng phần người dùng đang hỏi.
Bạn có thể dựng bản đầu tiên rất nhanh
Mức tối thiểu để dựng một bản mockup trong vài giờ:
- Một endpoint LLM tương thích OpenAI (OpenAI, Anthropic, Gemma hay Ollama đều được).
- Một filesystem với
raw/,wiki/vàlog.md. Laptop cá nhân là đủ. - Khoảng 200 dòng Python cho
ingest_text,save_pagevà một chat loop có thể đổ wiki vào prompt.
Hãy bắt đầu nhỏ thôi: lấy 3–5 bài blog bạn đã đọc trong tuần này, ingest chúng, rồi thử đặt vài câu hỏi. Bạn sẽ thấy một điều khá bất ngờ là LLM thường trả lời sạch hơn so với khi bạn đưa thẳng văn bản gốc vào, vì lúc này nguồn đã được một vòng LLM khác đọc và chắt lọc từ trước.
Ba phần tiếp theo của series sẽ nói về gì?
Phần 1 mới chỉ là nền móng. Ba phần tiếp theo của series sẽ đi sâu hơn vào những điểm khiến một wiki LLM thực sự hữu ích trong sử dụng hằng ngày.
- Phần 2. Quên không có nghĩa là xóa: cách đánh dấu thông tin cũ, superseded hoặc đã lỗi thời mà không làm mất lịch sử.
- Phần 3. Cite-or-Refuse: cơ chế buộc LLM chỉ được trả lời từ tri thức nằm trong wiki, thay vì lén kéo kiến thức bên ngoài vào.
- Phần 4. Mở rộng hệ thống: cách ingest theo mục lục, chia domain và xử lý khi wiki bắt đầu vượt quá giới hạn context window.
Phần code mẫu trong series này được rút ra từ một hệ thống mình đã triển khai thực tế với GreenNode AgentBase, Notion và HuggingFace Space. Nhưng điều đáng mang theo không phải là stack cụ thể, mà là cách tư duy đứng sau nó. Khi đã nắm đúng nguyên lý, bạn hoàn toàn có thể dựng lại mô hình này với FastAPI, SQLite và file cục bộ mà vẫn giữ nguyên tinh thần cốt lõi.
