
3 giờ sáng. Điện thoại rung. Pod api-server crash loop trong production.
Mình mở laptop, ssh vào cluster, chạy kubectl logs, xem events, query Prometheus, tra runbook - 15 phút sau mới xác định được root cause. Kịch bản này xảy ra ít nhất một lần mỗi tuần. Và mỗi lần như vậy, câu hỏi tự nhiên xuất hiện: tại sao phần việc này không thể tự chạy được?
Thông tin đều có sẵn. Prometheus đang thu thập metrics. Logs đang được lưu. Runbook đã được viết sẵn. Thứ còn thiếu chỉ là một AI đủ thông minh để kết nối tất cả lại và đưa ra câu trả lời trước khi mình kịp pha xong tách cà phê.
Đó là lý do mình xây SRE Agent v3.0 - một AI agent chạy 24/7, tự động phát hiện, điều tra và cảnh báo incident trên Kubernetes, sử dụng GPT-4o qua GreenNode MAAS và chạy trên VKS (VNG Kubernetes Service).
Bạn sẽ xây được gì sau bài này
- Một AI agent nhận alert từ Prometheus → tự điều tra cluster → gửi báo cáo đầy đủ lên Teams trong vòng 30 giây
- 16 tools kubectl/PromQL/GitHub được GPT-4o gọi tự động theo thứ tự logic
- 13 runbooks làm knowledge base - AI tra cứu thay vì hallucinate fix steps
- Telegram bot để ra lệnh bằng tiếng Việt từ điện thoại, không cần Public IP
- Helm chart deploy lên cụm K8s bất kỳ chỉ với 1 lệnh
Prerequisites
- Kubectl đã kết nối với K8s cluster (VKS hoặc bất kỳ)
- Docker + Helm đã cài
- GreenNode MaaS API key - đăng ký tại portal.
- GitHub Personal Access Token (quyền Contents: Read)
- Gmail App Password 16 ký tự (không phải password thường)
TL;DR
GreenNode MaaS expose OpenAI-compatible API - toàn bộ code dùng openai SDK bình thường, chỉ cần đổi base_url. Không phải học thêm SDK mới.
Kiến trúc tổng thể
Trước khi bắt tay vào code, mình muốn giải thích quyết định thiết kế quan trọng nhất: tại sao lại chia thành 4 khối riêng biệt thay vì một monolith.
Mỗi khối có thể thay thế độc lập. Nếu bạn không dùng Teams mà dùng Slack, chỉ cần đổi Khối Thông báo. Nếu team bạn có runbook system riêng, chỉ cần đổi Khối Tri thức. GPT-4o Core không bị ảnh hưởng.
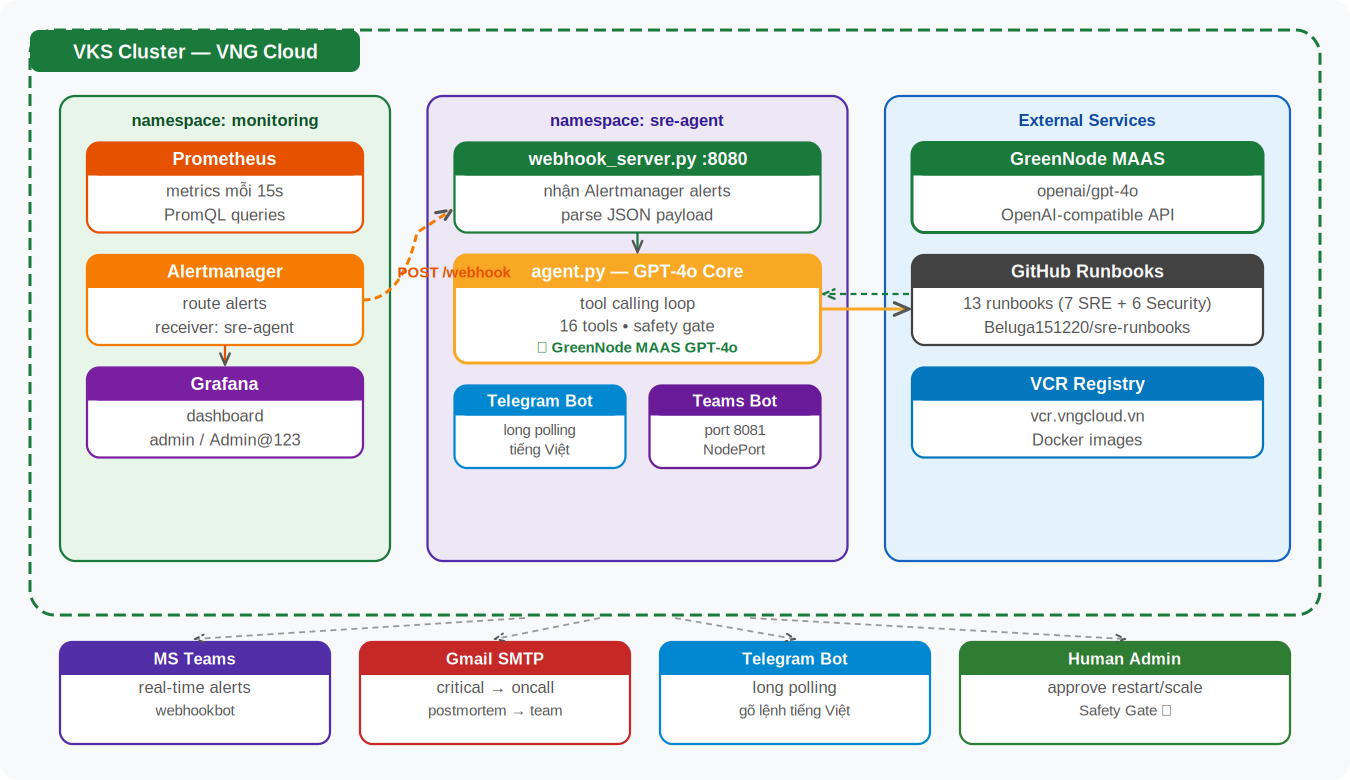
Hình 1: Kiến trúc tổng thể SRE Agent v3.0 - VKS, VNG Cloud
| Khối | Thành phần | Trách nhiệm |
|---|---|---|
| Monitor | Prometheus + Alertmanager | Thu thập metrics mỗi 15s. Khi vượt ngưỡng → gửi POST /webhook đến SRE Agent. Kỹ sư không cần làm gì ở bước này. |
| Não bộ | GPT-4o / GreenNode MAAS | Phân tích context, tự quyết định gọi tool nào theo thứ tự logic. Đây là phần duy nhất thực sự "suy nghĩ" - phần còn lại chỉ thực thi. |
| Tri thức | 13 runbooks trên GitHub | AI không hallucinate fix steps. Nó tra cứu từ runbook do chính team viết. Đây là điểm khác biệt lớn nhất so với chatbot thông thường. |
| Thông báo | Teams + Gmail + Telegram | Kỹ sư nhận message không phải "có sự cố" mà là "đây là sự cố, nguyên nhân, và bước fix." Context đầy đủ trước khi mở laptop. |
Hướng dẫn từng bước
Bước 1 - Cài Prometheus stack
Tại sao bắt đầu từ Prometheus thay vì code agent? Vì agent chỉ hữu ích khi có nguồn alert đáng tin cậy. Prometheus + Alertmanager là lớp "cảm biến" - không có nó, agent không biết khi nào cần chạy.
helm repo add prometheus-community \
https://prometheus-community.github.io/helm-charts

helm repo update
kubectl create namespace monitoring

helm install kube-prom \
prometheus-community/kube-prometheus-stack \
--namespace monitoring \
--set grafana.adminPassword=Admin@123
kube-prometheus-stack cài đồng thời Prometheus, Alertmanager, Grafana và 40+ alert rules có sẵn cho K8s. Bạn không cần viết alert rule nào từ đầu - CrashLoopBackOff, OOMKilled, NodeNotReady đều đã có sẵn.
Sau khi cài xong, lấy tên service Prometheus để điền vào .env: kubectl get svc -n monitoring | grep prometheus
Bước 2 - Cấu hình credentials
Đây là bước hay gây lỗi nhất. Mình sẽ giải thích từng biến tại sao cần và lấy ở đâu, thay vì chỉ liệt kê.
# GreenNode MAAS --- API endpoint OpenAI-compatible
MAAS_URL=https://maas-llm-aiplatform-hcm.api.vngcloud.vn/v1/
MAAS_API_KEY=vn-YOUR_KEY # lấy tại greennode.ai → AI Platform
MAAS_MODEL=openai/gpt-4o

# Prometheus URL nội bộ trong cluster
PROMETHEUS_URL=http://kube-prom-kube-prome-prometheus.monitoring.svc.cluster.local:9090

# GitHub --- để tìm runbooks
GITHUB_TOKEN=ghp_xxx # Settings → Developer → Fine-grained token
RUNBOOK_REPO=YOUR_USERNAME/sre-runbooks
RUNBOOK_PATH=runbooks

# Teams webhook
TEAMS_WEBHOOK_URL=https://webhookbot.c-toss.com/api/bot/webhooks/YOUR_ID

# Gmail --- BẮT BUỘC dùng App Password, không phải password thường
SMTP_HOST=smtp.gmail.com
SMTP_PORT=587
SMTP_USER=your@gmail.com
SMTP_PASSWORD=xxxx xxxx xxxx xxxx # myaccount.google.com/apppasswords
EMAIL_ONCALL=oncall@company.com

# Telegram
TELEGRAM_BOT_TOKEN=YOUR_TOKEN
TELEGRAM_ALLOWED_CHAT_IDS=YOUR_CHAT_ID
SMTP_PASSWORD phải là App Password 16 ký tự - Google đã tắt password thường từ 2022. Nếu dùng sai sẽ nhận lỗi 535 mà không hiểu tại sao.
Bước 3 - Xây agent core với tool calling
Đây là phần quan trọng nhất. Ý tưởng cốt lõi của tool calling: thay vì bạn hard-code "khi nhận CrashLoopBackOff thì gọi get_pod_logs", bạn cho GPT-4o biết có những tool gì, rồi để nó tự quyết định thứ tự gọi.
Điều này quan trọng hơn nghe: một alert CrashLoopBackOff và một alert NodeNotReady cần điều tra theo cách hoàn toàn khác nhau. Hard-code workflow sẽ không cover hết. GPT-4o tự suy luận sẽ.
from openai import OpenAI

# Trỏ sang GreenNode MAAS thay vì api.openai.com
client = OpenAI(
    base_url='https://maas-llm-aiplatform-hcm.api.vngcloud.vn/v1/',
    api_key=os.getenv('MAAS_API_KEY'),
)

def run_agent(message, history=None):
    history = history or []
    history.append({'role': 'user', 'content': message})

    while True:  # vòng lặp cho đến khi không còn tool nào cần gọi
        resp = client.chat.completions.create(
            model='openai/gpt-4o',
            messages=[SYSTEM_PROMPT] + history,
            tools=TOOLS,  # 16 tools định nghĩa sẵn
            tool_choice='auto',  # GPT-4o tự quyết định
        )

        msg = resp.choices[0].message

        if not msg.tool_calls:  # không còn tool → trả kết quả
            return msg.content, history

        for tc in msg.tool_calls:
            # Safety Gate: hỏi người dùng trước khi thay đổi cluster
            if tc.function.name in {'restart_deployment', 'scale_deployment'}:
                confirm = input(f'⚠️ {tc.function.name} --- Thực hiện? (yes/no): ')
                if confirm != 'yes':
                    continue

            result = execute_tool(tc.function.name, tc.function.arguments)
            history.append({'role':'tool','tool_call_id':tc.id,'content':result})
Safety Gate không phải vì AI không đủ tin cậy. Mà vì mọi thay đổi trên production system cần có người chịu trách nhiệm. Đây là nguyên tắc, không phải tùy chọn.
Bước 4 - Xây Knowledge Base với Runbooks
Runbook là thứ tạo ra sự khác biệt giữa agent "trả lời chung chung" và agent "cho bạn biết chính xác cần làm gì". Nguyên tắc đặt tên: tên file = alertname trong Prometheus.
Ví dụ thực tế từ OOMKilled.md trong repo của mình:
## Mô tả
Pod bị Linux kernel kill vì vượt quá memory limit. Exit code 137.

## Điều tra
kubectl describe pod <pod> -n <namespace>
# Tìm: Last State → Terminated, Reason: OOMKilled, Exit Code: 137

kubectl top pod <pod> -n <namespace>

## Fix
kubectl set resources deployment <n> -n <namespace> \
--limits=memory=512Mi --requests=memory=256Mi

## Chọn memory limit
1. Xem peak memory 7 ngày qua trên Grafana
2. Set limit = peak × 1.5
3. Monitor 24h sau khi tăng
15 dòng. Không cần dài hơn. GPT-4o đọc xong biết ngay cần làm gì với pod đang OOMKilled trước mắt - không phải lý thuyết chung.
Mình đang dùng 13 runbooks: 7 cho sự cố SRE thường gặp và 6 cho security incidents. Bộ security runbooks quan trọng hơn mình nghĩ ban đầu - phần lớn security alert xảy ra ngoài giờ làm việc, đúng lúc không ai trực.
Bước 5 - Kết nối Alertmanager
Bước này có một pitfall quan trọng mà mình mất 2 tiếng để debug: không dùng helm upgrade để thay đổi Alertmanager config.
Lý do: Prometheus Operator quản lý config Alertmanager qua Kubernetes Secret riêng. Khi bạn chạy helm upgradupgrade--set alertmanager.config..., Operator sẽ override lại bằng config mặc định ngay sau đó. Giải pháp duy nhất là patch trực tiếp Secret:
kubectl apply -f - <<'EOF'
apiVersion: v1
kind: Secret
metadata:
  name: alertmanager-kube-prom-kube-prometheus-alertmanager
  namespace: monitoring
stringData:
  alertmanager.yaml: |
    receivers:
    - name: sre-agent
      webhook_configs:
      - url: http://sre-agent.sre-agent.svc.cluster.local:8080/webhook
    route:
      receiver: sre-agent
      routes:
      - matchers: [alertname = "Watchdog"]
        receiver: "null"
EOF

kubectl rollout restart statefulset \
alertmanager-kube-prom-kube-prometheus-alertmanager -n monitoring
Sau bước này, mỗi khi Prometheus fire alert, Alertmanager sẽ gửi POST request về SRE Agent. Kỹ sư không cần làm gì thêm.
Bước 6 - Deploy với Helm
Mình đóng gói toàn bộ thành Helm chart để deploy lên cụm mới chỉ cần 1 lệnh. Tất cả config nằm trong values.yaml - không cần chỉnh file nào khác.
# Điền credentials vào values.yaml
nano sre-agent-helm/values.yaml

# Script tự động:
# ✅ Cài kube-prometheus-stack (nếu chưa)
# ✅ Deploy Agent + RBAC + Services
# ✅ Config Alertmanager → Agent webhook

chmod +x sre-agent-helm/deploy-new-cluster.sh
./sre-agent-helm/deploy-new-cluster.sh

# Verify
kubectl get pods -n sre-agent
# Expected: sre-agent-xxx 1/1 Running
Deploy lên cụm mới từ đầu mất khoảng 5 phút. Lần sau chỉ cần đổi KUBECONFIG và chạy lại script.
Workflow xử lý - 7 bước trong 30 giây
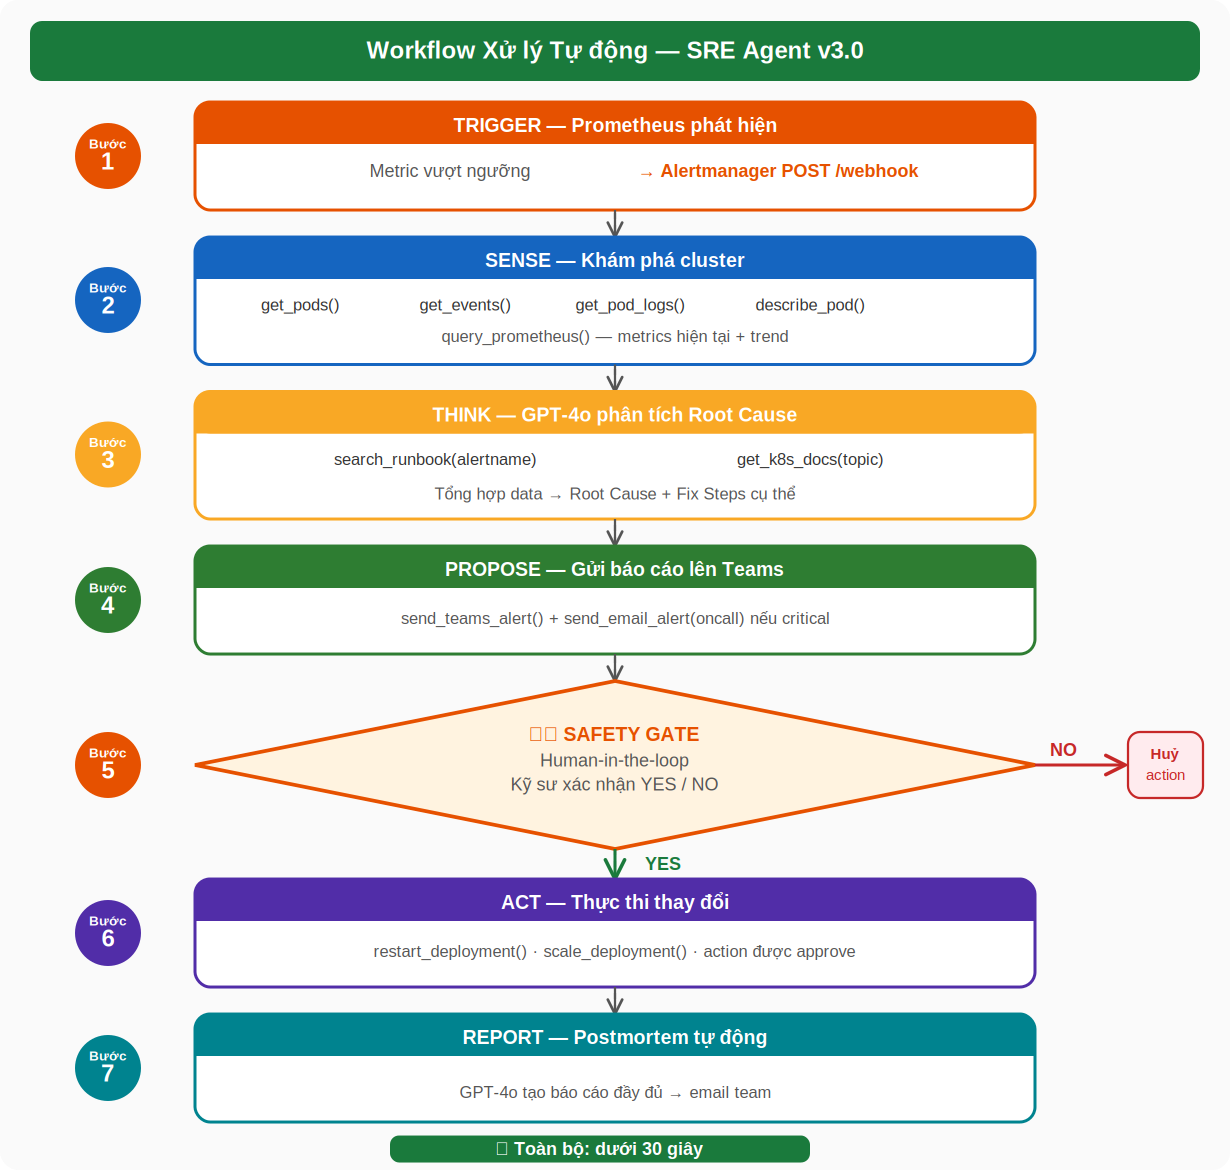
Hình 2: Workflow tự động - từ Alert đến Postmortem
Nhìn vào diagram, bạn sẽ thấy phần lớn bước là thu thập và phân tích. Thực thi chỉ xảy ra sau khi con người xác nhận. Đây là thiết kế có chủ đích: agent làm tốt phần không cần tư duy (thu thập, tổng hợp), kỹ sư giữ lại phần cần phán đoán (quyết định restart hay không).
Hai bước đáng chú ý nhất:
Bước 3 - THINK: Lần đầu xây, mình cho agent dump toàn bộ logs, events, metrics vào một prompt. GPT-4o thường bị distract bởi warning không liên quan và đưa ra root cause sai. Giải pháp: agent phải thu thập data theo thứ tự từ broad đến specific, chỉ fetch thêm khi cần. Sequence mặc định: get_pods → get_events → get_pod_logs → query_prometheus → search_runbook.
Bước 5 - SAFETY GATE: Mọi action thay đổi cluster (restart, scale) đều phải qua hỏi xác nhận. Không phải vì AI không đủ tin cậy, mà vì production system cần người chịu trách nhiệm cho mỗi thay đổi
Case study: PrivilegedContainer lúc 3h38 sáng
Đây là alert thật, xảy ra trong quá trình test. Mình để nguyên timeline để bạn thấy agent làm gì từng giây.
Alert: PrivilegedContainer · Severity: critical · Namespace: default
03:38:44 Alert firing
Alertmanager gửi POST /webhook về SRE Agent
03:38:45 Agent bắt đầu
get_pods(namespace='default') - nhận về danh sách pods
03:38:47 Tra runbook
search_runbook('PrivilegedContainer') - tìm đúng file PrivilegedContainer.md
03:38:51 GPT-4o phân tích
Xác định 6 pods đang chạy với privileged=true trong namespace default
03:38:54 Gửi Teams
send_teams_alert(severity='critical') - message lên channel
03:38:55 Email oncall
send_email_alert(to='oncall') - vì severity=critical
[CRITICAL] Security Incident: PrivilegedContainer
Time: 2026-04-10 03:38:44 | Action Required: Immediate isolation
Pods involved: nginx-nfs-84ccf7c785-kjzsl · nginx-nfs-84ccf7c785-kp9hk · test-nfs-writer
whisper-large-v3-5b9f4b7b59-hxfsr · whisper-large-v3-new-c4bf47fc-p9dfl
Tổng thời gian từ alert đến khi kỹ sư nhận thông báo đầy đủ context: 11 giây.
Điều quan trọng hơn con số 11 giây: kỹ sư nhận được message biết ngay cần làm gì - không phải "có sự cố" mà là "đây là 6 pods đang chạy privileged, xem runbook để xử lý". Không cần mở laptop điều tra từ đầu.
Telegram Bot - điều khiển cluster từ điện thoại
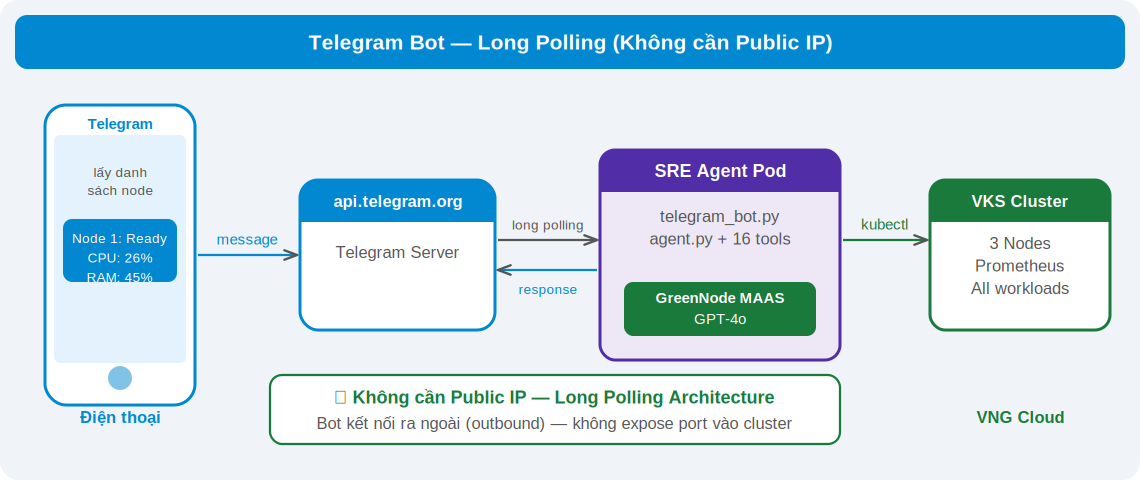
Hình 3: Telegram Bot dùng Long Polling - không cần Public IP
Telegram bot dùng long polling: bot chủ động kéo message từ api.telegram.org về thay vì chờ webhook. Điều này có nghĩa là không cần expose port ra internet, không cần Public IP, không cần firewall rule. Bot chạy trong cluster như process bình thường.
User: lấy danh sách node
Bot: Node 1: Ready (CPU: 26%, RAM: 45%)
Node 2: Ready (CPU: 15%, RAM: 50%)
Node 3: Ready (CPU: 31%, RAM: 62%)
Cluster đang hoạt động bình thường.
User: pod nào đang có vấn đề trong production
Bot: [gọi get_pods + get_events tự động]
Tìm thấy 2 pods cần chú ý:
• api-server: restart 15 lần trong 1 giờ (CrashLoopBackOff)
• worker-queue: OOMKilled 3 lần gần đây
Câu gõ vào là tiếng Việt tự nhiên. GPT-4o hiểu ngữ cảnh và tự quyết định gọi tool nào - không cần cú pháp cố định.
Setup Telegram Bot (3 bước):
- Mở Telegram → tìm @BotFather → /newbot → copy token
- Gửi /start cho bot, lấy chat_id: curl 'https://api.telegram.org/botTOKEN/getUpdates'
- Thêm TELEGRAM_BOT_TOKEN và TELEGRAM_ALLOWED_CHAT_IDS vào .env → xóa + tạo lại secret → restart
TELEGRAM_ALLOWED_CHAT_IDS không được có dấu cách sau ID. Kubernetes đọc file .env giữ nguyên dấu cách - chat ID sẽ không match và bot block tất cả mọi người.
Testing & Troubleshooting
Verify hệ thống chạy đúng
Sau khi deploy, chạy test alert thủ công để confirm toàn bộ pipeline:
kubectl run curl-test --image=curlimages/curl -it --rm \
--restart=Never -n sre-agent -- \
curl -X POST \
http://sre-agent.sre-agent.svc.cluster.local:8080/webhook \
-H 'Content-Type: application/json' \
-d '{"alerts":[{"status":"firing",
"labels":{"alertname":"CrashLoopBackOff",
"namespace":"default","severity":"warning"},
"annotations":{"summary":"Test alert"}}]}'

# Xem agent xử lý real-time
kubectl logs -f deployment/sre-agent -n sre-agent
Nếu thấy agent gọi get_pods → search_runbook → send_teams_alert trong logs và Teams nhận message → pipeline hoạt động đúng.
Lỗi thường gặp
| Triệu chứng | Nguyên nhân thực sự | Fix |
|---|---|---|
| Alertmanager vẫn gửi về null | Prometheus Operator override Helm config | Patch trực tiếp Secret - không dùng helm upgrade --set |
| SMTP Error 535 | Dùng password Gmail thường | Tạo App Password tại myaccount.google.com/apppasswords |
| Telegram block mọi người | TELEGRAM_ALLOWED_CHAT_IDS có dấu cách | sed -i 's/TELEGRAM_ALLOWED_CHAT_IDS=.*/TELEGRAM_ALLOWED_CHAT_IDS=ID/' .env |
| kubectl logs trống | Python buffer stdout | Thêm flush=True vào tất cả print() trong code, rebuild image |
| secret unchanged sau khi update | kubectl apply không force update | kubectl delete secret → create lại (không dùng apply) |
Kết quả & Bước tiếp theo
Kết quả đo được
| Metric | Trước | Sau SRE Agent v3.0 |
|---|---|---|
| Response time khi có incident | ~15 phút | ~30 giây |
| Số lần wake-up lúc 3h sáng | Thường xuyên | 0 |
| Thời gian viết postmortem | 30-60 phút | Tự động ngay sau incident |
| Security alerts bị bỏ sót | Cao (ngoài giờ không ai trực) | Gần 0 - agent trực 24/7 |
3 điểm quan trọng nhất
- Nhìn lại quá trình build, có 3 thứ mình thấy quan trọng hơn mình nghĩ lúc ban đầu.cho GPT-4o biết có những tool gì và để nó tự quyết định. Hệ thống sẽ xử lý tốt hơn với các alert chưa từng gặp.
- Runbook là knowledge base thật: AI không hallucinate khi có runbook cụ thể để tra cứu. Đây là lý do agent đề xuất fix đúng thay vì nói chung chung.
- Safety Gate là triết lý thiết kế: Không phải feature thêm vào. Mọi AI agent tác động đến production system cần có điểm dừng để con người quyết định.
Bước tiếp theo mình đang nghĩ tới
- Nếu bạn đã chạy được agent cơ bản, đây là 3 hướng mình đang tiếp tục thấy có giá trị thực tế.
- Custom alert rules cho pattern đặc thù của team là thứ mình ưu tiên nhất. Alert rules có sẵn rất tốt cho lỗi phổ biến, nhưng mỗi team có failure pattern riêng - deployment stuck sau 5 phút, latency tăng đột ngột trước khi OOM, error rate leo thang dần. Viết alert rule cho những pattern đó sẽ giúp agent bắt sự cố sớm hơn nhiều.
- Local docs - mount tài liệu nội bộ vào /app/docs - là thứ mình chưa làm nhưng thấy tiếc. Agent hiện biết fix OOMKilled theo cách chuẩn, nhưng không biết service A của team bạn có quirk riêng, hay incident tháng trước với pattern tương tự đã được xử lý thế nào. Incident history của team chính là knowledge base quý nhất mà agent chưa tận dụng được.
- Multi-cluster thì Helm chart đã hỗ trợ sẵn - chỉ cần đổi KUBECONFIG và chạy lại script. Mình chưa test nhiều nhưng về lý thuyết là clean. Nếu bạn thử và gặp vấn đề gì, mình muốn biết.
