
Tổng quan
9 giờ tối. Mình nhận task: viết runbook deploy mới cho vStorage. Mở docs.vngcloud.vn, đọc 15 trang, copy paste các đoạn quan trọng vào Notion. Mai sếp hỏi "VKS multi-AZ cluster có gì khác private cluster?", mình mở lại tab cũ, đọc lại 4 trang khác, ghi thêm.
Một tuần sau, có incident về OOMKilled trên VKS. Mình đào lại Notion nhưng không thấy trong folder loạn xộn. Mở docs lần thứ 3, đọc lại từ đầu. Mỗi lần truy cập thông tin, mình tốn 15-30 phút để rebuild context - không tích lũy gì giữa các session.
Vấn đề không phải là thiếu thông tin. Docs đầy đủ rồi. Vấn đề là không ai duy trì một knowledge base sống cho cả team - maintenance burden tăng nhanh hơn giá trị. Người ta bỏ wiki vì chán bookkeeping.
Đó là lý do mình build vllm-wiki Agent v1.0 - một agent chạy 24/7 trên GreenNode AgentBase, tự đọc docs/URL/file người dùng đưa vào, trích xuất concepts, tạo và bảo trì wiki page interconnected, dùng Gemma 4-31B qua GreenNode AI Platform. Pattern này học từ Karpathy's LLM Wiki gist: humans curate, LLMs maintain.
Bạn sẽ xây được gì sau bài này
- Một AI agent nhận URL / file / text → tự fetch qua Firecrawl, summarize, tạo 3--10 wiki page chi tiết mỗi nguồn, lưu vào AgentBase Memory persistent.
- 3 modes chính: ingest (đưa knowledge vào), query (truy vấn có citation [[slug]]), lint (phát hiện mâu thuẫn / orphan / stale).
- Sitemap-based crawler - đưa URL gốc, agent tự discover tới 500 sub-pages, ingest song song concurrency=4.
- WebUI glassmorphism với sidebar nav, dashboard stats, sources list và knowledge graph visualization (vis-network) - click node để query trực tiếp.
- Tool integration: sre-agent gọi vllm-wiki như LangChain tool để tra cứu khi xử lý alert.
Chuẩn bị trước khi bắt đầu
- IAM Service Account trên GreenNode Portal (iam.console.vngcloud.vn) - agent dùng CLIENT_ID + CLIENT_SECRET để gọi Memory/Identity APIs.
- GreenNode AI Platform API key - model google/gemma-4-31b-it, 128K context, free tier.
- Docker + Python 3.10+ trên máy local.
- vCR Container Registry hoặc Docker Hub để push image.
- (Optional) Firecrawl self-hosted trên K8s hoặc cloud API key - fallback httpx nếu không có.
GreenNode AI Platform exposes OpenAI-compatible endpoint - code dùng langchain_openai.ChatOpenAI chỉ cần đổi base_url. Không cần học SDK riêng.
Kiến trúc tổng thể của vllm-wiki agent
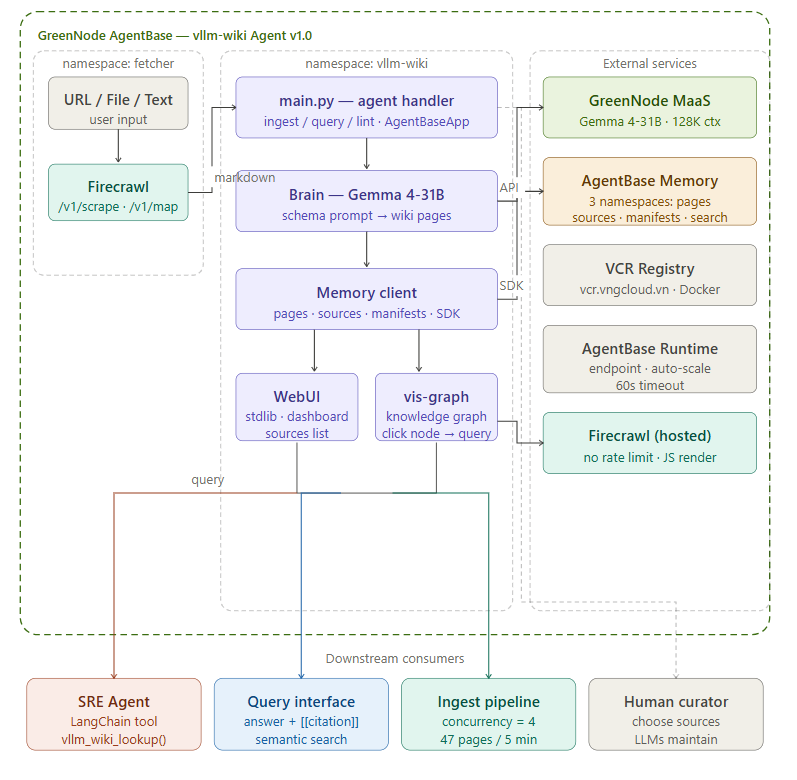
Hình 1: Kiến trúc tổng thể vllm-wiki Agent v1.0 - 4 layer độc lập
Luồng xử lý - Request Flow
Luồng 1 - Ingest (đưa knowledge vào)
Từ URL đến wiki page chi tiết trong 3 bước. AgentBase gateway có hard timeout 60s - giải pháp 2 tầng discover + ingest riêng biệt giải quyết vấn đề này.
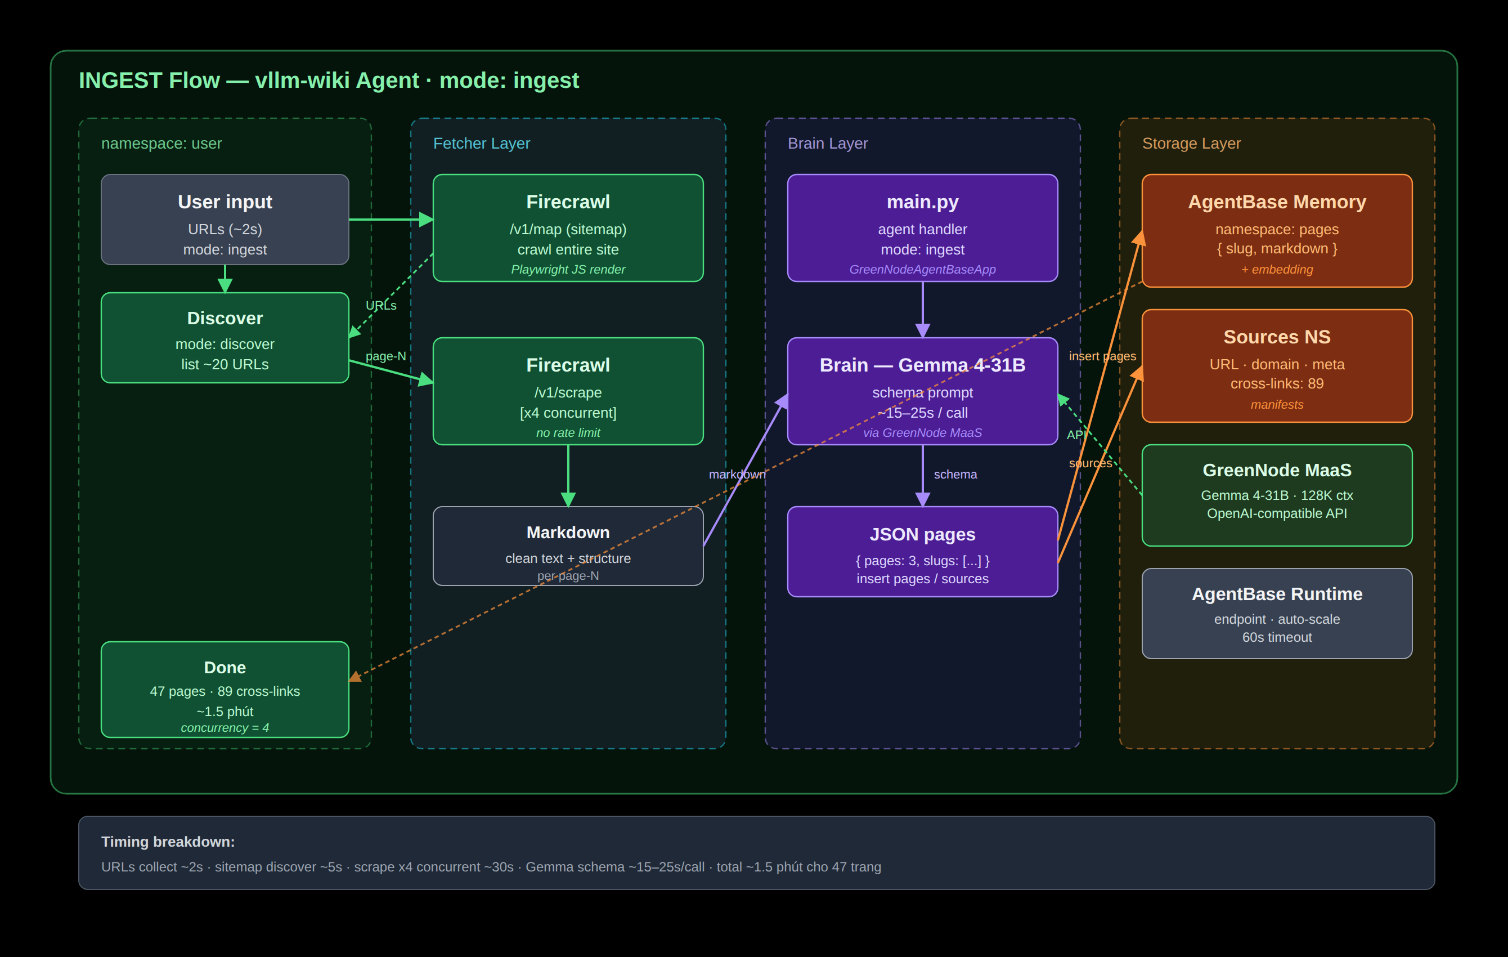
Hình 2: Ingest pipeline - 2-phase: discover (1 call) → ingest (N calls song song, concurrency=4)
Safety: mỗi ingest call ~15--25s < 60s timeout. 4 worker song song → throughput 4×. Crawl 20 URLs từ 7 phút (serial) → 1.5 phút.
Luồng 2 - Query (truy vấn có citation)
Từ câu hỏi tự nhiên đến câu trả lời có citation [[slug]] trong vài giây. Gemma 4-31B chỉ cần tổng hợp - không cần fetch web thêm.
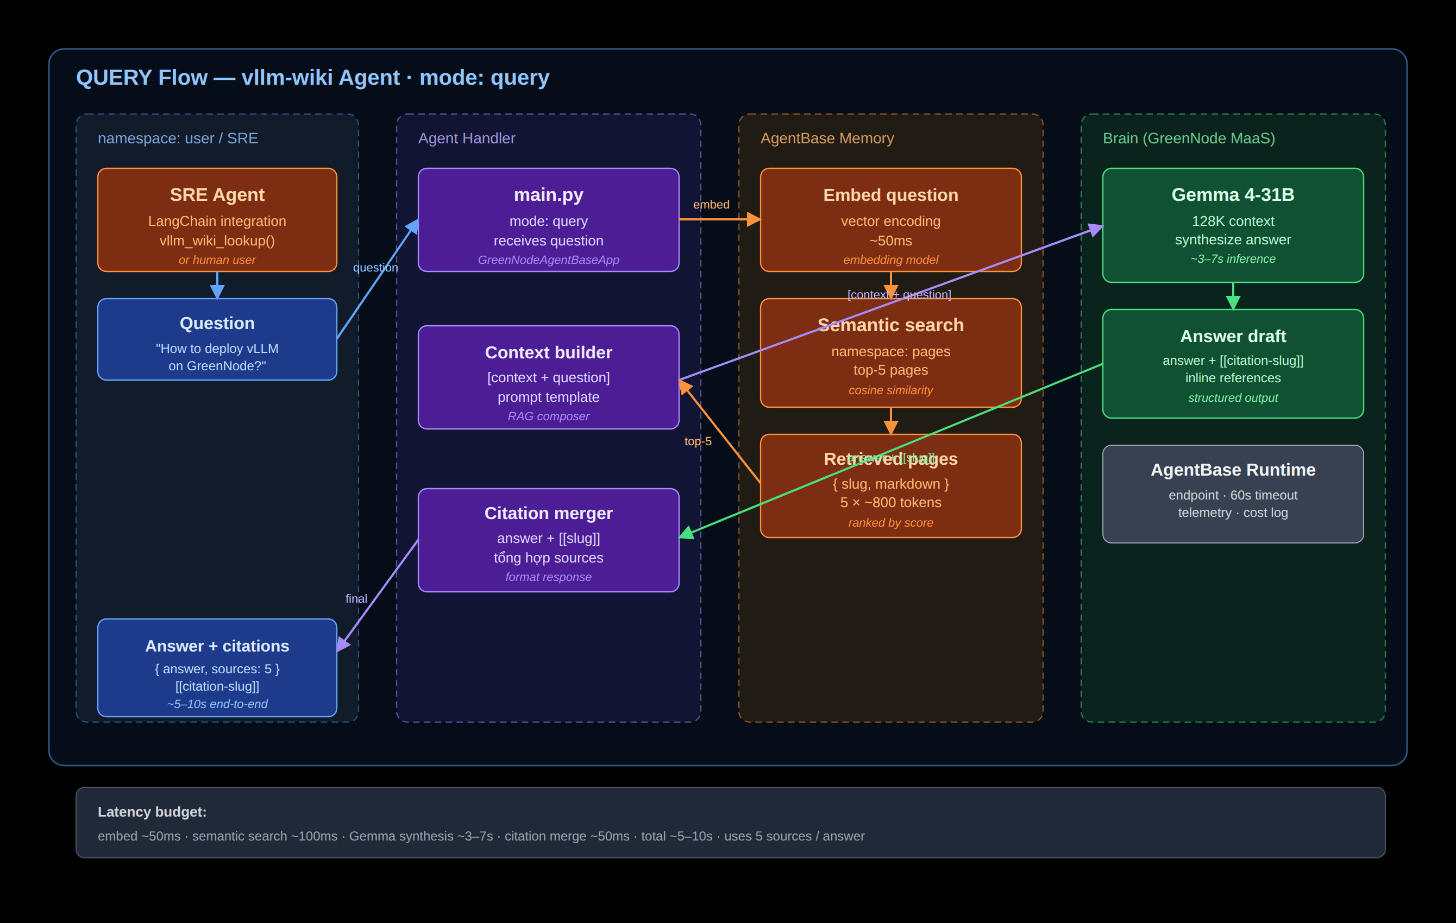
Hình 3: Query pipeline - vector search → context injection → Gemma tổng hợp → answer + citation
Tool integration: SRE Agent gọi vllm_wiki_lookup() như LangChain tool - cùng flow, response trả về string cho agent dùng tiếp.
Luồng 3 - Lint (phát hiện stale / mâu thuẫn)
Chạy định kỳ hàng tuần. Phát hiện wiki page nói thông tin cũ, orphan page không có ai link tới, mâu thuẫn giữa hai page.
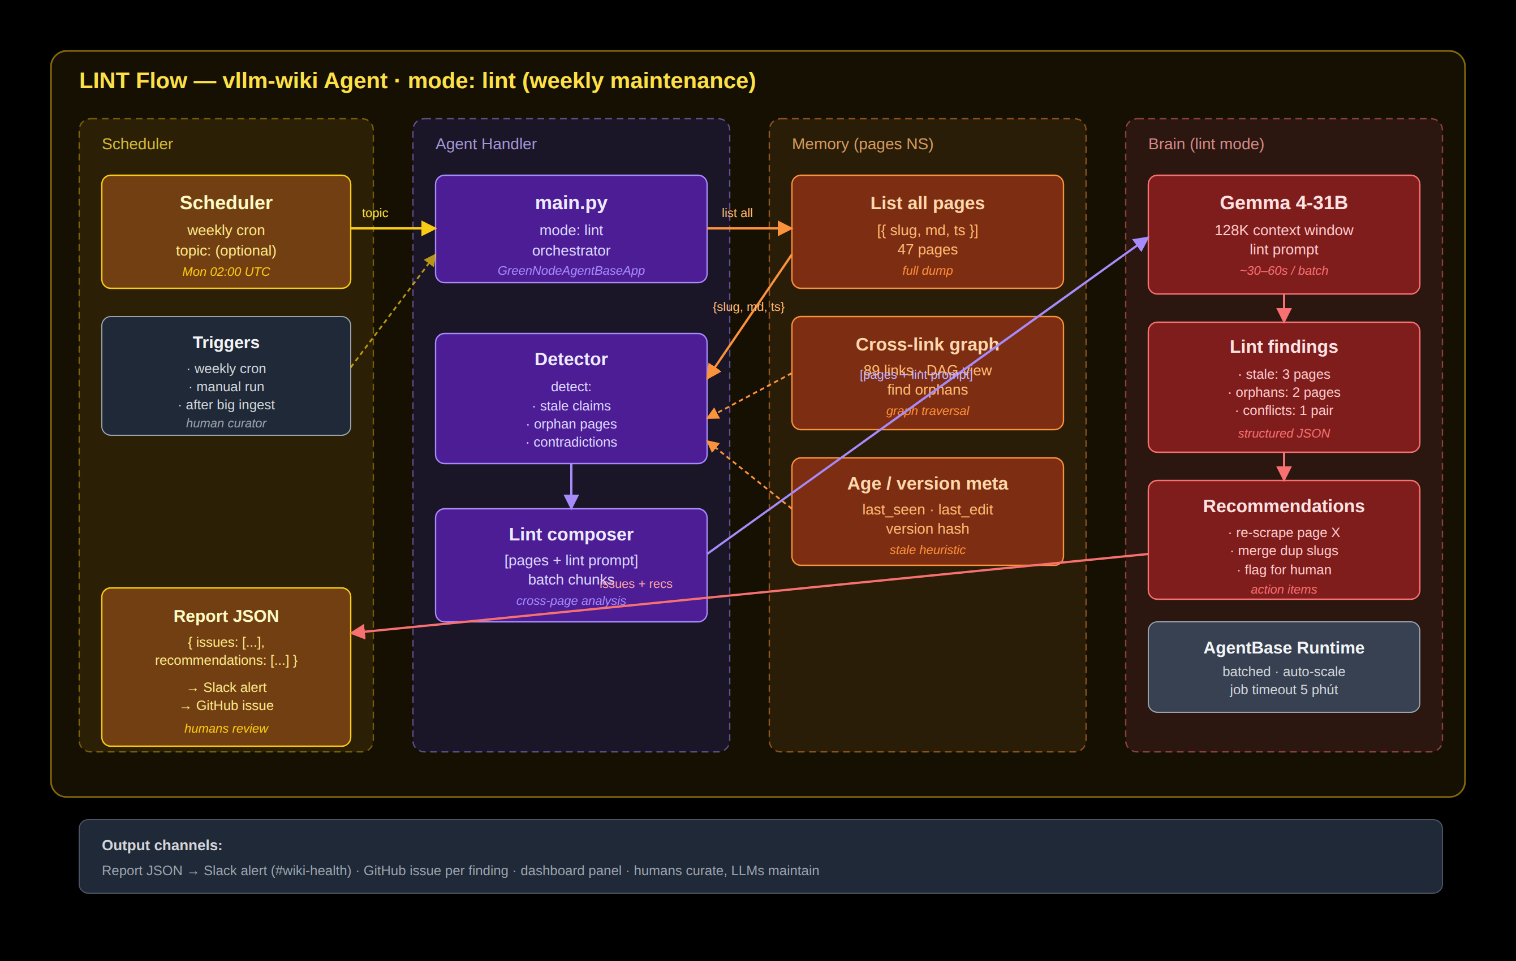
Hình 4: Lint pipeline - phát hiện stale claims, orphan pages, mâu thuẫn tự động
Lint mode chưa có trong v1.0 - roadmap cho v1.1. Hiện tại chạy manual bằng cách gọi mode: lint qua API.
Hướng dẫn từng bước
Bước 1 - Scaffold project
Cấu trúc project tối thiểu - mình cố ý giữ nhỏ: chỉ 5 file trước khi thêm feature.
mkdir vllm-wiki-agent && cd vllm-wiki-agent
python -m venv venv && venv/Scripts/Activate.ps1 # Windows
pip install greennode-agentbase langchain langchain-openai httpx python-dotenv
vllm-wiki-agent/
├── main.py            # entrypoint - GreenNodeAgentBaseApp handler
├── webui.py           # local UI server (stdlib only, không cần Node)
├── requirements.txt
├── Dockerfile
└── .env.example
.dockerignore bắt buộc có .env, .greennode.json, venv/. Không để leak secrets vào image.
Bước 2 - Cấu hình credentials
Mình giải thích từng biến: lấy ở đâu và tại sao cần, thay vì chỉ liệt kê.
# .env
GREENNODE_CLIENT_ID=        # auto-injected khi deploy lên Runtime
GREENNODE_CLIENT_SECRET=
LLM_API_KEY=vn-xxx          # từ aiplatform.console.vngcloud.vn
LLM_BASE_URL=https://maas-llm-aiplatform-hcm.api.vngcloud.vn/v1
LLM_MODEL=google/gemma-4-31b-it   # free tier, 128K context
MEMORY_ID=memory-xxxxxxxx         # tạo qua AgentBase console
# Optional - content sạch hơn nhiều khi ingest URL
FIRECRAWL_API_KEY=fc-xxx
FIRECRAWL_URL=http://firecrawl.your-cluster/
Khi deploy lên AgentBase Runtime, GREENNODE_CLIENT_ID/SECRET được runtime tự inject - không hardcode vào .env cho production.
Bước 3 - Core handler theo LLM Wiki pattern
3 mode chính - mỗi mode 1 function độc lập. Lý do quan trọng: tách biệt để test từng mode riêng mà không cần chạy cả stack.
from greennode_agentbase import GreenNodeAgentBaseApp, RequestContext
from langchain_openai import ChatOpenAI
app = GreenNodeAgentBaseApp()
llm = ChatOpenAI(
    model=os.environ["LLM_MODEL"],
    base_url=os.environ["LLM_BASE_URL"],
    api_key=os.environ["LLM_API_KEY"],
    temperature=0.2,
    max_tokens=5000,
    timeout=55,
)
@app.entrypoint
def handler(payload: dict, ctx: RequestContext) -> dict:
    mode = payload.get("mode", "query")
    if mode == "ingest":
        text = _fetch_url(payload["url"]) if payload.get("url") else payload["text"]
        return _ingest(text, source_label=payload.get("url"))
    if mode == "query":
        return _query(payload["question"])
    if mode == "lint":
        return _lint(payload.get("topic"))
Ingest flow - 5 bước tuần tự:
- Search semantic top-5 page liên quan trong namespace pages (context cho LLM hiểu wiki hiện tại).
- Gọi LLM với system prompt = schema, user prompt = source + related pages.
- LLM trả JSON: {summary, pages: [{slug, markdown}], notes}.
- Insert từng page vào Memory namespace pages.
- Insert manifest {label, timestamp, summary, pages} vào manifests để Sources tab list được.
Bug đáng nhớ: MemoryClient.insert_memory_records_directly() nhận dict {"memoryRecords": [text]}, không phải list [text]. TypeError không rõ nếu truyền sai -check version SDK.
Bước 4 -Page schema chi tiết
Chất lượng wiki nằm ở system prompt ép LLM theo cấu trúc cứng. Schema thay đổi (thêm section Trade-offs) chỉ cần edit prompt --- không recompile.
## [[slug]]
**TL;DR:** 1--2 câu tóm tắt core idea
### Overview
### Key details
### How it works
### Use cases
### Related
- [[related-slug-1]]
- [[related-slug-2]]
### Sources
- https://nguon.url
Prompt cũ chỉ nói "produce pages" → LLM hay merge 2 sub-source thành 1 page. Fix: nhấn mạnh "nếu source chứa === Page: URL === blocks, produce ít nhất 1 wiki page per block". Crawl 5 URLs → 8--12 wiki pages riêng biệt.
Bước 5 - Sitemap discovery với /v1/map
Khi test Firecrawl trên docs.vngcloud.vn/vng-cloud-document/vn/ai-platform, so sánh 2 endpoint:
- /v1/crawl → 0 URLs (bị onlyMainContent strip sidebar navigation)
- /v1/map → 50 URLs trong 1.87s - đầy đủ ai-platform/notebook-instance, model-registry, ai-gateway/*, v.v.
→ Dùng /v1/map cho sitemap discovery, /v1/scrape cho content extraction. Self-host Firecrawl trên K8s: tốc độ ngang cloud, không bị rate limit.
Bước 6 - Async crawl + parallel ingest
AgentBase invocation gateway có hard timeout 60s. Crawl 20 URLs × 20s LLM mỗi page = 400s - không fit. Giải pháp 2 tầng:
- Discover phase (~2s): UI gọi mode: "discover" → backend hit /v1/map → return list URLs ngay.
- Ingest phase (N calls song song): UI loop N URLs với concurrency=4 - mỗi call 15--25s, dưới 60s timeout.
async function worker() {
  while (cursor < urls.length) {
    const i = cursor++;
    inflight.add(urls[i]);
    renderProgress();
    const r = await api({mode:'ingest', url: urls[i]});
    results[i] = r;
    inflight.delete(urls[i]);
    done++;
    renderProgress();
  }
}
await Promise.all(Array.from({length: 4}, worker));
Kết quả: Crawl 20 URLs giảm từ 7 phút xuống ~1.5 phút - throughput 4×.
Bước 7 - Deploy lên GreenNode AgentBase Portal
Toàn bộ agent chạy trên GreenNode AgentBase Runtime - managed platform, bạn không cần tự quản Kubernetes hay lo scaling. Có 2 cách deploy, cùng trỏ tới image trên vCR:
- Qua Portal UI (không cần CLI): mở aiplatform.console.vngcloud.vn/runtime → Create Runtime → chọn vCR image → flavor 2x4-general → nhập env vars → Create. Endpoint public sinh tự động, IAM credentials được Portal inject sẵn.
- Qua CLI (reproducible, hợp CI/CD): build + push + gọi runtime API như dưới đây.
# Login vCR
echo $VCR_PASSWORD | docker login vcr.vngcloud.vn -u $VCR_USER --password-stdin
# Build & push
docker build --platform linux/amd64 -t vcr.vngcloud.vn/$REPO/vllm-wiki:latest .
docker push vcr.vngcloud.vn/$REPO/vllm-wiki:latest
# Deploy runtime
bash runtime.sh create \
  --name vllm-wiki \
  --image vcr.vngcloud.vn/$REPO/vllm-wiki:latest \
  --flavor 2x4-general \
  --env-file .env \
  --min-replicas 1 --max-replicas 2 \
  --cpu-scale 50 --mem-scale 50
# Verify
# Endpoint: https://invocation-agentbase.api.vngcloud.vn/runtime/endpoint-xxx
Update sau khi sửa code: rebuild + push cùng tag :latest, rồi bấm Update trên Portal (hoặc runtime.sh update) - AgentBase tự rolling restart (UPDATING → ACTIVE trong ~60s, zero downtime). Logs, metrics, scaling đều quản lý trực tiếp trong GreenNode AgentBase Portal.
Pipeline Ingest: Từ URL đến Wiki Page
User ──┐
       │ URL / file / text
       ▼
┌─── DISCOVER ───┐
│ /v1/map list URLs ngay (1 call, ~2s)
│
│──────────────▶
└────────────────┘
       │ N URLs
       ▼ (concurrency = 4)
┌─── SCRAPE ─────┐
│ /v1/scrape markdown sạch, strip nav/JS
│ Firecrawl
│──────────────▶
└────────────────┘
       │ clean markdown
       ▼
┌─── STRUCTURE ──┐
│ Gemma 4-31B
│ 3--10 wiki pages / source
│ Brain LLM
│──────────────▶
└────────────────┘
       │ JSON { slug, markdown }
       ▼
┌─── STORE ──────┐
│ AgentBase persistent, searchable
│ Memory
│──────────────▶
└────────────────┘
       │ ✅ indexed
       ▼
QUERY: User hỏi → vector search → Gemma tổng hợp → answer + citation [[slug]]
Hình 2: Ingest & Query pipeline - 4 stages
Stage 2 (SCRAPE) là điểm cải thiện rõ nhất: ban đầu dùng httpx.get().text → vứt 480KB HTML vào LLM. Gemma đọc 90% là CSS và nav - gen kém. Chuyển sang Firecrawl với onlyMainContent=true → input giảm từ 480KB xuống 4KB chất.
Stage 4 (STORE) cần truncate trước insert. AgentBase Memory reject record >10KB. Cap mỗi record 8000 chars đủ cho page 700 từ + buffer.
Case study: Ingest toàn bộ docs VKS trong 5 phút
Đây là timeline thực tế từng giây:
T+0s Submit ingest - crawl=true, limit=20.
T+2s Discover xong - Sitemap trả 20 URLs: vks-la-gi, mo-hinh-hoat-dong, getting-started/create-public-cluster (+ variants), multi-az-cluster, private-cluster, terraform, release-notes.
T+5s → T+90s Parallel ingest - 4 worker chạy đồng thời. UI hiển thị "ingested 12/20 · 4 in flight" realtime. Mỗi page sinh 2-4 wiki pages.
T+95s Hoàn tất - 47 wiki pages mới, 89 cross-links [[slug]]. Graph tab show cluster vks với 12+ incoming edges - hub rõ ràng.
T+96s Test query - "Compare public cluster vs private cluster in VKS" → Answer 3 đoạn, cite [[public-cluster]], [[private-cluster]], [[node-group]], [[networking-cni]]. Sources: 5.
Tích hợp với Agent khác và biến wiki thành Tool
Khi wiki đã đủ giàu, mình bắt đầu nghĩ: nếu sre-agent có thể tự tra cứu thay vì hỏi mình mỗi lần thì sao? vllm-wiki vốn có HTTP endpoint công khai, nên việc còn lại chỉ là wrap thành 1 LangChain tool. Team mình mất đúng 20 phút để paste đoạn code dưới đây vào sre-agent main.py, rebuild, push - và từ lần đó sre-agent biết tự "đọc tài liệu" trước khi reply alert.
from langchain_core.tools import tool
import httpx
VLLM_WIKI = "https://invocation-agentbase.api.vngcloud.vn/runtime/endpoint-xxx"
@tool
def vllm_wiki_lookup(question: str) -> str:
    """Look up VNG Cloud / vLLM / VKS / AI Platform docs. Use for questions about infrastructure and runbooks."""
    r = httpx.post(
        f"{VLLM_WIKI}/invocations",
        json={"mode": "query", "question": question},
        timeout=60.0
    ).json()
    return r.get("answer", r.get("error", "lookup failed"))
agent = create_agent(llm, tools=[*existing_tools, vllm_wiki_lookup])
Một incident thực tuần này: 3 giờ sáng, sre-agent của team mình nhận alert CrashLoopBackOff trên cluster prod. Thay vì ping mình dậy, agent tự gọi vllm_wiki_lookup("How does VKS handle pod crash loop") → wiki trả answer với runbook steps → SRE chạy kubectl describe pod để confirm tình trạng pod, rồi gửi report đầy đủ vào Teams kèm runbook step-by-step. Khi mình thức dậy, alert đã được xử lý xong - chỉ cần review và approve. Đó là lúc mình nhận ra: wiki không chỉ phục vụ con người, nó còn là "trí nhớ chung" cho cả hệ thống agent.
Kiểm thử và xử lý lỗi
Xác thực hệ thống chạy đúng
Sau khi deploy lần đầu, mình hay paste mấy lệnh dưới đây vào terminal để smoke-test 3 mode chính. Nếu cả 3 trả 200 OK trong vòng dưới 30 giây, gần như chắc chắn agent đã sẵn sàng cho team dùng:
# Test ingest
curl -X POST https://<endpoint>/invocations \
  -H 'Content-Type: application/json' \
  -d '{"mode":"ingest","url":"https://docs.vngcloud.vn/vks"}'
# Test query
curl -X POST https://<endpoint>/invocations \
  -H 'Content-Type: application/json' \
  -d '{"mode":"query","question":"VKS multi-AZ vs private cluster?"}'
# Xem logs
bash runtime.sh logs $RUNTIME_ID --limit 100 --order desc
Lỗi thường gặp
| Triệu chứng | Nguyên nhân thực sự | Fix |
|---|---|---|
| UnicodeDecodeError Vietnamese | Content-Type thiếu charset=utf-8 | Đảm bảo header include charset=utf-8. Browser FileReader.text() OK, vấn đề khi curl từ Windows Git Bash. |
| Gateway 504 timeout | Crawl synchronous vượt 60s | Chuyển sang discover + ingest tách rời (Step 6). Mỗi call <60s. |
| Pages mỏng, self-cite [[X]] lặp | Source HTML nhiều noise | Re-ingest qua Firecrawl onlyMainContent=true + strengthen prompt yêu cầu produce nhiều pages. |
| 400 khi runtime create | Description dùng en-dash (-) | Dùng hyphen (-) thay en-dash. Helm encoding issue. |
| Memory record reject 500 | Page >10KB | Truncate: text[:8000] + "[truncated]". |
| /v1/crawl → 0 URLs | onlyMainContent strip sidebar | Dùng /v1/map - sitemap-based, không bị strip. |
Kết quả & Bước tiếp theo
Kết quả đo được
| Metric | Trước | Sau vllm-wiki Agent v1.0 |
|---|---|---|
| Time-to-info khi có câu hỏi docs | ~15 phút | ~30 giây |
| Số lần mở lại docs trang cũ | Mỗi session | Gần 0 - query wiki thay thế |
| Incident response có dẫn nguồn cụ thể | Không ổn định | 100% có citation [[slug]] |
| Hallucination khi không có runbook | Cao | Gần 0 với knowledge base đầy đủ |
| Thời gian maintain wiki sau mỗi update docs | 30--60 phút/lần | Tự động re-ingest |
3 điểm quan trọng nhất
1. Chất lượng phụ thuộc schema, không phải model size. Mình từng nghĩ phải dùng GPT-4o mới ra wiki "ngon". Nhưng sau khi pin chặt schema và để Firecrawl lo clean content, Gemma 4-31B hoàn toàn đủ - đôi khi còn ổn định hơn vì output ngắn gọn, không "diễn" thêm. Nếu bạn đang băn khoăn chọn model, mình khuyên: pin schema trước, upgrade model sau.
2. /v1/map là thứ tạo ra sự khác biệt. Mình mất gần một buổi chiều debug crawl trả về 0 URL trên docs ai-platform, trước khi nhận ra /v1/crawl bị onlyMainContent strip mất sidebar. Switch sang /v1/map - 50 URL về trong 1.87 giây. Nếu bạn chỉ mang đi đúng 1 điều kỹ thuật từ bài này, hãy mang điều này: docs site có sidebar thì luôn ưu tiên /v1/map.
3. humans curate, LLMs maintain là pattern đúng. Bạn vẫn là người chọn nguồn nào đáng tin, đặt câu hỏi gì, và quyết định wiki nên tiến hóa theo hướng nào. Phần LLM "chán" - cross-reference, update summary, đánh dấu mâu thuẫn - thì để agent làm. Mình nhận ra khi tách rõ hai vai trò này, cả mình lẫn agent đều làm việc tốt hơn: mình bớt làm bookkeeping thủ công, agent bớt cố "tỏ ra thông minh" trong những việc không cần.
Bước tiếp theo
- Lint mode tự động - mình định cho nó chạy mỗi sáng thứ Hai, quét toàn bộ wiki và Slack DM về các page bị lỗi thời (kiểu page còn nói "vLLM 0.5" trong khi 0.8 đã ra). Đang viết, tuần sau xong.
- Slack ingest bot - team mình đang prototype: ai paste link docs vào channel #knowledge, bot tự call ingest, react khi xong. Mục tiêu là wiki "tự lớn" mà không ai phải vào webUI.
- Memex export - mình muốn wiki không bao giờ bị lock vào một platform. Plan: thêm 1 endpoint xuất toàn bộ wiki thành Obsidian vault (markdown files + graph view), để bạn có thể đem đi đâu cũng được.
- Custom embeddings cho tiếng Việt - hiện mình đang dùng BGE-M3 mặc định, semantic search tiếng Việt thuần đôi lúc trượt. Đang định thử vài model Vietnamese-specific (multilingual-e5 fine-tuned) để so kết quả.
Source code + Dockerfile + Helm chart: github.com/[your-org]/vllm-wiki-agent
Nếu bạn còn năng lượng đọc thêm, mình recommend bài Memex (1945) của Vannevar Bush - vision gốc về một personal knowledge store nối với nhau bằng associative trails. Bush viết bài đó từ trước khi có cả Internet, và chờ tới gần 80 năm sau LLM mới đủ năng lực làm phần bookkeeping mà ông tưởng tượng. Đọc xong bạn sẽ thấy vllm-wiki không phải ý tưởng mới - chỉ là một công cụ giúp ý tưởng cũ chạm được thực tế.
P/S nhỏ: bản nháp đầu tiên của bài này được mình viết bên trong chính vllm-wiki - paste vài tab docs vào, ingest, rồi hỏi agent "tóm tắt lại quá trình build". Hơi meta một chút, nhưng đúng là use case đầu tiên mình tự tin nói "agent này đáng dùng": để document quá trình build chính nó.
