
Một trong những rào cản lớn khi doanh nghiệp triển khai AI là khó dự đoán và kiểm soát chi phí sử dụng. Khác với phần mềm mua theo giấy phép cố định, chi phí AI biến đổi theo mức dùng: càng nhiều API call và AI workload, hóa đơn càng tăng – và thường tăng theo cách khó lường. Khi thiếu khả năng theo dõi mức tiêu thụ token theo thời gian thực, doanh nghiệp dễ rơi vào cảnh chi phí phát sinh ngoài dự kiến, chỉ phát hiện khi hóa đơn đã về.
Bài viết này giải thích token ảnh hưởng như thế nào đến chi phí AI, vì sao chi phí khó kiểm soát khi mở rộng và cách GreenNode MaaS theo dõi token theo thời gian thực để giúp doanh nghiệp quản lý chi phí AI minh bạch hơn.
Vì sao chi phí AI thường khó kiểm soát khi mở rộng?
Ở giai đoạn thử nghiệm hoặc pilot, chi phí AI thường tương đối nhỏ và dễ kiểm soát. Tuy nhiên, khi chuyển sang production, doanh nghiệp có thể đồng thời mở rộng số lượng use case, người dùng và đội ngũ sử dụng model.
Một số yếu tố khiến chi phí AI tăng nhanh gồm:
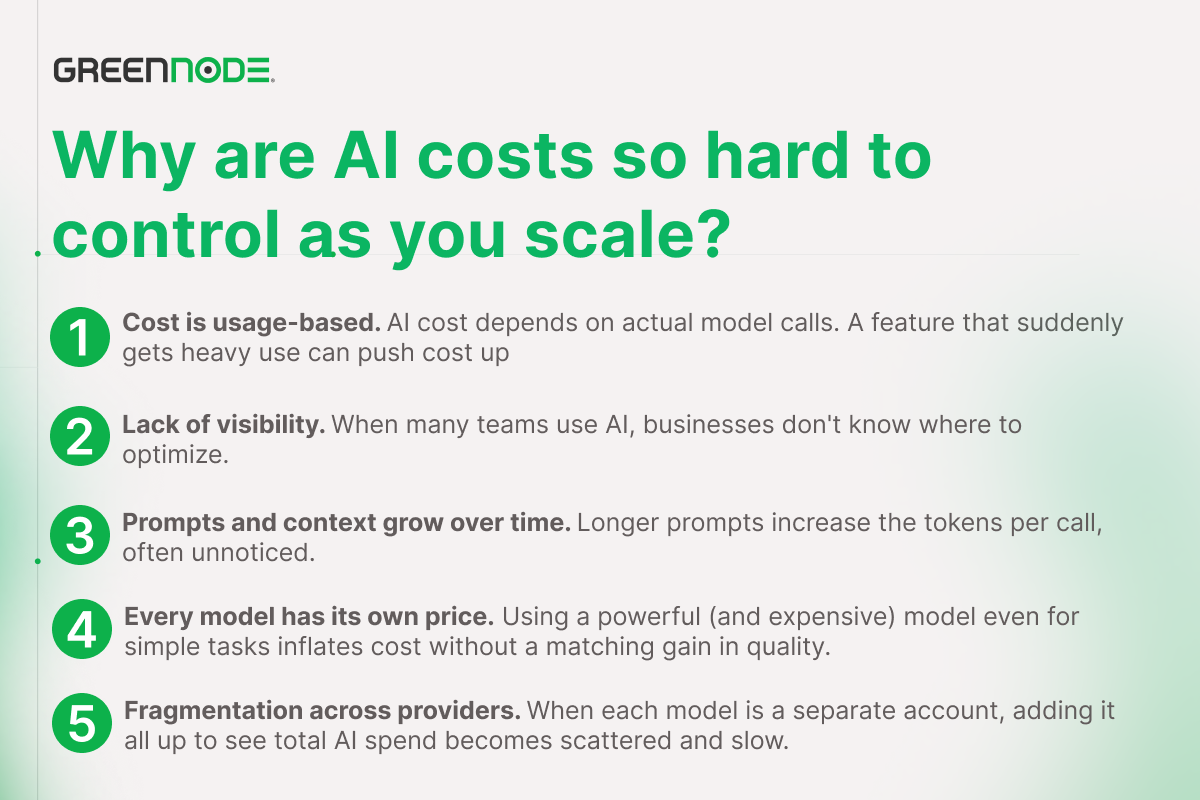
- Chi phí biến đổi theo mức dùng. Không giống giấy phép phần mềm trả cố định hằng năm, chi phí AI phụ thuộc vào lượng gọi model thực tế. Một tính năng đột nhiên được dùng nhiều có thể kéo chi phí lên đáng kể chỉ trong vài ngày.
- Thiếu khả năng nhìn xuyên (visibility). Khi nhiều nhóm cùng dùng AI, doanh nghiệp thường không biết use case nào, đội nào hay model nào đang tiêu tốn nhiều nhất – nên không biết nên tối ưu ở đâu.
- Prompt và ngữ cảnh phình to theo thời gian. Prompt dài thêm, đính kèm nhiều tài liệu (RAG), giữ lịch sử hội thoại… đều làm tăng lượng token cho mỗi lần gọi mà ít khi được để ý.
- Mỗi model một mức giá. Dùng model mạnh (và đắt) cho cả những tác vụ đơn giản khiến chi phí đội lên mà chất lượng không cải thiện tương xứng.
- Phân mảnh qua nhiều nhà cung cấp. Khi mỗi model là một tài khoản, một hóa đơn riêng, việc cộng gộp để nhìn tổng chi phí AI của doanh nghiệp trở nên rời rạc và chậm.
Hệ quả quen thuộc là "bill shock" – hóa đơn cuối kỳ cao hơn nhiều so với dự tính, trong khi đội ngũ không có dữ liệu để giải thích vì sao. Với ban lãnh đạo, đây là rủi ro thật: khó lập ngân sách AI, khó dự báo và khó ra quyết định mở rộng.
Token ảnh hưởng như thế nào đến chi phí sử dụng AI?
Với hầu hết mô hình ngôn ngữ, token là đơn vị tính chi phí. Token là những mảnh nhỏ của văn bản (một từ tiếng Anh thường tương ứng khoảng 1–2 token; tiếng Việt có dấu thường tốn nhiều token hơn cho cùng độ dài). Mỗi lần gọi model, chi phí được tính trên tổng số token, gồm hai phần:
- Token đầu vào (input): toàn bộ nội dung bạn gửi cho model – câu hỏi của người dùng, prompt hệ thống, tài liệu đính kèm, lịch sử hội thoại.
- Token đầu ra (output): nội dung model sinh ra để trả về.
Vì thế, cùng một tính năng nhưng chi phí mỗi lần gọi có thể rất khác nhau, tùy vào các yếu tố:
- Độ dài prompt và ngữ cảnh. Prompt càng dài, càng nhiều tài liệu nhồi vào (RAG), càng nhiều token đầu vào.
- Lịch sử hội thoại. Chatbot giữ càng nhiều lượt trò chuyện trước đó thì mỗi lượt mới càng "cõng" thêm token cũ.
- Độ dài đầu ra. Yêu cầu model viết dài, liệt kê chi tiết sẽ tốn nhiều token đầu ra hơn.
- Loại model. Model lớn, model suy luận (reasoning) hay xử lý đa phương thức thường có đơn giá token cao hơn.
Nói cách khác, chi phí AI chính là token nhân với đơn giá, cộng dồn qua hàng nghìn, hàng triệu lượt gọi. Muốn kiểm soát chi phí, trước hết doanh nghiệp phải nhìn thấy được token: dùng bao nhiêu, ở đâu, cho việc gì. Đó là lý do khả năng theo dõi token theo thời gian thực trở thành nền tảng của mọi nỗ lực quản lý chi phí AI.
GreenNode MaaS giúp theo dõi token và chi phí theo thời gian thực như thế nào?
GreenNode MaaS kiểm soát chi phí ở hai thời điểm: ước lượng trước khi triển khai – dựa trên thông số kỹ thuật công khai của từng model trên portal – và theo dõi mức sử dụng trong quá trình vận hành bằng cơ chế real-time token tracking. Hai lớp này khớp trực tiếp với các yếu tố làm phát sinh token đã nói ở phần trên.
Trước khi gọi model: kiểm tra thông số của từng model trên portal
Mỗi model trên portal của GreenNode MaaS đều công khai bộ thông số quyết định trực tiếp đến lượng token của mỗi request. Thay vì đoán, đội kỹ thuật tra ngay các trường này trước khi tích hợp, và ánh xạ từng yếu tố chi phí sang một thông số cụ thể:
| Thông số trên portal | Ý nghĩa | Liên quan đến chi phí / công suất |
|---|---|---|
| Modalities | Các loại dữ liệu vào–ra model hỗ trợ (văn bản, ảnh, video, giọng nói…) | Xử lý đa phương thức thường tốn nhiều token hơn văn bản thuần |
| Max input | Số token tối đa cho phần đầu vào của một request | Trần chi phí đầu vào mỗi lần gọi; giúp căn ngân sách cho prompt + tài liệu RAG |
| Max output | Số token tối đa model sinh ra cho một phản hồi | Chặn trần phần token đầu ra – thường có đơn giá cao hơn đầu vào |
| Context length | Tổng token model xử lý được trong một lượt (đầu vào + hội thoại) | Cửa sổ càng lớn, dư địa nhồi token càng nhiều → chi phí tiềm năng mỗi lượt càng cao |
| Default TPM | Số token xử lý tối đa mỗi phút (tokens per minute) | Dự báo throughput và độ "co giãn" chi phí khi tải tăng |
| Default RPM | Số request tối đa mỗi phút (requests per minute) | Lập kế hoạch công suất, tránh nghẽn khi nhiều người dùng cùng gọi |
Ví dụ, một model trên portal có thể hiển thị: Max input 1M token, Max output 128K token, Context length 1.000.000 token, Default TPM 2.000.000, Default RPM 10 (giới hạn mặc định ở cấp tài khoản là 10 RPM và 14.400 request/ngày, dùng chung cho mọi model – các con số cụ thể thay đổi theo từng model, hãy xem trực tiếp trên portal).
Nhờ vậy, ngay từ khâu thiết kế, đội ngũ đã ước lượng được: một request "nặng" nhất tốn tối đa bao nhiêu token đầu vào và đầu ra, cửa sổ ngữ cảnh có đủ cho bài toán (ví dụ tóm tắt tài liệu dài, RAG) hay không, và throughput mỗi phút có đáp ứng lượng người dùng dự kiến không – tất cả trước khi phát sinh đồng chi phí nào.
Trong thời gian triển khai: theo dõi token và chi phí theo thời gian thực
Nền tảng được xây trên cơ chế pay-per-token minh bạch: bạn chỉ trả cho lượng token thực sự dùng, không phí thuê bao cố định, không phí ẩn. Quan trọng hơn, nó cho phép theo dõi và kiểm soát mức sử dụng AI theo thời gian thực cho cả văn bản và giọng nói, mang lại khả năng nhìn xuyên toàn diện về mức dùng và chi phí – loại bỏ chuyện "đoán mò" hóa đơn:
- Theo dõi token và chi phí real-time. Doanh nghiệp thấy mức tiêu thụ token và chi phí cập nhật liên tục, thay vì chờ đến cuối kỳ. Xu hướng sử dụng bất thường (một use case đột nhiên "ngốn" token, chạm trần TPM…) được phát hiện sớm, khi còn kịp xử lý.
- Đối chiếu với thông số đã đọc trên portal. Vì đã biết trần max input/output và TPM của từng model, đội ngũ so sánh được mức tiêu thụ thực tế với dự toán ban đầu – và biết ngay khi một request phình token vượt kỳ vọng.
- Minh bạch, không phí ẩn. Cơ chế tính token rõ ràng cho từng lượt gọi, nên chi phí luôn truy vết được về đúng nơi phát sinh – không có khoản phụ thu bất ngờ.
- Ước lượng chi phí ngay từ khâu thử nghiệm. Ngay trên no-code Playground, bạn thấy chi phí theo token của từng model trong lúc test, nên có thể so sánh và dự toán trước khi đưa vào production.
- Một API, một nơi quản lý chi phí. Vì mọi model dùng chung một API thống nhất, chi phí AI của nhiều model được gom về một chỗ để theo dõi, thay vì rải rác qua nhiều tài khoản và nhiều hóa đơn nhà cung cấp.
- Gắn với quyền chọn model và vùng triển khai. Doanh nghiệp thấy rõ mỗi model là self-host hay third-party và chọn vùng triển khai phù hợp – kiểm soát cả chi phí lẫn chủ quyền dữ liệu trên cùng một nền tảng.
Với ban lãnh đạo, điều này biến chi phí AI từ một con số "đến cuối tháng mới biết" thành một chỉ số có thể ước lượng từ trước (qua thông số model), theo dõi liên tục khi chạy, và đưa vào kế hoạch ngân sách như bất kỳ khoản chi vận hành nào khác.
Làm thế nào để tối ưu chi phí AI mà vẫn đảm bảo hiệu quả?
Kiểm soát chi phí không có nghĩa là dùng ít AI đi, mà là dùng đúng chỗ, đúng mức. Khi đã nhìn rõ token, doanh nghiệp có thể tối ưu theo vài hướng thực tế:
- Chọn đúng model cho đúng workload. Dùng model nhỏ, nhanh, rẻ cho các tác vụ đơn giản và số lượng lớn; để dành model mạnh cho tác vụ thật sự cần. (Xem thêm: cách chọn AI model phù hợp cho từng bài toán.)
- Tinh gọn prompt và ngữ cảnh. Cắt bớt phần thừa trong prompt, chỉ đưa vào ngữ cảnh những tài liệu thật sự cần cho câu hỏi, giới hạn lịch sử hội thoại ở mức hợp lý – mỗi token tiết kiệm được đều nhân lên theo số lượt gọi.
- Kiểm soát độ dài đầu ra. Đặt giới hạn độ dài phản hồi cho những tác vụ không cần câu trả lời dài.
- Thử nghiệm và đo trước khi mở rộng. Dùng Playground để đo chi phí trên dữ liệu thật trước khi bật cho toàn bộ người dùng, tránh bất ngờ khi lên quy mô.
- Theo dõi định kỳ theo mức dùng thực. Nhìn dữ liệu token theo thời gian thực để biết use case nào đang tăng nhanh, từ đó điều chỉnh model hoặc prompt kịp thời thay vì chờ hóa đơn.
Điểm mấu chốt: tối ưu chi phí AI là một quá trình liên tục dựa trên dữ liệu, chứ không phải một lần cắt giảm. Khả năng theo dõi token theo thời gian thực chính là nguồn dữ liệu để quá trình đó diễn ra.
Khi nào doanh nghiệp nên sử dụng real-time token tracking?
Theo dõi token theo thời gian thực đặc biệt có giá trị khi:
- Bạn đang mở rộng AI ra nhiều use case và nhiều đội ngũ, và cần biết chi phí đến từ đâu để phân bổ và tối ưu.
- Ban lãnh đạo cần dự toán ngân sách AI và một chỉ số chi phí có thể theo dõi, dự báo được cho kế hoạch tài chính.
- Bạn dùng nhiều model khác nhau và muốn gom chi phí về một nơi thay vì cộng thủ công từ nhiều nhà cung cấp.
- Bạn chuyển từ pilot sang production, khi lưu lượng thật bắt đầu tăng và rủi ro "bill shock" trở nên đáng kể.
- Doanh nghiệp trong ngành có yêu cầu kiểm soát chi phí và tuân thủ chặt – tài chính, ngân hàng, bảo hiểm – nơi mọi khoản chi đều cần minh bạch và truy vết được.
Nếu doanh nghiệp của bạn đang ở giai đoạn đưa AI vào vận hành thật và bắt đầu lo về chi phí khi mở rộng, khả năng theo dõi token theo thời gian thực là công cụ để mở rộng một cách tự tin – nhìn rõ từng đồng chi cho AI, tối ưu liên tục và ra quyết định có cơ sở.
Nếu bạn muốn hiểu tổng quan về mô hình cung cấp AI này trước, xem thêm bài Model as a Service (MaaS) là gì.
Liên hệ GreenNode để được tư vấn về Model as a Service và xem cách theo dõi chi phí AI theo thời gian thực cho chính doanh nghiệp bạn.
Câu hỏi thường gặp
Token là gì và vì sao nó quyết định chi phí AI?
Token là đơn vị nhỏ của văn bản mà mô hình ngôn ngữ xử lý. Chi phí mỗi lần gọi model được tính trên tổng token đầu vào và đầu ra, nhân với đơn giá của model. Vì vậy, kiểm soát chi phí AI thực chất là kiểm soát lượng token tiêu thụ.
GreenNode MaaS tính chi phí như thế nào?
Theo cơ chế pay-per-token: bạn chỉ trả cho lượng token thực sự dùng, minh bạch theo từng lượt gọi, không phí thuê bao cố định và không phí ẩn.
Theo dõi token theo thời gian thực nghĩa là gì?
Là khả năng nhìn thấy mức tiêu thụ token và chi phí cập nhật liên tục ngay khi phát sinh, thay vì chờ đến cuối kỳ. Điều này giúp phát hiện sớm mức dùng bất thường và kiểm soát ngân sách chủ động.
Làm sao để giảm chi phí AI mà không giảm chất lượng?
Chọn đúng model cho từng workload, tinh gọn prompt và ngữ cảnh, giới hạn độ dài đầu ra khi không cần, và đo chi phí trên dữ liệu thật ở Playground trước khi mở rộng. Theo dõi token theo thời gian thực cung cấp dữ liệu để tối ưu liên tục.
