
Triển khai mô hình machine learning chính là cầu nối giữa giai đoạn thử nghiệm và giai đoạn vận hành thực tế. Đây là bước mà data science gặp gỡ kỹ thuật hệ thống, nơi các mô hình rời khỏi Jupyter notebook để bắt đầu phục vụ người dùng ở quy mô lớn. Dù là gợi ý sản phẩm, phát hiện gian lận hay tự động hóa vận hành, việc triển khai thành công giúp machine learning tạo ra kết quả đo lường được, chứ không chỉ dừng lại ở các cột mốc nghiên cứu.
Trong bài viết này, chúng ta sẽ tìm hiểu triển khai mô hình thực chất là gì, cách triển khai mô hình machine learning, và các xu hướng tương lai giúp mô hình machine learning vận hành ổn định và hiệu quả trong môi trường production.
Tổng quan về mô hình Machine Learning
Mô hình machine learning là gì?
Mô hình machine learning là một biểu diễn toán học học các quy luật từ dữ liệu để đưa ra dự đoán hoặc quyết định mà không cần lập trình tường minh. Thay vì tuân theo các quy tắc cố định, mô hình thích nghi bằng cách phân tích ví dụ và khám phá mối quan hệ giữa các đặc trưng đầu vào và kết quả đầu ra.
Theo Microsoft, đây là "một đối tượng đã được huấn luyện để nhận diện một số loại quy luật nhất định", còn IBM định nghĩa nó là hệ thống "học các quy luật từ dữ liệu huấn luyện và từ đó đưa ra suy luận chính xác về dữ liệu mới".
Nói cách khác, mô hình machine learning là sản phẩm của quá trình huấn luyện một thuật toán trên dữ liệu thực tế. Sau khi được huấn luyện, mô hình có thể nhận diện xu hướng, phân loại thông tin, phát hiện bất thường và tự động đưa ra các dự đoán đáng tin cậy.
Mô hình machine learning hiện là nền tảng của các hệ thống AI hiện đại. Chúng vận hành mọi thứ từ nhận diện giọng nói, hệ thống gợi ý, đến phát hiện gian lận và xe tự hành. Dù là phân loại (nhận diện email spam), hồi quy (dự báo doanh số) hay phân cụm (nhóm khách hàng tương đồng), mọi mô hình đều tuân theo một nguyên tắc chung: học từ dữ liệu quá khứ để đưa ra dự đoán có căn cứ cho dữ liệu tương lai hoặc chưa từng gặp.
Đọc thêm: Huấn luyện mô hình AI là gì?
Ví dụ về mô hình Machine Learning
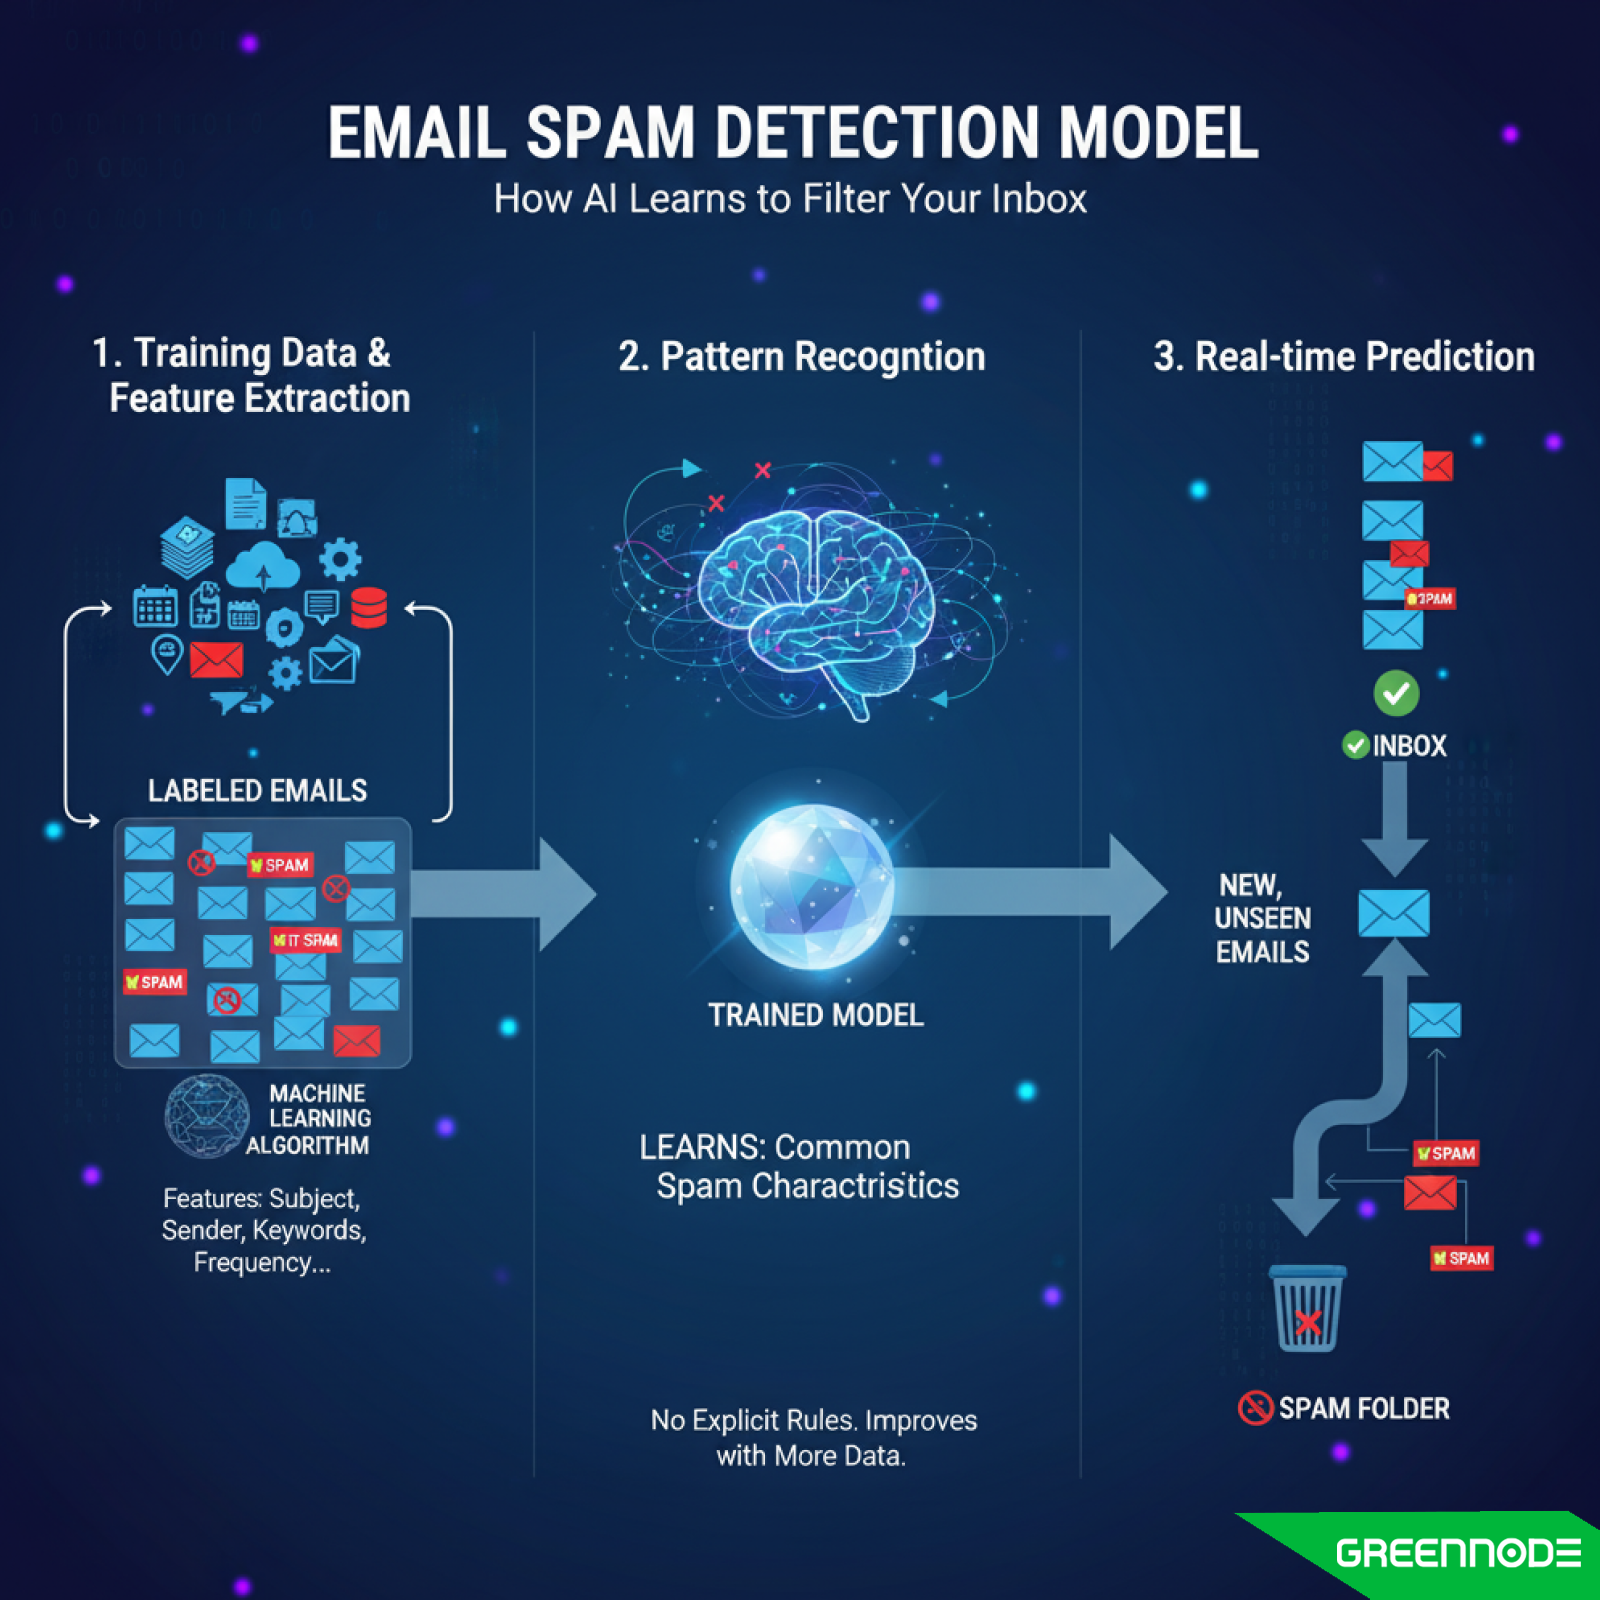
Để hiểu cách mô hình machine learning hoạt động trong thực tế, hãy xem xét trường hợp mô hình phát hiện thư rác được các dịch vụ email sử dụng. Kỹ sư đưa vào mô hình hàng nghìn email đã được gán nhãn, một số được đánh dấu là "spam", số khác là "không phải spam". Mỗi email bao gồm các đặc trưng như tiêu đề, địa chỉ người gửi, từ khóa và tần suất gửi tin. Mô hình phân tích các ví dụ này để học ra đặc điểm chung của thư rác.
Sau khi được huấn luyện, mô hình có thể đánh giá các email mới, chưa từng thấy trước đó và dự đoán liệu chúng có phải là spam hay không. Mô hình thực hiện điều này bằng cách áp dụng các quy luật đã học, không cần lập trình theo quy tắc tường minh. Dữ liệu xử lý càng nhiều, dự đoán càng chính xác.
Một ví dụ phổ biến khác là mô hình gợi ý sản phẩm trong thương mại điện tử. Ở đây, mô hình học từ dữ liệu lịch sử của khách hàng như lịch sử mua hàng, hành vi duyệt web, mức độ tương đồng giữa các sản phẩm, để dự đoán khách hàng có khả năng mua gì tiếp theo. Khi bạn thấy mục "Có thể bạn cũng thích..." trên một trang thương mại điện tử, đó chính là mô hình machine learning đang hoạt động, cá nhân hóa trải nghiệm theo thời gian thực.
Từ phát hiện gian lận thẻ tín dụng, tối ưu chuỗi cung ứng, đến dự đoán chẩn đoán y tế, mô hình machine learning biến dữ liệu thành thông tin có thể hành động. Chúng không chỉ tự động hóa tác vụ, mà còn giúp hệ thống học hỏi, thích nghi và liên tục cải thiện theo thời gian.
Các loại mô hình Machine Learning
Có nhiều cách để phân loại mô hình machine learning, nhưng phần lớn thuộc về năm nhóm chính, mỗi nhóm phù hợp với một dạng bài toán và mục tiêu học khác nhau:
- Mô hình học có giám sát (Supervised Learning)
- Mô hình học không giám sát (Unsupervised Learning)
- Mô hình học tăng cường (Reinforcement Learning)
- Deep Learning / Mạng nơ-ron
- Mô hình kết hợp (Ensemble & Hybrid)
Hiểu rõ các nhóm này giúp xác định cách huấn luyện và ứng dụng mô hình hiệu quả.
Mô hình học có giám sát (Supervised Learning)
Trong học có giám sát, mô hình được huấn luyện bằng dữ liệu đã gán nhãn, nghĩa là mỗi ví dụ huấn luyện đều gồm cả đầu vào và đầu ra chính xác tương ứng. Mô hình học được ánh xạ giữa hai yếu tố này, từ đó dự đoán kết quả cho dữ liệu chưa từng gặp.
Mô hình học có giám sát được sử dụng rộng rãi cho:
- Bài toán hồi quy, dự đoán các giá trị liên tục (ví dụ: dự báo doanh số hoặc nhiệt độ).
- Bài toán phân loại, gán dữ liệu vào các nhóm rời rạc (ví dụ: phát hiện email spam hoặc chẩn đoán tình trạng y tế).
Các thuật toán phổ biến gồm Linear Regression, Logistic Regression, Decision Trees, Random Forests và Support Vector Machines (SVM). Học có giám sát vẫn là nền tảng của phần lớn hệ thống machine learning trong thực tế vì dễ đo lường và kiểm chứng hiệu năng mô hình.
Mô hình học không giám sát (Unsupervised Learning)
Học không giám sát xử lý dữ liệu chưa gán nhãn, mô hình phải tự khám phá các quy luật hoặc nhóm ẩn mà không có đáp án định trước. Nhóm mô hình này rất hữu ích khi khám phá mối quan hệ trong các tập dữ liệu phức tạp hoặc chưa được hiểu rõ.
Các phương pháp tiêu biểu gồm:
- Phân cụm (Clustering), nhóm các điểm dữ liệu theo mức độ tương đồng (ví dụ: phân khúc khách hàng theo hành vi bằng K-Means hoặc DBSCAN).
- Giảm chiều dữ liệu (Dimensionality Reduction), đơn giản hóa dữ liệu nhiều chiều thành các đặc trưng chính (ví dụ: dùng PCA hoặc t-SNE để trực quan hóa).
Học không giám sát thường được dùng trong khám phá dữ liệu, phát hiện bất thường, hệ thống gợi ý và trích xuất đặc trưng trước khi huấn luyện có giám sát.
Mô hình học tăng cường (Reinforcement Learning)
Học tăng cường (RL) dựa trên tương tác và phản hồi. Thay vì được cho biết đáp án đúng, một agent RL học thông qua thử và sai, nhận thưởng cho hành động tốt và bị phạt cho hành động chưa tốt. Theo thời gian, agent học được chiến lược tối ưu hóa phần thưởng tích lũy.
Cách tiếp cận này phù hợp với các bài toán ra quyết định tuần tự, như robot học, chơi game (ví dụ AlphaGo), xe tự hành và tối ưu hóa tài nguyên. Các thuật toán như Q-Learning, Deep Q-Networks (DQN) và Policy Gradient nằm trong số những phương pháp phổ biến nhất của lĩnh vực này.
Deep Learning / Mạng nơ-ron
Deep learning là một nhánh của machine learning lấy cảm hứng từ cách bộ não con người xử lý thông tin. Các mô hình này sử dụng mạng nơ-ron nhân tạo (ANN) gồm nhiều lớp, học được các mối quan hệ phức tạp, phi tuyến tính từ khối lượng dữ liệu lớn.
Các kiến trúc quan trọng gồm:
- Convolutional Neural Networks (CNN) – dùng cho xử lý hình ảnh và thị giác máy tính.
- Recurrent Neural Networks (RNN) và LSTM – dùng cho dữ liệu tuần tự như giọng nói và văn bản.
- Transformer – dùng cho xử lý ngôn ngữ tự nhiên và các mô hình ngôn ngữ lớn (LLM) làm nền tảng cho generative AI.
Deep learning tạo ra những bước đột phá trong thị giác máy tính, nhận diện giọng nói, dịch thuật và tạo sinh nội dung, nhưng đòi hỏi nguồn lực tính toán và khối lượng dữ liệu lớn.
Mô hình kết hợp (Ensemble & Hybrid)
Học kết hợp (ensemble learning) kết hợp nhiều mô hình machine learning để cải thiện độ chính xác dự đoán và tính ổn định. Thay vì chỉ dựa vào một thuật toán duy nhất, phương pháp ensemble tổng hợp kết quả từ nhiều mô hình để giảm bias và variance.
Các kỹ thuật ensemble phổ biến gồm:
- Bagging (ví dụ: Random Forests) – huấn luyện các mô hình độc lập rồi lấy trung bình kết quả.
- Boosting (ví dụ: XGBoost, AdaBoost) – huấn luyện tuần tự các mô hình để sửa lỗi của mô hình trước.
- Stacking – kết hợp nhiều loại mô hình khác nhau để tạo ra một meta-learner cho dự đoán cuối cùng.
Mô hình hybrid mở rộng ý tưởng này bằng cách kết hợp machine learning và deep learning, hoặc kết hợp các thành phần có giám sát và không giám sát để đạt khả năng tổng quát hóa và diễn giải tốt hơn.
Mỗi loại mô hình machine learning phục vụ một mục đích khác nhau: mô hình có giám sát học từ các ví dụ đã biết, mô hình không giám sát khám phá cấu trúc ẩn, mô hình học tăng cường thích nghi qua phản hồi, deep learning nắm bắt các quy luật phức tạp, còn mô hình kết hợp tận dụng ưu điểm của nhiều phương pháp để đạt độ chính xác cao hơn.
Cách triển khai mô hình Machine Learning
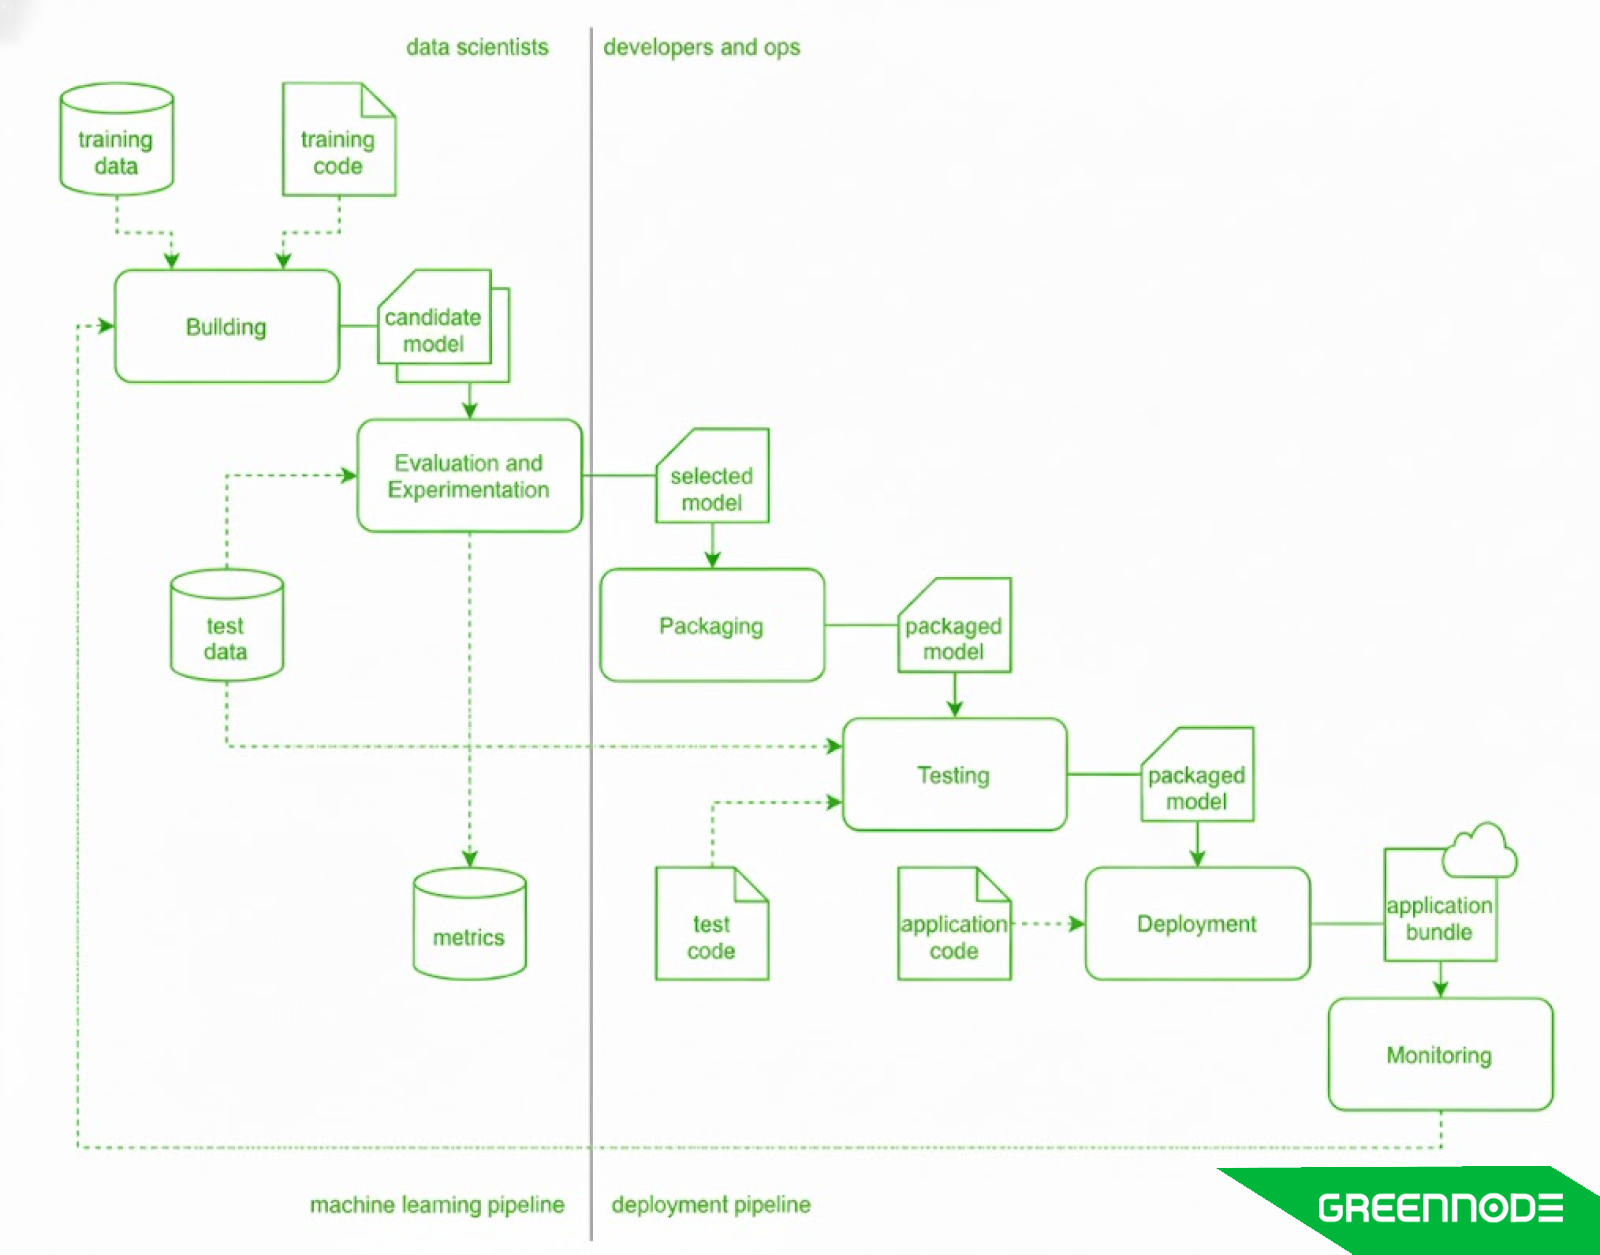
Sau khi một mô hình machine learning được huấn luyện và kiểm định, bước tiếp theo là triển khai, tức quá trình tích hợp mô hình vào môi trường production để tạo ra dự đoán trong các ứng dụng thực tế. Triển khai chính là cầu nối giữa phát triển và tác động kinh doanh, biến một mô hình từ thí nghiệm nghiên cứu thành giải pháp có thể sử dụng, hỗ trợ ra quyết định, tự động hóa tác vụ hoặc vận hành các sản phẩm thông minh.
Cách triển khai mô hình machine learning có thể khác nhau tùy hạ tầng, use case và yêu cầu hiệu năng, nhưng các bước cơ bản vẫn tương đối giống nhau giữa các tổ chức. Dưới đây là các bước chính khi triển khai mô hình machine learning:
- Chuẩn bị và đóng gói mô hình
- Lựa chọn chiến lược triển khai
- Tích hợp với ứng dụng hoặc API
- Giám sát hiệu năng mô hình trong production
- Tự động hóa với MLOps pipeline
- Đảm bảo quản trị, bảo mật và tuân thủ
Chuẩn bị và đóng gói mô hình
Trước khi triển khai, mô hình cần được đóng gói đúng cách để có thể tái sử dụng. Điều này bao gồm lưu mô hình đã huấn luyện cùng các thành phần phụ thuộc (thư viện, cấu hình, mã tiền xử lý) theo một định dạng nhất quán như ONNX, TensorFlow SavedModel hoặc Pickle đối với mô hình dùng Python.
Nhiều đội ngũ sử dụng các công cụ quản lý phiên bản như MLflow, DVC hoặc Weights & Biases để theo dõi thử nghiệm, quản lý phiên bản mô hình và đảm bảo khả năng tái lập kết quả. Các công cụ containerization như Docker giúp đóng gói mô hình cùng môi trường runtime dễ dàng hơn, để mô hình có thể chạy ổn định trên nhiều máy chủ hoặc môi trường cloud khác nhau.
Lựa chọn chiến lược triển khai
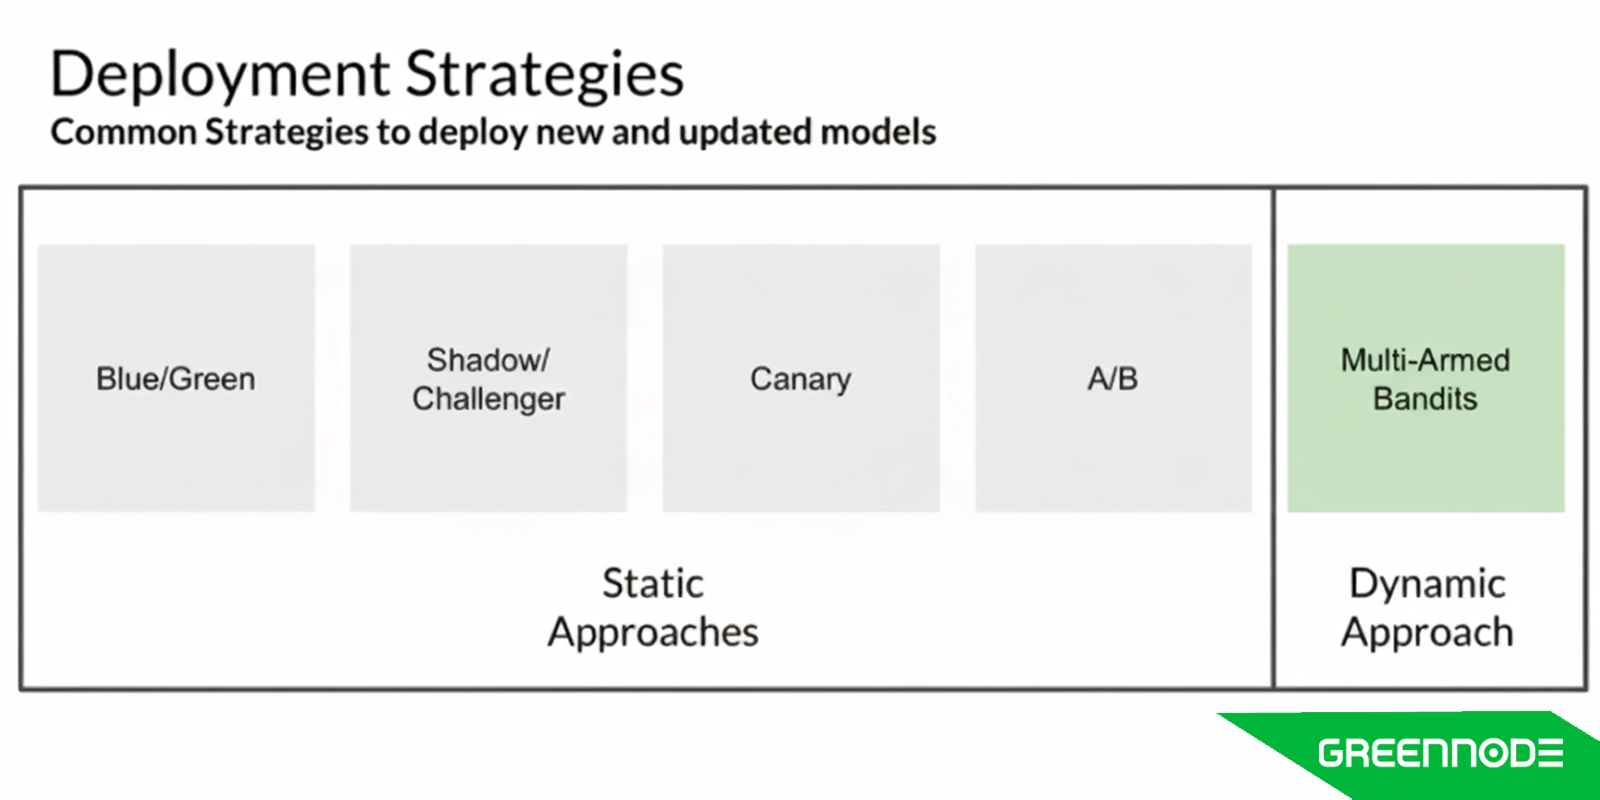
Cách tiếp cận triển khai phụ thuộc vào cách dự đoán cần được phục vụ. Có ba chiến lược chính:
- Suy luận theo lô (Batch inference): Mô hình xử lý khối lượng dữ liệu lớn theo các khoảng thời gian định sẵn. Thường gặp trong hệ thống phân tích hoặc báo cáo (ví dụ: dự đoán tỷ lệ rời bỏ hằng tuần).
- Suy luận trực tuyến (thời gian thực): Mô hình phục vụ dự đoán tức thì qua API hoặc web service, phù hợp cho phát hiện gian lận, hệ thống gợi ý và chatbot.
- Triển khai tại biên (Edge deployment): Mô hình chạy trực tiếp trên thiết bị như smartphone, cảm biến IoT hoặc hệ thống nhúng, giúp giảm độ trễ và băng thông sử dụng.
Việc lựa chọn cách tiếp cận phù hợp phụ thuộc vào tốc độ dữ liệu, yêu cầu độ trễ và ràng buộc chi phí.
Tích hợp với ứng dụng hoặc API
Sau khi đóng gói, mô hình cần được kết nối với ứng dụng sẽ sử dụng kết quả dự đoán. Thông thường, việc này được thực hiện qua API (Application Programming Interface). Các framework như TensorFlow Serving, TorchServe hoặc FastAPI cho phép triển khai mô hình dưới dạng REST endpoint.
Việc tích hợp này giúp ứng dụng gửi dữ liệu đầu vào (như hồ sơ người dùng hoặc chi tiết giao dịch) và nhận về dự đoán (như xác suất gian lận hoặc gợi ý sản phẩm) theo thời gian thực. Với các hệ thống quy mô lớn, lớp API này thường nằm sau một load balancer hoặc gateway để đảm bảo khả năng mở rộng và chịu lỗi.
Giám sát hiệu năng mô hình trong production
Mô hình có thể suy giảm hiệu năng theo thời gian khi quy luật dữ liệu thay đổi, hiện tượng này được gọi là model drift. Để duy trì độ chính xác và độ tin cậy, tổ chức cần liên tục giám sát các chỉ số quan trọng như độ chính xác dự đoán, độ trễ và mức sử dụng tài nguyên.
Các công cụ như Evidently AI, WhyLabs và Prometheus có thể theo dõi tình trạng mô hình và cảnh báo đội ngũ khi hiệu năng suy giảm. Các pipeline huấn luyện lại định kỳ, thường được điều phối bằng Kubeflow, Airflow hoặc Prefect, giúp mô hình luôn bám sát xu hướng dữ liệu hiện tại.
Tự động hóa với MLOps pipeline
Để mở rộng quy mô triển khai hiệu quả, nhiều tổ chức áp dụng MLOps (Machine Learning Operations) - một phương pháp kết hợp thực hành DevOps với quy trình machine learning. MLOps giúp tự động hóa toàn bộ vòng đời: tiền xử lý dữ liệu, huấn luyện mô hình, kiểm định, triển khai và giám sát.
Đảm bảo quản trị, bảo mật và tuân thủ
Khi mô hình machine learning trở thành trung tâm của hoạt động kinh doanh, quản trị và tuân thủ là yếu tố then chốt.
Mô hình sau khi triển khai cần tuân thủ các chính sách của tổ chức và khung pháp lý như GDPR, HIPAA, hoặc Nghị định bảo vệ dữ liệu cá nhân (PDPD) của Việt Nam.
Các thực hành tốt nhất bao gồm:
- Áp dụng kiểm soát truy cập theo vai trò (RBAC) và nhật ký kiểm toán.
- Bảo mật các pipeline dữ liệu bằng mã hóa khi truyền và khi lưu trữ.
- Triển khai các công cụ phát hiện bias và khả năng diễn giải để đảm bảo quyết định AI có đạo đức.
- Quản trị đúng cách không chỉ bảo vệ dữ liệu nhạy cảm mà còn xây dựng niềm tin vào kết quả do AI tạo ra.
Triển khai mô hình machine learning là giai đoạn mà sự đổi mới chuyển hóa thành tác động thực tế. Nó bao gồm đóng gói, phục vụ, giám sát và mở rộng mô hình để đảm bảo kết quả ổn định trong điều kiện thực tế. Dù triển khai qua API, batch pipeline hay thiết bị edge, thành công phụ thuộc vào độ tin cậy, khả năng tự động hóa và giám sát liên tục.
Đọc thêm: Từ Zero đến Hero: Hướng dẫn từng bước Fine-Tuning LLaMA 3 trên GreenNode
Xu hướng tương lai của mô hình Machine Learning
Sự phát triển của mô hình machine learning tiếp tục tăng tốc khi các kỹ thuật, công cụ và kiến trúc mới liên tục mở rộng giới hạn của những gì hệ thống AI có thể đạt được. Từ năm 2025 trở đi, trọng tâm đang dịch chuyển từ việc xây dựng các mô hình đơn lẻ sang phát triển các hệ thống AI có khả năng mở rộng, thích nghi và vận hành có trách nhiệm, học liên tục và hoạt động trên nhiều môi trường khác nhau. Dưới đây là một số xu hướng quan trọng nhất định hình thế hệ machine learning tiếp theo.
Foundation Model và mô hình huấn luyện sẵn
Các mô hình huấn luyện sẵn quy mô lớn, thường được gọi là foundation model, đang định hình lại bức tranh machine learning. Thay vì huấn luyện từ đầu, các nhà phát triển hiện fine-tune các mô hình huấn luyện sẵn quy mô lớn cho từng lĩnh vực hoặc ngôn ngữ cụ thể. Cách tiếp cận này giảm đáng kể chi phí huấn luyện và cải thiện hiệu năng chỉ với lượng dữ liệu gán nhãn tối thiểu.
Các tổ chức ngày càng áp dụng những foundation model này làm nền tảng cho hệ thống AI của mình, sử dụng cho mọi việc từ tóm tắt tài liệu đến suy luận đa phương thức. Có thể kỳ vọng các mô hình này sẽ ngày càng chuyên biệt hóa theo từng ngành như tài chính, y tế, giáo dục và an ninh mạng, nơi khả năng thích nghi theo lĩnh vực trở thành yếu tố khác biệt quan trọng.
Đọc thêm: Machine Learning trong Y tế: Ứng dụng, lợi ích và tác động thực tế
AutoML và phát triển mô hình Low-Code
Sự phát triển của Automated Machine Learning (AutoML) và các công cụ low-code/no-code đang giúp việc xây dựng mô hình trở nên dễ tiếp cận hơn. Bằng cách tự động hóa feature engineering, tinh chỉnh hyperparameter và lựa chọn mô hình, AutoML rút ngắn thời gian phát triển và mở rộng khả năng áp dụng AI cho các tổ chức vừa và nhỏ. Nhờ đó, machine learning dần ít phụ thuộc vào kỹ năng lập trình hơn mà tập trung nhiều hơn vào việc giải quyết vấn đề, giúp đổi mới dựa trên dữ liệu trở nên khả thi với mọi bộ phận trong doanh nghiệp.
Edge và Federated Learning
Khi số lượng thiết bị kết nối ngày càng tăng, nhiều mô hình machine learning được triển khai ngay tại biên, trực tiếp trên smartphone, cảm biến và thiết bị IoT. Edge AI cho phép suy luận thời gian thực với độ trễ tối thiểu, vận hành các ứng dụng như xe tự hành, giám sát công nghiệp và chẩn đoán y tế.
Song song đó, federated learning cho phép các mô hình huấn luyện phối hợp trên nhiều nguồn dữ liệu phân tán mà không cần tập trung thông tin nhạy cảm về một nơi. Điều này tăng cường tính riêng tư và khả năng tuân thủ, đồng thời giúp tổ chức tận dụng được các tập dữ liệu phân tán để xây dựng AI thông minh và an toàn hơn.
Cùng nhau, các xu hướng này giúp machine learning nhanh hơn, hiệu quả hơn và chú trọng quyền riêng tư hơn, điều gần như bắt buộc trong các môi trường chịu sự quản lý chặt chẽ về dữ liệu.
AI có thể diễn giải và có trách nhiệm
Khi machine learning ngày càng chi phối các quyết định kinh doanh và xã hội quan trọng, khả năng diễn giải và đạo đức không còn là lựa chọn tùy chọn. Các mô hình trong tương lai cần có khả năng diễn giải được, giúp các bên liên quan hiểu vì sao mô hình đưa ra một dự đoán cụ thể.
Các kỹ thuật như SHAP, LIME và integrated gradients đang trở thành công cụ tiêu chuẩn để tăng tính minh bạch của mô hình. Đồng thời, các tổ chức đang tích hợp kiểm toán tính công bằng, phát hiện bias và khung quản trị vào pipeline ML để đáp ứng các tiêu chuẩn tuân thủ và xây dựng niềm tin công chúng.
AI có trách nhiệm sẽ trở thành lợi thế cạnh tranh, khi khách hàng và cơ quan quản lý ngày càng yêu cầu tính minh bạch cao hơn trong các quyết định được tự động hóa.
Mô hình đa phương thức và học liên tục
Các mô hình truyền thống thường chỉ được huấn luyện cho một tác vụ hoặc một loại dữ liệu duy nhất, nhưng thế hệ mô hình machine learning tiếp theo được thiết kế để học đồng thời từ nhiều phương thức như văn bản, hình ảnh, video và âm thanh. Các kiến trúc đa phương thức, như CLIP hoặc Gemini, giúp tăng khả năng hiểu ngữ cảnh và giải quyết vấn đề linh hoạt hơn.
Cùng lúc đó, học liên tục (continual learning, hay lifelong learning) hướng đến việc giúp mô hình phát triển mà không quên đi kiến thức đã học trước đó. Điều này sẽ giúp các hệ thống AI trong tương lai trở nên thích nghi, bền vững và có khả năng suy luận dài hạn, gần với trí tuệ con người hơn bao giờ hết.
Câu hỏi thường gặp về mô hình Machine Learning
1. Mô hình machine learning được định nghĩa như thế nào?
Mô hình machine learning là một hệ thống toán học học các quy luật từ dữ liệu và sử dụng các quy luật đó để đưa ra dự đoán hoặc quyết định mà không cần lập trình tường minh. Sau khi được huấn luyện trên dữ liệu lịch sử, mô hình có thể tổng quát hóa cho dữ liệu mới, chưa từng gặp, để nhận diện xu hướng, phân loại thông tin hoặc dự báo kết quả.
2. Có bao nhiêu loại mô hình machine learning?
Mô hình machine learning thường được chia thành năm nhóm chính:
- Mô hình học có giám sát – huấn luyện bằng dữ liệu đã gán nhãn cho các tác vụ dự đoán hoặc phân loại.
- Mô hình học không giám sát – khám phá quy luật hoặc cụm trong dữ liệu chưa gán nhãn.
- Mô hình học tăng cường – học thông qua thử nghiệm và phần thưởng để tối ưu quyết định.
- Mô hình deep learning – dùng mạng nơ-ron để xử lý dữ liệu phức tạp, nhiều chiều.
- Mô hình kết hợp hoặc hybrid – kết hợp nhiều mô hình để cải thiện độ chính xác và tính ổn định.
Mỗi loại phục vụ mục tiêu khác nhau tùy vào dữ liệu, độ phức tạp bài toán và kết quả mong muốn.
3. Phương pháp triển khai nào phù hợp nhất cho suy luận thời gian thực?
Đối với suy luận thời gian thực, cách tiếp cận tốt nhất là triển khai trực tuyến hoặc dạng streaming, trong đó mô hình machine learning được host dưới dạng API hoặc microservice phản hồi tức thì với đầu vào mới. Các công cụ như TensorFlow Serving, TorchServe, FastAPI hoặc AWS SageMaker Endpoints giúp đạt được khả năng dự đoán với độ trễ thấp.
Ngược lại, triển khai theo batch phù hợp hơn với xử lý khối lượng lớn theo định kỳ, khi không yêu cầu phản hồi thời gian thực.
4. Làm sao để đo lường mô hình có đang hoạt động tốt hay không?
Hiệu năng mô hình được đo bằng các chỉ số đánh giá phù hợp với từng tác vụ:
- Với bài toán phân loại, dùng accuracy, precision, recall và F1 score.
- Với bài toán hồi quy, theo dõi mean absolute error (MAE), mean squared error (MSE), hoặc R² score.
- Với hệ thống xếp hạng hoặc gợi ý, đo AUC-ROC hoặc precision@k.
Ngoài các chỉ số này, việc giám sát liên tục trong production là yếu tố quan trọng, kiểm tra model drift, độ trễ và chất lượng dữ liệu giúp đảm bảo mô hình luôn hoạt động ổn định theo thời gian.
