
Các mô hình nguồn mở cỡ nhỏ và cỡ vừa không nhất thiết phải được điều phối như một dây chuyền lắp ráp cố định. Hãy cho chúng một thế giới chung (co-world space), một bộ nhớ chung, một giao ước chung, và một bộ lập kế hoạch quyết định ai lên tiếng tiếp theo, khi đó một nhóm mô hình 27B bắt đầu giải được những công việc mà trước đây phải cần đến API của mô hình đầu bảng.
Đây là cách tiếp cận của AgentSphere: thay vì giao toàn bộ tác vụ cho một mô hình AI duy nhất, hệ thống chia công việc thành nhiều năng lực và tự động route từng bước đến mô hình phù hợp. Các mô hình nguồn mở vẫn giữ trạng thái phi trạng thái (stateless), trong khi toàn bộ trạng thái của nhiệm vụ được duy trì bên ngoài mô hình thông qua shared memory và context.
Khi nào một mô hình lớn không phải là sự lựa chọn tối ưu
Một AI agent trong môi trường production hiếm khi chỉ thực hiện một tác vụ. Nó có thể phải đọc yêu cầu, truy xuất tài liệu, chuẩn hóa thông tin, suy luận, gọi công cụ và kiểm tra lại kết quả. Đưa toàn bộ quy trình này cho một mô hình đầu bảng là cách triển khai đơn giản, nhưng chi phí vận hành có thể tăng nhanh.
Không phải bước nào trong quy trình cũng cần một mô hình có năng lực cao nhất. Một số tác vụ có cấu trúc rõ ràng như information retrieval, data extraction hoặc citation checking có thể được xử lý bởi các mô hình nhỏ hơn với chi phí thấp hơn.
Vấn đề nằm ở cách các mô hình này phối hợp với nhau.
Nếu mỗi model được gọi độc lập, mỗi bước phải nhận lại phần context cần thiết từ đầu. Những tài liệu đã truy xuất, kết quả trung gian và quyết định từ các bước trước phải liên tục được đưa trở lại input. Khi workflow kéo dài, lượng input token tăng lên, latency cao hơn và mỗi lần retry có thể kéo theo chi phí xử lý lại toàn bộ context.
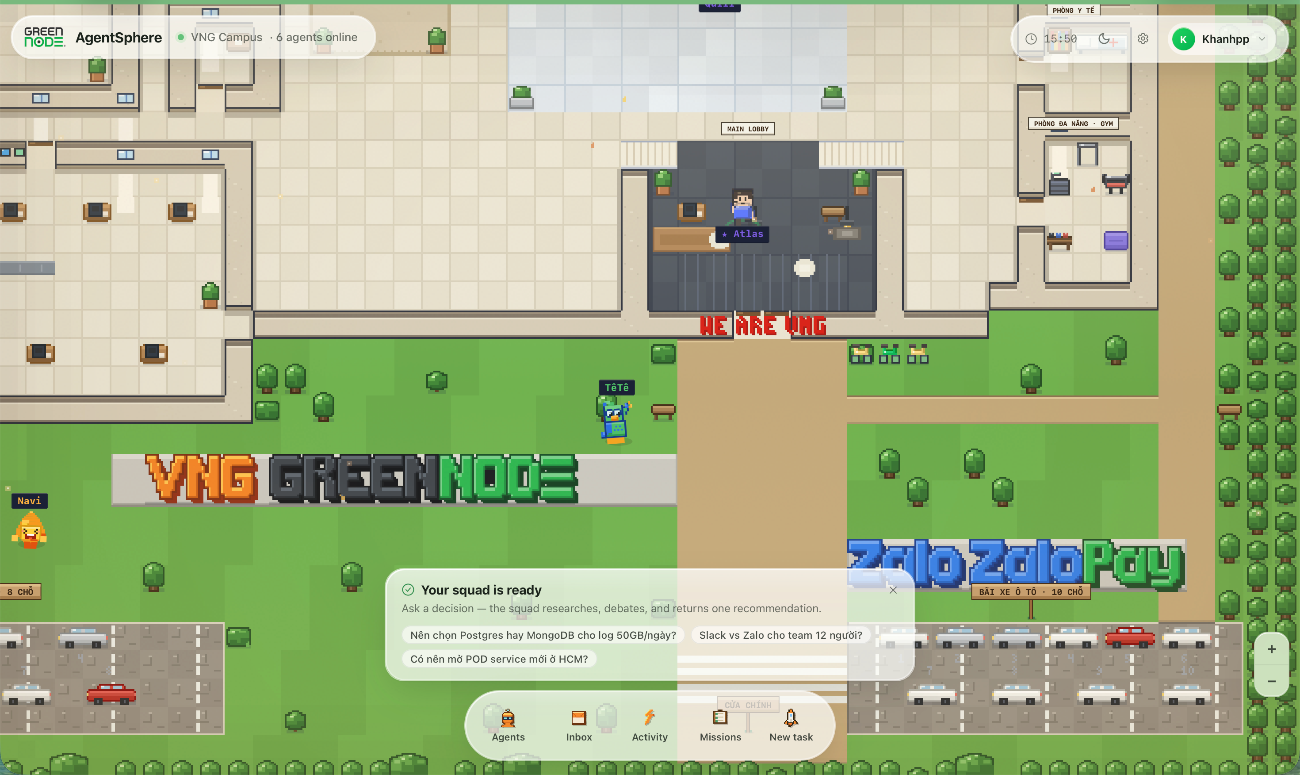
AgentSphere giải quyết bài toán này bằng một shared context space, nơi nhiều mô hình nguồn mở có thể cùng xử lý một nhiệm vụ thông qua một bộ nhớ và một planner dùng chung. AgentSphere chạy trên GreenNode AgentBase, ngay trong VPC của doanh nghiệp.
TÓM TẮT NHANH
Trong AgentSphere, agent là một vai trò, không phải một model cố định. AI planner đọc trạng thái của shared context, xác định năng lực cần thiết tiếp theo và lựa chọn model phù hợp để thực hiện bước đó. Tác vụ đơn giản có thể được route đến model nhỏ. Tác vụ phức tạp hơn có thể chuyển sang model cỡ vừa. Nếu một bước không đạt yêu cầu kiểm định, planner có thể retry hoặc escalate bước đó lên model có năng lực cao hơn. Cách tiếp cận này giúp doanh nghiệp tận dụng open-source AI models cho phần lớn workflow, đồng thời chỉ sử dụng model đắt hơn khi thực sự cần thiết.
"Co-world space" thực chất là gì
AgentSphere dựa trên ba thành phần cốt lõi: shared memory, shared protocol và dynamic planning. Cả ba cần hoạt động cùng nhau để tạo thành một môi trường multi-agent thực sự. Nếu thiếu một trong ba, workflow dễ quay trở lại mô hình chuỗi API độc lập, nơi mỗi bước phải tự mang theo context của mình.
- Một bộ nhớ: mọi bước đều ghi vào và đọc từ cùng một kho lưu trữ. Không mô hình nào sở hữu ngữ cảnh; không lần bàn giao nào làm mất nó.
- Một giao ước: gói dữ liệu là JSON thuần theo một lược đồ, không bao giờ là bộ đệm KV hay trạng thái riêng của từng mô hình. Mô hình nào cũng đọc được mục dữ liệu của mô hình nào.
- Không có luồng cố định: bộ lập kế hoạch lập lại kế hoạch sau mỗi lần ghi. Nhiệm vụ đơn giản chỉ mất một bước; nhiệm vụ khó thì lặp cho tới khi bộ kiểm định chấp nhận.
Điểm quan trọng là workflow không bị khóa vào một model cụ thể. AgentSphere tách trạng thái của nhiệm vụ khỏi model đang xử lý nhiệm vụ đó. Nói cách khác, model có thể thay đổi, nhưng context của task vẫn được giữ nguyên. Đó cũng là ý nghĩa của co-world space trong AgentSphere: nhiều AI agent hoạt động trong cùng một không gian context, chia sẻ cùng memory và được điều phối bởi một planner chung.
Các AI Agent phối hợp như thế nào?
Trong AgentSphere không có lời gọi RPC giữa tác nhân với tác nhân. Một bước ghi kết quả của nó lên trục ngữ cảnh chung dưới một khoá được đặt tên; bộ lập kế hoạch đọc trạng thái mới và quyết định bước nào chạy tiếp; bước kế tiếp đọc đúng thứ nó cần. Chính lớp gián tiếp đó khiến việc gán mô hình trở nên hoàn toàn tự do: vì không có gì trong gói dữ liệu bị ràng buộc vào bên tạo ra nó, cùng một mục findings sẽ đọc được như nhau dù MiniMax-M2.5 hay Qwen3.6 là bên đã viết.
Phía sau trục này có hai tầng. Tầng ngắn hạn là tập làm việc của phiên, lịch sử lượt hội thoại cộng với mọi lần ghi lên trục, được nén lại thành bản tóm tắt khi vượt quá hạn mức. Tầng dài hạn là phần tinh chất còn đọng lại: các dữ kiện đã khử trùng lặp kèm nguồn gốc, được gọi lại theo ngữ nghĩa bởi bất kỳ mô hình nào trong một phiên sau. Dịch vụ Memory của AgentBase cung cấp cả hai tầng, nhờ vậy các mô hình vẫn phi trạng thái trong khi nhiệm vụ thì không.
Khâu dựng ngữ cảnh chính là nơi kích cỡ mô hình thôi còn quan trọng. Trước khi một bước chạy, môi trường thực thi dựng phần đầu vào cho nó từ bốn phần, đặc tả nhiệm vụ, các mục trên trục mà bước đó khai báo là cần, top-k dữ kiện dài hạn liên quan tới truy vấn hiện tại, và phần lịch sử đã nén, rồi cắt gọn theo hạn mức của chính mô hình đó. Mô hình cỡ nhỏ nhận một tập con đã xếp hạng; mô hình cỡ vừa nhận trọn tập làm việc. Không mô hình nào phải nhìn thấy bản ghi hội thoại thô, nên ngay từ đầu ta đã không bắt một mô hình 14B làm công việc 200K token.
Hai quy tắc giữ cho trạng thái dùng chung luôn trung thực. Thứ nhất, mọi lần ghi đều mang theo nguồn gốc, mã bước, năng lực, mô hình - nhờ vậy một câu trả lời sai luôn truy được về đúng bước đã sinh ra nó, và bộ kiểm định có thể vô hiệu hoá đúng dữ kiện đó thay vì huỷ cả lần chạy. Thứ hai, khi có xung đột, bản ghi mới nhất thắng trừ khi khâu kiểm định nói ngược lại - đây chính là điều cho phép một lần chạy lại ghi đè sạch sẽ lên bước đã bị từ chối, thay vì để lại hai dữ kiện mâu thuẫn nằm trong bộ nhớ.
Xây dựng đội ngũ AI Agent với Open-Source Models
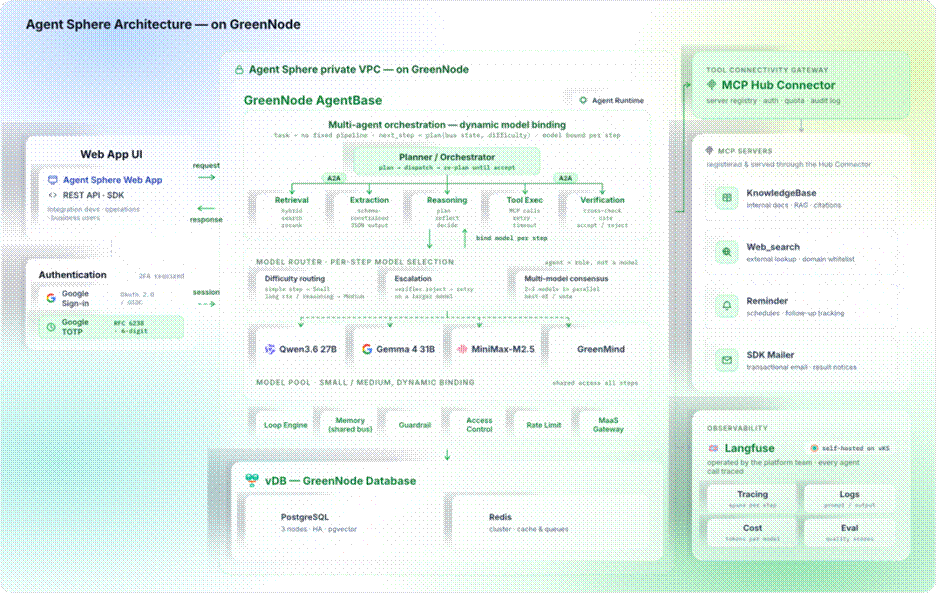
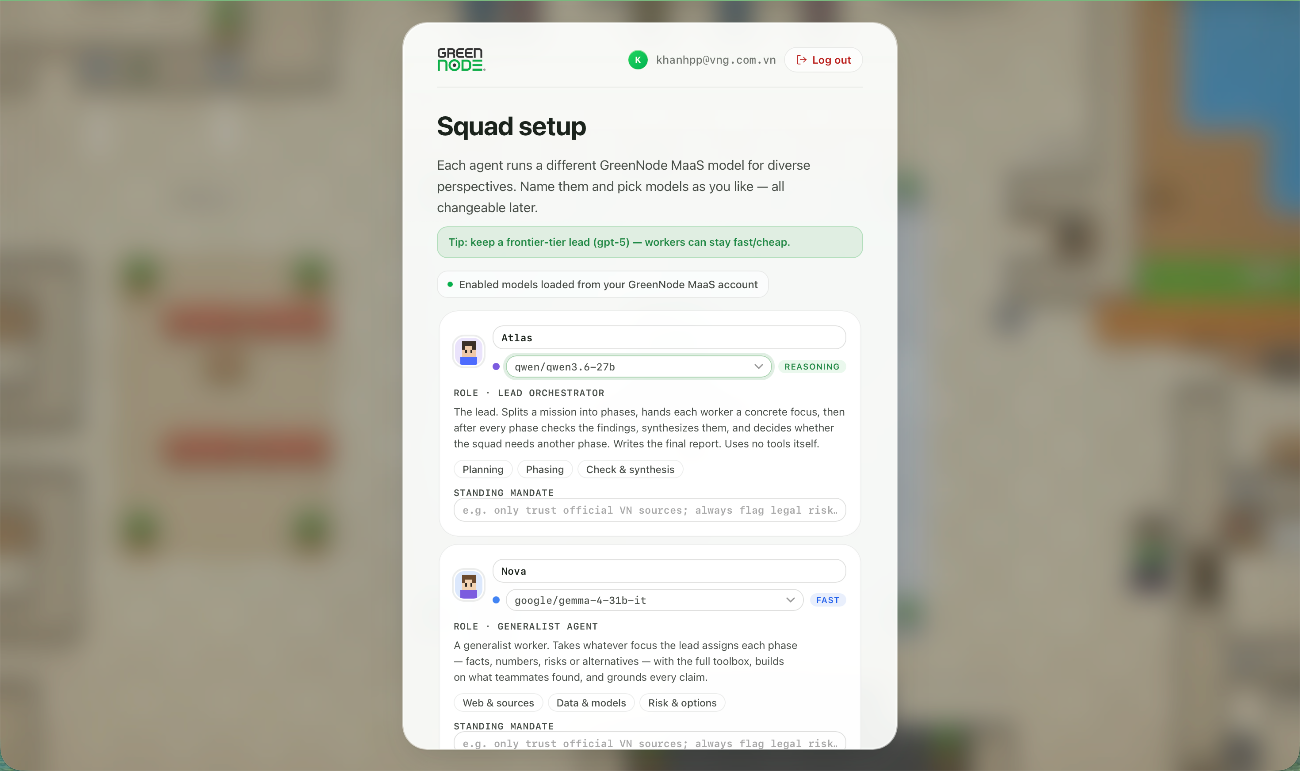
Phần cấu hình được thiết kế nông một cách có chủ đích: đặt tên cho tác nhân, giao cho nó một vai trò, chọn một mô hình trong số các mô hình đã bật trên tài khoản GreenNode MaaS của bạn, và tuỳ chọn viết thêm một chỉ thị thường trực — một quy tắc có hiệu lực xuyên suốt mọi giai đoạn, kiểu như "chỉ tin nguồn chính thống của Việt Nam; luôn cảnh báo rủi ro pháp lý". Tác nhân điều phối chính chia nhiệm vụ thành các giai đoạn rồi tổng hợp kết quả; các tác nhân thành viên nhận trọng tâm do điều phối viên giao và phải dẫn nguồn cho mọi khẳng định.
Vì trục ngữ cảnh không phụ thuộc mô hình, ô chọn mô hình là thứ rẻ nhất trong toàn hệ thống để thay đổi. Đổi một tác nhân thành viên từ Gemma 4 31B sang MiniMax-M2.5 và không phần nào khác trong đội cần biết điều đó - vẫn cùng bộ khoá, cùng lược đồ, cùng bộ nhớ.
Hai kịch bản được sử dụng và chi phí cho việc sử dụng Multi-Agent AI
Tranh luận về kiến trúc thì rẻ; hoá đơn token thì không. Dưới đây là hai kịch bản chúng tôi gặp nhiều nhất trên AgentBase, mô phỏng từ mức 500 nghìn token (một tuần thử nghiệm) đến 1 tỷ token (một tháng vận hành cao điểm), đối chiếu với GPT-5.1 theo giá niêm yết.
KỊCH BẢN A · NGHIÊN CỨU CHUYÊN SÂU
Điều tra đa nguồn với các vòng lặp truy xuất ⇄ suy luận cùng một lượt kiểm định. Khoảng 250 nghìn token mỗi nhiệm vụ, 80% đầu vào / 20% đầu ra. Tỷ lệ định tuyến 55% cỡ nhỏ · 45% cỡ vừa; 1 tỷ token ≈ 4.000 nhiệm vụ nghiên cứu.
KỊCH BẢN B · TRUY XUẤT KHO TRI THỨC NỘI BỘ
Truy xuất tăng cường trên tài liệu nội bộ, có trích dẫn và một câu trả lời ngắn có dẫn chứng. Khoảng 12 nghìn token mỗi truy vấn, 90% đầu vào / 10% đầu ra. Tỷ lệ định tuyến 85% cỡ nhỏ · 15% cỡ vừa; 1 tỷ token ≈ 83.000 truy vấn.
| TOKEN MỖI THÁNG | NGHIÊN CỨU CHUYÊN SÂU · GPT-5.1 | NGHIÊN CỨU CHUYÊN SÂU · AGENTSPHERE | TRUY XUẤT KHO TRI THỨC · GPT-5.1 | TRUY XUẤT KHO TRI THỨC · AGENTSPHERE |
|---|---|---|---|---|
| 500 nghìn | $1,50 | $0,13 | $1,06 | $0,08 |
| 100 triệu | $300 | $25,90 | $212,50 | $15,78 |
| 500 triệu | $1.500 | $129,50 | $1.062,50 | $78,90 |
| 1 tỷ | $3.000 | $259 | $2.125 | $158 |
CHI PHÍ TRUNG BÌNH TRÊN 1 TRIỆU TOKEN
- Nghiên cứu chuyên sâu · GPT-5.1 - $3,00 trên 1 triệu token
- Nghiên cứu chuyên sâu · AgentSphere - $0,26 trên 1 triệu token - rẻ hơn 11,6 lần
- Truy xuất kho tri thức · GPT-5.1 - $2,13 trên 1 triệu token
- Truy xuất kho tri thức · AgentSphere - $0,16 trên 1 triệu token - rẻ hơn 13,5 lần
CÁCH DOANH NGHIỆP CÓ THỂ ƯỚC LƯỢNG CÁC CON SỐ TRÊN
Giá niêm yết GPT-5.1: $1,25 cho 1 triệu token đầu vào, $10,00 cho 1 triệu token đầu ra.
Nhóm mô hình của AgentSphere (mức giá MaaS mang tính minh hoạ): cỡ nhỏ ≈ $0,10 / $0,40 và cỡ vừa ≈ $0,25 / $0,90 cho mỗi 1 triệu token đầu vào / đầu ra. Hãy thay bằng mức giá GreenNode MaaS đã ký của bạn — điều đáng nói ở đây là tỷ lệ chênh lệch, không phải con số tuyệt đối.
Tỷ lệ định tuyến đã bao gồm cả các lần chạy lại do leo thang; một bước bị từ chối rồi chạy lại trên mô hình lớn hơn được tính vào phần cỡ vừa.
Nói cho công bằng: nếu 50% token đầu vào của GPT-5.1 được phục vụ từ bộ nhớ đệm đầu vào, hoá đơn nghiên cứu chuyên sâu giảm còn khoảng $2.550 cho 1 tỷ token — vẫn gấp khoảng 10 lần con số của AgentSphere, bởi bộ nhớ đệm chỉ giảm giá phần đầu vào trong khi đầu ra vẫn giữ mức $10 cho 1 triệu token.
Chưa tính vào: AgentBase Runtime, vDB và vStorage. Đây là hạ tầng cố định tính theo tháng và không tăng theo lượng token.
Model Routing giúp tiết kiệm chi phí như thế nào?
Không phải vì mô hình rẻ, mà vì phần lớn các bước vốn không cần đến một mô hình đắt tiền. Trong một lần nghiên cứu chuyên sâu, khối lượng token dồn vào khâu truy xuất và trích xuất: đọc các đoạn tài liệu, chuẩn hoá chúng thành bản ghi, kiểm tra trích dẫn. Đó là những bước bị ràng buộc bởi lược đồ, nơi một mô hình 14B với phần đầu vào tốt gần như không phân biệt được với một mô hình đầu bảng. Khâu suy luận và tổng hợp cuối cùng thì dành cho cỡ vừa. Khâu kiểm định rẻ nhưng có tính quyết định: khi nó từ chối, chỉ đúng bước đó chạy lại, trên một trục ngữ cảnh đã sẵn giữ mọi thứ thu thập được từ trước tới giờ.
Chính điểm cuối cùng ấy mới là đòn bẩy chi phí âm thầm. Trong một chuỗi xử lý phi trạng thái, một bước hỏng nghĩa là phát lại cả cuộc hội thoại. Trong một không gian thế giới chung, nó chỉ nghĩa là chạy lại một bước và trả tiền cho một bước.
Còn một khoản tiết kiệm thứ hai, kém hiển nhiên hơn, nằm ở cột đầu vào. Vì các dữ kiện sống trong bộ nhớ thay vì trong phần đầu vào, một đoạn tài liệu đã truy xuất chỉ được đọc một lần, chắt lọc một lần, rồi từ đó về sau chỉ cần tham chiếu qua khoá. Tỷ lệ 80% đầu vào của kịch bản nghiên cứu ở trên được giả định chính xác vì tỷ lệ đó chỉ đúng khi bạn thôi gửi lại ngữ cảnh; trên một chuỗi xử lý dùng một mô hình duy nhất, cùng nhiệm vụ ấy trôi dần về mức 90% đầu vào, và phần token dôi ra đó bị tính theo giá đầu bảng.
Hãy bắt đầu một cách thận trọng và để Langfuse dịch chuyển cây kim. Chạy mọi thứ trên cỡ vừa trong một tuần, xem những năng lực nào mà bộ kiểm định không bao giờ từ chối, rồi hạ dần từng năng lực đó xuống cỡ nhỏ. Trong các lần chạy của chính chúng tôi, tỷ lệ định tuyến ổn định quanh mức 55/45 cho nghiên cứu và 85/15 cho truy xuất, nhưng tỷ lệ ấy là đặc tính của tập tài liệu và phần đầu vào của riêng bạn, không phải một hằng số, và nó là con số duy nhất quyết định hoá đơn.
Nền tảng vận hành AgentSphere
| TÀI NGUYÊN GREENNODE | VAI TRÒ TRONG AGENTSPHERE |
|---|---|
| AgentBase Runtime | Bộ lập kế hoạch, các tác nhân năng lực và các máy khách MCP — container không máy chủ, không phải vận hành Kubernetes. |
| MaaS | Các điểm cuối tương thích OpenAI cho Qwen3.6 27B, Gemma 4 31B, MiniMax-M2.5 và GreenMind 14B,… — chính là nhóm mô hình mà bộ định tuyến gán vào. |
| AgentBase Memory | Sự kiện ngắn hạn theo từng phiên và bản ghi bộ nhớ dài hạn có gọi lại theo ngữ nghĩa. |
| MCP Hub Connector | Đăng ký dịch vụ, xác thực, hạn mức và nhật ký kiểm toán đặt trước KnowledgeBase, Web_search, Reminder và SDK Mailer. |
| vDB | PostgreSQL được quản lý kèm pgvector cho bản ghi và vector nhúng, Redis cho bộ nhớ đệm và hàng đợi. |
| vKS | Kubernetes được quản lý cho các thành phần có trạng thái mà môi trường thực thi không tự chứa — Langfuse cùng hệ nền ClickHouse của nó, cộng thêm bất kỳ máy chủ MCP tự vận hành nào cần một tiến trình chạy dài. |
| Langfuse | Truy vết, nhật ký, chi phí và đánh giá theo từng bước — đây cũng chính là cách bạn tinh chỉnh tỷ lệ định tuyến nói trên. Tự vận hành trên vKS, nên dữ liệu truy vết không bao giờ rời khỏi VPC. |
Khi nào không nên sử dụng Multi-Agent AI?
Một không gian thế giới chung chỉ xứng đáng với công sức bỏ ra khi nhiệm vụ có nhiều bước phân biệt được và có đủ khối lượng để việc định tuyến trở nên đáng kể. Với một lượt hoàn thành hội thoại đơn lẻ, phần chi phí phụ trội của bộ lập kế hoạch chẳng mang lại gì cho bạn — cứ gọi thẳng một mô hình. Với những bài suy luận khó tới mức chỉ mô hình đầu bảng mới với tới, còn không mô hình nguồn mở 30B nào chạm được, hãy định tuyến riêng bước đó ra một API đầu bảng và giữ phần còn lại của lần chạy trong nhóm mô hình của bạn; trục ngữ cảnh không quan tâm gói dữ liệu đến từ đâu, và đó chính xác là điểm mấu chốt.
Xây dựng Multi-Agent AI của doanh nghiệp trên AgentBase
Bắt đầu với hai năng lực và một kho bộ nhớ dùng chung trên AgentBase, rồi bổ sung mô hình vào nhóm khi dữ liệu định tuyến cho bạn thấy là cần. Tài liệu về Memory: https://docs.greennode.ai/ai-stack/agent-base/memory
