
TL;DR
- Lựa chọn đúng embedding model là yếu tố then chốt đối với RAG, vì nó quyết định trực tiếp chất lượng truy xuất, độ trễ và chi phí; các lựa chọn hiện đại như E5, BGE, Mistral Embed, OpenAI và Cohere đều có sự đánh đổi riêng giữa độ chính xác, tốc độ và tính linh hoạt khi triển khai.
- Các đội ngũ nên đánh giá embedding model dựa trên các chỉ số truy xuất (MTEB/BEIR), độ trễ, số chiều vector, mức độ phù hợp với domain và giấy phép sử dụng, sau đó fine-tune hoặc điều chỉnh cho phù hợp với dữ liệu và hạ tầng cụ thể của mình để đạt kết quả tốt nhất.
- GreenMind Embedding của GreenNode (GreenNode-Embedding-Large-1007) cung cấp một text embedding model chất lượng cao, sẵn sàng cho production, phục vụ semantic search, pipeline RAG, phân cụm và gợi ý - mang đến cho doanh nghiệp một lựa chọn thay thế mạnh mẽ, ngay trên nền tảng, so với các embedding thông dụng khác.
Lựa chọn đúng embedding model có thể quyết định sự thành bại của hệ thống Retrieval-Augmented Generation (RAG) của bạn. Đây chính là cầu nối giữa dữ liệu và mô hình ngôn ngữ lớn, quyết định hệ thống sẽ truy xuất đúng thông tin cần thiết hay chỉ trả về những nội dung nhiễu, không liên quan. Với hàng chục lựa chọn mã nguồn mở lẫn thương mại hiện có, việc tìm ra embedding model “tốt nhất” không còn là chuyện đơn giản.
Trong năm 2026, các mô hình mới như E5, BGE và Mistral Embed đang thách thức những cái tên đã có chỗ đứng như text-embedding của OpenAI và Cohere Embed, mang lại độ chính xác truy xuất tốt hơn, độ trễ thấp hơn và sự minh bạch nhờ open-weight. Cùng lúc đó, RAG cũng đã trưởng thành từ một mô hình nghiên cứu thành một kiến trúc sẵn sàng cho production, vận hành từ trợ lý tri thức nội bộ cho đến các copilot chuyên biệt theo từng ngành.
Bài viết này sẽ phân tích cách chọn đúng embedding model cho pipeline RAG của bạn, so sánh hiệu năng, khả năng mở rộng và các trường hợp sử dụng dựa trên benchmark thực tế cùng những đúc kết từ cộng đồng. Dù bạn đang tối ưu về chi phí, độ chính xác hay độ tin cậy ở cấp doanh nghiệp, bạn sẽ tìm thấy những gợi ý thực tiễn để xây dựng một tầng truy xuất nhanh hơn, thông minh hơn cho hệ thống AI của mình.
Hiểu về khái niệm cốt lõi
Hệ thống Retrieval-Augmented Generation (RAG) là gì
Retrieval-Augmented Generation, hay RAG, là một kiến trúc được thiết kế để cải thiện cách các mô hình ngôn ngữ lớn (LLM) trả lời truy vấn, bằng cách kết hợp việc truy xuất tri thức bên ngoài với khả năng sinh nội dung. Trong một hệ thống LLM thuần túy, mô hình chỉ dựa vào thông tin đã được mã hóa trong các tham số từ quá trình huấn luyện, vốn có thể lỗi thời hoặc không đầy đủ. RAG khắc phục hạn chế này bằng cách cho phép mô hình lấy các đoạn văn bản liên quan từ một kho tài liệu hoặc cơ sở dữ liệu đã được tuyển chọn tại thời điểm suy luận, sau đó dùng những văn bản truy xuất được làm ngữ cảnh bổ sung khi tạo câu trả lời.
Trên thực tế, một hệ thống RAG thường trải qua các bước sau:
- Embedding truy vấn & truy xuất: Đầu vào của người dùng được chuyển thành một vector và đối chiếu với cơ sở dữ liệu các embedding của tài liệu để lấy ra những đoạn văn bản liên quan nhất.
- Bổ sung vào prompt/ngữ cảnh: Các đoạn văn bản truy xuất được sẽ được thêm vào (hoặc tích hợp vào) ngữ cảnh đầu vào (prompt) của LLM.
- Sinh câu trả lời / tổng hợp: LLM sau đó tạo ra câu trả lời bằng cách sử dụng cả tri thức nội tại lẫn các dữ kiện bên ngoài vừa được truy xuất.
- Trích dẫn nguồn (tùy chọn): Một số hệ thống RAG còn trả về các tham chiếu hoặc trích dẫn đến tài liệu đã sử dụng, giúp tăng khả năng truy vết nguồn gốc thông tin.
Lợi ích cốt lõi của RAG là gắn AI tạo sinh với dữ liệu cập nhật, đặc thù theo từng lĩnh vực, mà không cần huấn luyện lại toàn bộ mô hình. Điều này khiến RAG trở nên đặc biệt giá trị đối với các trường hợp sử dụng đòi hỏi độ chính xác về mặt dữ kiện, mức độ liên quan đến domain và khả năng truy vết nguồn (ví dụ: trợ lý tri thức doanh nghiệp, hỏi đáp chuyên biệt, hỗ trợ trong lĩnh vực pháp lý hoặc y tế).
Đọc thêm: Tối ưu hiệu năng RAG với hệ thống truy xuất tài liệu nâng cao
Embedding Model là gì
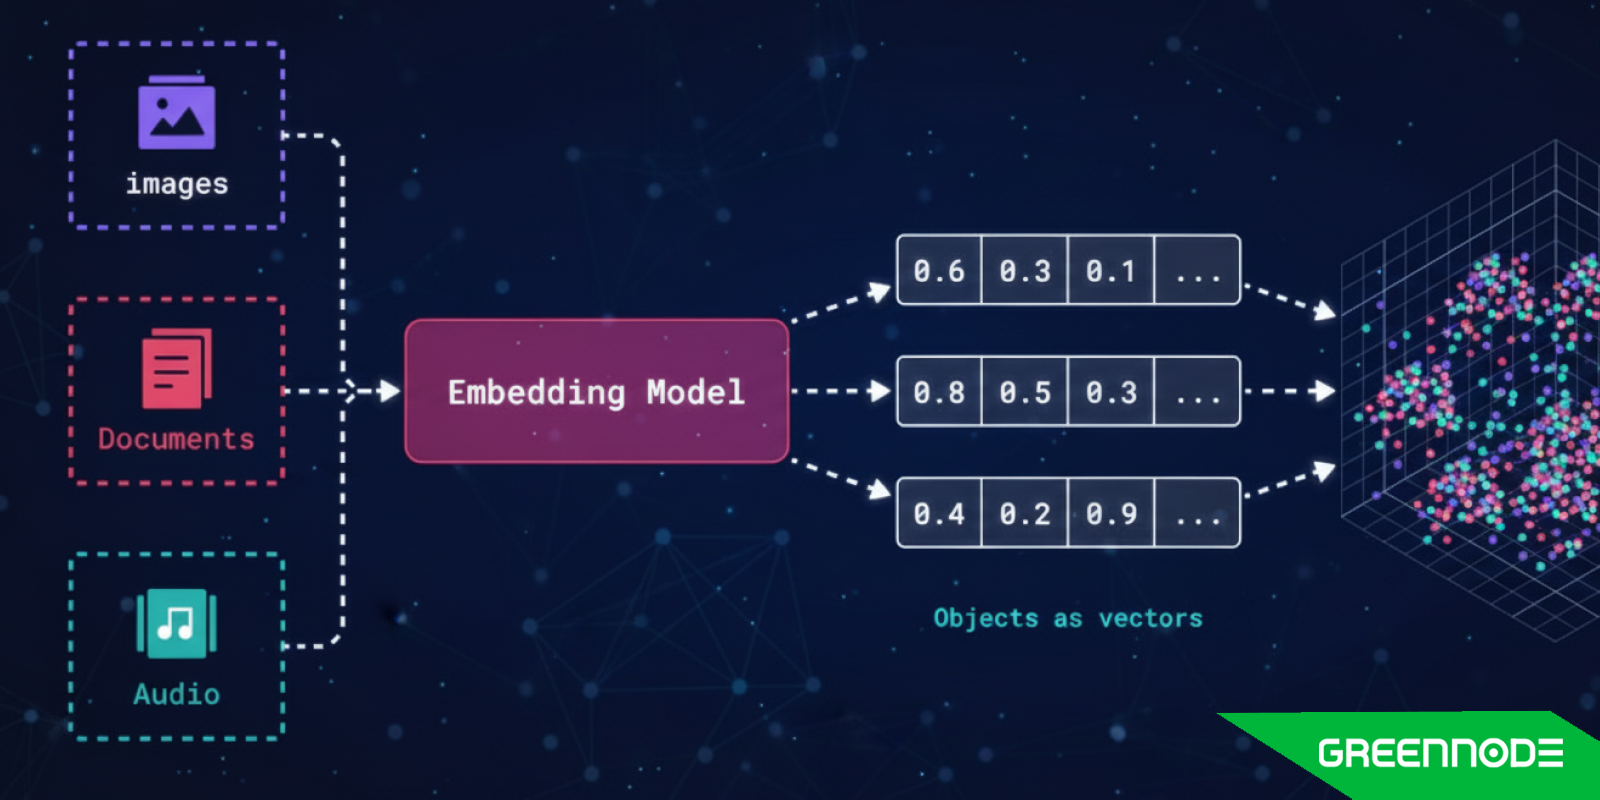
Embedding model là một thành phần machine learning có nhiệm vụ chuyển đổi dữ liệu đầu vào thô (như văn bản, hình ảnh hoặc âm thanh) thành các vector số có độ dài cố định, thường được gọi là embedding. Các embedding này nắm bắt ý nghĩa ngữ nghĩa hoặc ngữ cảnh trong một không gian vector liên tục, sao cho những đầu vào có ý nghĩa tương đồng sẽ nằm gần nhau theo một thước đo tương đồng nào đó (ví dụ: cosine similarity hoặc dot product).
Trong bối cảnh RAG, embedding model đóng vai trò then chốt vì:
- Chúng chuyển đổi cả truy vấn và tài liệu vào cùng một không gian vector, giúp việc so sánh độ tương đồng trở nên khả thi.
- Chúng cho phép thực hiện tìm kiếm ngữ nghĩa (semantic search), chứ không chỉ đơn thuần là khớp từ khóa, nhờ đó hệ thống vẫn có thể tìm ra đoạn văn bản liên quan dù dùng từ ngữ khác nhau.
- Chất lượng của embedding ảnh hưởng trực tiếp đến độ chính xác truy xuất: embedding càng tốt sẽ giúp lấy được nhiều đoạn văn bản liên quan hơn, từ đó dẫn đến kết quả sinh nội dung chính xác hơn.
- Các embedding model khác nhau ở số chiều vector, dữ liệu huấn luyện, kiến trúc, độ trễ và mức độ chuyên biệt theo domain - tất cả đều cần được cân nhắc khi lựa chọn cho RAG.
Một cách ví von đơn giản: nếu tài liệu và truy vấn là những điểm trên bản đồ, thì embedding model chính là công cụ vẽ ra tấm bản đồ đó, sao cho “gần nhau” đồng nghĩa với “có liên quan về mặt ngữ nghĩa”. Bước truy xuất tiếp theo sẽ dùng tấm bản đồ này để chọn ra những nguồn liên quan nhất để đưa vào mô hình ngôn ngữ.
Embedding Model đóng vai trò gì trong RAG?
Embedding model chính là mô liên kết của bất kỳ hệ thống Retrieval-Augmented Generation (RAG) nào. Chúng chuyển đổi cả truy vấn của người dùng lẫn các tài liệu trong knowledge base thành các biểu diễn vector - những mảng số dày đặc nắm bắt ý nghĩa ngữ nghĩa thay vì chỉ dừng lại ở từ khóa bề mặt. Nhờ sự chuyển đổi này, hệ thống có thể so sánh và truy xuất thông tin dựa trên mức độ tương đồng về mặt khái niệm, chứ không đơn thuần là khớp chuỗi ký tự.
Từ truy vấn đến không gian vector
Khi người dùng gửi một câu hỏi, embedding model sẽ chuyển đổi nó thành một vector có độ dài cố định. Vector này tồn tại trong một không gian đa chiều, nơi mà sự gần gũi đại diện cho ý nghĩa liên quan. Ví dụ, cụm từ “AI model training” và “machine learning optimization” sẽ tạo ra các embedding rất gần nhau, dù chúng hầu như không dùng chung từ ngữ nào.
Quá trình này giúp các hệ thống RAG hiểu được ý định (intent) thay vì chỉ hiểu cú pháp, và điều này đặc biệt quan trọng khi xử lý các đầu vào ngôn ngữ không có cấu trúc hoặc đa dạng.
Truy xuất đúng ngữ cảnh
Mỗi tài liệu (hoặc đoạn văn bản) trong knowledge base đều đã được chuyển đổi thành embedding riêng của nó từ trước. Hệ thống sử dụng tìm kiếm theo độ tương đồng vector (vector similarity search) thông qua các công cụ như Pinecone, Weaviate hoặc FAISS để so sánh embedding của truy vấn với toàn bộ embedding của tài liệu, từ đó lấy ra những kết quả khớp nhất.
Nói cách khác, embedding model chính là bên quyết định “sự liên quan” có nghĩa là gì. Một embedding model chất lượng cao hơn sẽ tạo ra các cụm ngữ nghĩa chặt chẽ hơn, cải thiện cả recall lẫn precision trong truy xuất. Ngược lại, embedding kém chất lượng có thể dẫn đến ngữ cảnh không liên quan hoặc dư thừa, làm giảm độ chính xác của câu trả lời cuối cùng từ LLM.
Đưa ngữ cảnh vào LLM
Các đoạn văn bản truy xuất được sau đó sẽ được thêm vào prompt gửi cho mô hình ngôn ngữ lớn (LLM). Vì chất lượng của văn bản truy xuất quyết định mức độ “bám sát thực tế” của kết quả sinh ra, embedding model gián tiếp ảnh hưởng đến việc câu trả lời của mô hình có chính xác về mặt dữ kiện và phù hợp với ngữ cảnh hay không.
Ví dụ:
- Một embedding model tốt có thể phân biệt giữa “Apple - công ty” và “apple - quả táo”.
- Một embedding model kém có thể trả về công thức nấu ăn trong khi người dùng đang hỏi về diễn biến giá cổ phiếu.
Hiệu suất và khả năng mở rộng
Embedding model cũng quyết định mức độ hiệu quả khi hệ thống RAG vận hành ở quy mô lớn. Số chiều của embedding (ví dụ: 384, 768, 1024 chiều) ảnh hưởng đến cả nhu cầu bộ nhớ lẫn hiệu năng của vector database. Embedding có số chiều cao thường mang lại độ chính xác tốt hơn, nhưng đi kèm với đó là chi phí tính toán và lưu trữ cao hơn.
Các mô hình hiện đại như E5, BGE hay Cohere Embed v3 được tối ưu để cân bằng giữa chất lượng và độ trễ, giúp việc lập chỉ mục nhanh hơn, truy xuất rẻ hơn và thông lượng tốt hơn cho các ứng dụng RAG thời gian thực.
Khả năng thích ứng liên tục và phù hợp với domain
Cuối cùng, embedding model có thể được fine-tune hoặc điều chỉnh theo domain để cải thiện khả năng truy xuất trong các lĩnh vực chuyên biệt như pháp lý, y tế hoặc tài liệu kỹ thuật. Khả năng tùy biến này chính là một trong những lợi thế lớn nhất của việc sử dụng embedding mã nguồn mở (như E5 hay BGE) so với các API thương mại đóng, vì các đội ngũ có thể huấn luyện lại trên dữ liệu độc quyền của mình để phản ánh đúng từ vựng và phong cách riêng của tổ chức.
Đọc thêm: Hướng dẫn toàn diện để giải mã Embedding Model: Chìa khóa cho hệ thống RAG mạnh mẽ
Tiêu chí đánh giá Embedding Model tốt nhất cho RAG
Không phải embedding model nào cũng được tạo ra như nhau. Trong một hệ thống Retrieval-Augmented Generation (RAG), việc chọn đúng embedding model có thể cải thiện đáng kể độ chính xác truy xuất, giảm độ trễ và hạ chi phí vận hành. Việc đánh giá mô hình nào phù hợp nhất phụ thuộc vào một vài tiêu chí then chốt, cân bằng giữa chất lượng, tốc độ, chi phí và mức độ phù hợp với domain.
Độ chính xác truy xuất và chất lượng ngữ nghĩa
Thước đo quan trọng nhất của bất kỳ embedding model nào là khả năng biểu diễn ý nghĩa tốt đến đâu. Embedding tốt phải đưa những văn bản có ngữ nghĩa tương đồng đến gần nhau, dù chúng được diễn đạt theo cách khác nhau.
- Các chỉ số cần theo dõi: Recall@k, Precision@k, nDCG (normalized discounted cumulative gain).
- Benchmark: Bộ MTEB (Massive Text Embedding Benchmark) và BEIR là những chuẩn tham chiếu phổ biến để đánh giá embedding model trên nhiều tác vụ truy xuất và phân loại khác nhau.
- Ví dụ: Các mô hình như E5-Large và BGE-M3 liên tục dẫn đầu các bảng xếp hạng này, vượt trội hơn các baseline cũ như SBERT trong các tác vụ đa ngôn ngữ hoặc tổng quát theo domain.
Độ chính xác truy xuất cao đảm bảo hệ thống RAG của bạn lấy được ngữ cảnh liên quan, đa dạng và chính xác về mặt dữ kiện cho mô hình ngôn ngữ - đây chính là nền tảng cho những câu trả lời đáng tin cậy.
Độ trễ và thông lượng
Các embedding model có tốc độ suy luận khác nhau rất nhiều. Mô hình càng lớn thường tạo ra embedding càng chính xác, nhưng cũng đòi hỏi nhiều tài nguyên tính toán và thời gian xử lý truy vấn hơn.
- Vì sao điều này quan trọng: Trong các pipeline RAG cấp production (ví dụ: chatbot hoặc trợ lý tìm kiếm), độ trễ ảnh hưởng trực tiếp đến trải nghiệm người dùng.
- Quy tắc tham khảo: Các mô hình có thể tạo embedding trong dưới 50-100 ms mỗi truy vấn là phù hợp cho truy xuất thời gian thực.
- Mẹo tối ưu: Các framework như TensorRT, ONNX Runtime hoặc vLLM có thể giúp tăng tốc quá trình tạo embedding mà không làm giảm chất lượng.
Số chiều vector và chi phí lưu trữ
Mỗi embedding model tạo ra các vector với một số chiều nhất định (ví dụ: 384, 768, 1024, 1536 chiều).
- Vector có số chiều cao hơn nắm bắt được ngữ nghĩa phong phú hơn, nhưng cũng làm tăng dung lượng lưu trữ và độ phức tạp khi tìm kiếm trong vector database.
- Đối với các hệ thống RAG quy mô lớn với hàng triệu tài liệu, chi phí này có thể tăng lên rất nhanh.
Ví dụ:
- text-embedding-3-large của OpenAI (3072 chiều) mang lại độ chính xác xuất sắc nhưng chi phí lưu trữ cao hơn.
- BGE-base (768 chiều) hoặc E5-small (384 chiều) mang lại sự cân bằng tốt cho các triển khai ở quy mô doanh nghiệp.
Lựa chọn của bạn nên phù hợp với năng lực hạ tầng hiện có và yêu cầu về độ chính xác.
Mức độ phù hợp với domain và khả năng thích ứng
Một số embedding model được huấn luyện trên dữ liệu web tổng quát, trong khi số khác được tối ưu cho các domain cụ thể (ví dụ: code, văn bản y tế, tài liệu pháp lý).
- Các mô hình tổng quát (như E5 hoặc OpenAI) hoạt động tốt trên nhiều chủ đề đa dạng.
- Các mô hình chuyên biệt theo domain (như BioBERT hoặc Legal-BERT) vượt trội với từ vựng và ngữ cảnh chuyên ngành.
- Fine-tuning hoặc huấn luyện dựa trên adapter (LoRA, PEFT) cho phép bạn điều chỉnh embedding để phù hợp với kho dữ liệu độc quyền, giúp tăng mức độ liên quan.
Nếu hệ thống RAG của bạn nhắm đến một domain tri thức tập trung, việc điều chỉnh embedding model sẽ mang lại chất lượng truy xuất ổn định hơn.
Chi phí, giấy phép sử dụng và giới hạn triển khai
Cuối cùng, những yếu tố thực tế thường là điều quyết định tính khả thi.
- Các mô hình mã nguồn mở (ví dụ: BGE, E5, Mistral Embed) linh hoạt cho các triển khai on-premise hoặc AI chủ quyền (sovereign AI).
- Các API độc quyền (như OpenAI hoặc Cohere) mang lại sự đơn giản kiểu “cắm là chạy”, nhưng đi kèm phí theo từng request và các giới hạn về tuân thủ dữ liệu.
- Các lựa chọn triển khai: Mô hình tự host có thể chạy thông qua các framework như LangChain, SentenceTransformers hoặc NVIDIA NIM để tối ưu suy luận.
Khi xây dựng hệ thống RAG cho doanh nghiệp hoặc khu vực công, việc đánh giá không chỉ dừng ở hiệu năng kỹ thuật mà còn cần xem xét cả yêu cầu về quản trị dữ liệu và tuân thủ quy định.
Các Embedding Model tốt nhất cho RAG năm 2026
Bức tranh về embedding model đã thay đổi nhanh chóng trong năm qua. Khi các hệ thống RAG chuyển dịch từ thử nghiệm nghiên cứu sang ứng dụng cấp production, các nhà phát triển và doanh nghiệp giờ đây có ngày càng nhiều lựa chọn, cả embedding model thương mại lẫn mã nguồn mở. Mỗi mô hình đều có những đánh đổi riêng giữa độ chính xác, độ trễ, chi phí và khả năng thích ứng theo domain.
Dưới đây là những embedding model tốt nhất cho RAG nên cân nhắc trong năm 2026, dựa trên kết quả benchmark (MTEB, BEIR), mức độ được cộng đồng sử dụng và độ tin cậy khi triển khai ở doanh nghiệp.
Họ mô hình E5 (Google Research / Hugging Face)
Loại: Mã nguồn mở (tiếng Anh & đa ngôn ngữ)
Phù hợp nhất cho: RAG tổng quát, tìm kiếm đa ngôn ngữ, hỏi đáp
Các mô hình E5, đặc biệt là E5-Large-V2 và E5-Mistral, đã trở thành lựa chọn tiêu chuẩn cho các pipeline RAG mã nguồn mở. Chúng sử dụng phương pháp pretraining tương phản (contrastive pretraining) trên các tập dữ liệu quy mô web, giúp căn chỉnh trực tiếp giữa truy vấn và đoạn văn bản cho các tác vụ truy xuất.
Điểm nổi bật:
- Hiệu năng cao trên các bảng xếp hạng MTEB và BEIR
- Hỗ trợ đa ngôn ngữ (thông qua multilingual-e5-base)
- Có nhiều kích thước khác nhau (nhỏ → lớn), phù hợp cho cả nghiên cứu lẫn triển khai ở doanh nghiệp
Trường hợp sử dụng: Một công ty đang xây dựng công cụ tìm kiếm nội bộ hoặc chatbot đa ngôn ngữ có thể dùng intfloat/multilingual-e5-large để có khả năng truy xuất xuyên ngôn ngữ mạnh mẽ.
BGE (BAAI General Embedding)
Loại: Mã nguồn mở (Beijing Academy of AI)
Phù hợp nhất cho: Pipeline RAG có khả năng mở rộng, các ứng dụng đa ngôn ngữ và fine-tuned
Họ mô hình BGE (ví dụ: bge-base-en-v1.5, bge-m3) mang lại độ chính xác truy xuất cạnh tranh cùng kiến trúc linh hoạt. Các mô hình này có khả năng hỗ trợ đa ngôn ngữ mạnh mẽ và được tối ưu để fine-tune bằng dữ liệu đặc thù theo domain.
Điểm nổi bật:
- Hoạt động ổn định trên nhiều ngôn ngữ và domain khác nhau
- Hiệu quả khi suy luận trên cả GPU lẫn CPU
- Là lựa chọn xuất sắc để fine-tune hoặc tích hợp adapter
Trường hợp sử dụng: RAG doanh nghiệp trong lĩnh vực tài chính hoặc pháp lý, nơi độ chính xác đối với tài liệu đa ngôn ngữ là yếu tố quan trọng.
Trong họ BGE, BGE-M3 là phiên bản được nhiều đội ngũ RAG lựa chọn, nhờ khả năng hỗ trợ đa ngôn ngữ và truy xuất đa hạt độ (dense, sparse và multi-vector) trong cùng một mô hình. Nếu bạn muốn trải nghiệm ngay mà không cần tự xây dựng hạ tầng, BGE-M3 hiện đã có sẵn trên GreenNode AI Mass - triển khai chỉ trong vài phút và tích hợp trực tiếp vào pipeline RAG của bạn, không cần tự quản lý GPU hay tối ưu inference.
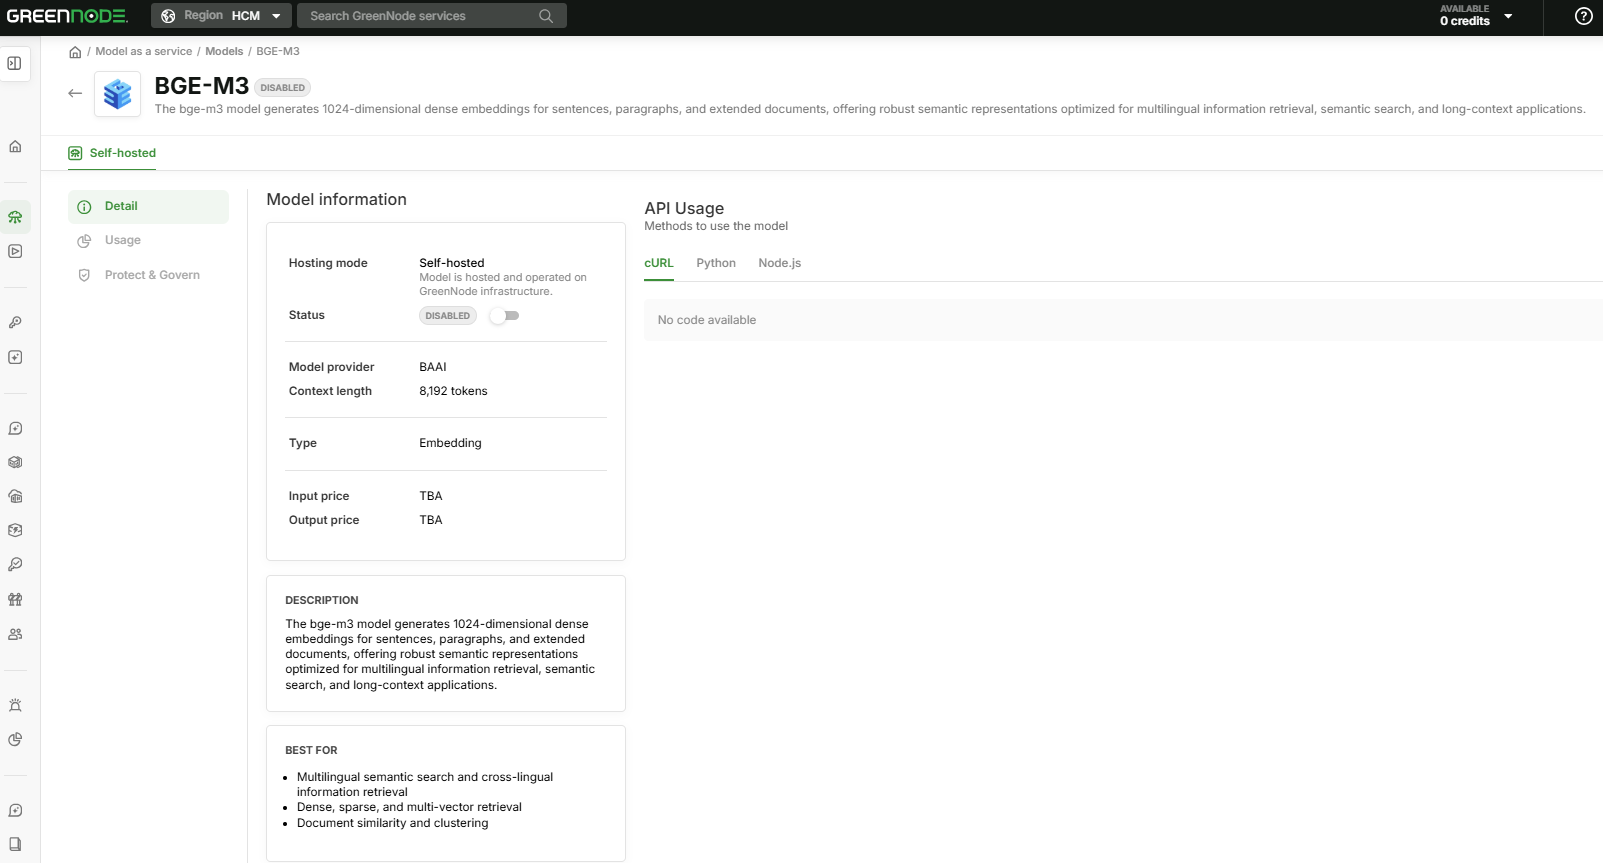
Khám phá BGE-M3 trên GreenNode AI Mass để bắt đầu.
Mistral Embed / Các embedding dựa trên Mixtral
Loại: Mã nguồn mở (Mistral AI)
Phù hợp nhất cho: Tạo embedding nhẹ, tốc độ cao
Tiếp nối thành công của các mô hình ngôn ngữ Mistral, các mô hình Mistral Embed mang lại thông lượng cao cùng khả năng biểu diễn ngữ nghĩa vững chắc cho các tác vụ truy xuất. Kiến trúc của chúng cân bằng giữa độ chính xác và độ trễ, phù hợp cho các ứng dụng RAG thời gian thực.
Điểm nổi bật:
- Độ trễ thấp hơn so với các mô hình mở có kích thước lớn hơn
- Được tinh chỉnh cho các tác vụ tìm kiếm ngữ nghĩa và re-ranking
- Hiệu quả khi triển khai trên các node GPU nhỏ hơn
Trường hợp sử dụng: Các AI copilot hoặc hệ thống hỗ trợ khách hàng thời gian thực, cần embedding truy vấn và sinh phản hồi nhanh chóng.
Dòng OpenAI Text-Embedding 3
Loại: API độc quyền
Phù hợp nhất cho: RAG sẵn sàng cho production với hạ tầng ổn định
Các mô hình text-embedding-3-small và text-embedding-3-large mang lại hiệu năng hàng đầu cho truy xuất tiếng Anh và đa ngôn ngữ. Dù là mã nguồn đóng, độ tin cậy, khả năng mở rộng và độ trễ ổn định khiến chúng trở thành một trong những lựa chọn phổ biến nhất trong các hệ thống production.
Điểm nổi bật:
- Embedding 3.072 chiều với độ trung thực ngữ nghĩa cao
- API ổn định, dễ dàng tích hợp với các vector database (Pinecone, Qdrant, Weaviate)
- Hiệu năng mạnh trên MTEB cũng như các benchmark nội bộ của doanh nghiệp
Trường hợp sử dụng: Các doanh nghiệp ưu tiên sự dễ sử dụng, độ ổn định vận hành (uptime) và khả năng mở rộng được quản lý sẵn, thay vì tự kiểm soát hạ tầng on-premise.
Cohere Embed v3
Loại: API độc quyền
Phù hợp nhất cho: RAG doanh nghiệp với khả năng hỗ trợ tốt cho văn bản đầu vào dài
Các mô hình Embed v3 của Cohere được tinh chỉnh cho việc truy xuất tài liệu dài và phân cụm ngữ nghĩa, cho phép truy xuất chính xác từ knowledge base hoặc file PDF. Chúng cũng có thể truy cập qua API, phù hợp với các nhà phát triển ưa thích hạ tầng được quản lý hoàn toàn.
Điểm nổi bật:
- Hỗ trợ đầu vào lên đến 8.192 token
- Cung cấp API fine-tuning theo domain cụ thể
- Được tối ưu cho tìm kiếm ngữ nghĩa và các ứng dụng RAG lai (hybrid)
Trường hợp sử dụng: Các pipeline truy xuất cho những domain đòi hỏi nhiều tri thức như nghiên cứu, giáo dục hoặc tài liệu kỹ thuật.
Các mô hình mới nổi và chuyên biệt khác
Một số embedding model chuyên biệt khác cũng đang thu hút sự chú ý:
- NV-Embed / NV-Retriever (NVIDIA): Được tối ưu cho RAG doanh nghiệp và tăng tốc phần cứng thông qua các microservice NIM.
- GTE-large / GritLM: Các lựa chọn mã nguồn mở mới nổi với hiệu năng MTEB cạnh tranh.
- LaBSE / Universal Sentence Encoder: Các mô hình đã được kiểm chứng qua thời gian cho RAG đa ngôn ngữ và tìm kiếm dịch thuật.
Các mô hình này đặc biệt hữu ích cho những nhu cầu hạ tầng cụ thể hoặc khi tích hợp với các môi trường serving được tối ưu cho GPU.
Cách chọn đúng Embedding Model cho hệ thống RAG của bạn
Việc chọn đúng embedding model không phải là chọn lựa chọn “mạnh nhất”, mà là tìm ra mô hình phù hợp nhất với trường hợp sử dụng, hạ tầng và dữ liệu của bạn. Mô hình tốt nhất cho một chatbot có thể không phù hợp với một trợ lý nghiên cứu hay hệ thống truy xuất tài liệu. Dưới đây là bốn góc nhìn thực tiễn giúp bạn đưa ra lựa chọn đúng đắn.
Quyết định dựa trên trường hợp sử dụng
Các ứng dụng RAG khác nhau sẽ khai thác embedding theo những cách khác nhau:
Hỏi đáp (QA): Chọn các mô hình được tối ưu cho độ chính xác ngữ nghĩa và khả năng hiểu ngữ cảnh, như E5-Large hoặc BGE-M3. Chúng xử lý tốt các truy vấn ngắn và truy xuất chính xác các đoạn văn bản hỗ trợ.
Truy xuất tài liệu / Tìm kiếm tri thức: Đối với các hệ thống quét qua hàng nghìn tài liệu dài, hãy ưu tiên các mô hình hỗ trợ cửa sổ ngữ cảnh dài hơn và recall cao. Cohere Embed v3 hoặc OpenAI Embedding 3-Large là những lựa chọn mạnh mẽ.
Pipeline tóm tắt: Sử dụng embedding có khả năng phân cụm ngữ nghĩa tốt để nhóm các đoạn văn bản liên quan trước khi tạo bản tóm tắt. BGE-base hoặc Mistral Embed hoạt động tốt trong việc phân cụm và nhóm ngữ cảnh.
Trợ lý hội thoại / Chat: Tìm các mô hình có độ trễ thấp, phù hợp cho xử lý truy vấn thời gian thực. Mistral Embed hoặc E5-Small cân bằng tốt giữa độ chính xác và tốc độ cho các giao diện chat production.
Mẹo: Nếu bạn dự định xây dựng các ứng dụng RAG đa chức năng (ví dụ: QA + tóm tắt), hãy benchmark embedding trên tất cả các workflow mục tiêu trước khi quyết định.
Đánh đổi giữa ngân sách, chi phí và hiệu năng
Chi phí embedding có thể tăng lên nhanh chóng - đặc biệt khi xử lý hàng triệu tài liệu hoặc phục vụ liên tục các truy vấn của người dùng. Bạn cần cân nhắc giữa độ chính xác và chi phí:
- Các mô hình mã nguồn mở (như E5, BGE hoặc Mistral Embed) mang lại giá trị tuyệt vời cho các đội ngũ có thể tự quản lý hosting và inference.
- Các API thương mại (như OpenAI hoặc Cohere) giúp đơn giản hóa việc tích hợp nhưng tính phí theo mỗi 1.000 token, có thể cộng dồn đáng kể trong các hệ thống xử lý nhiều dữ liệu.
Nếu bạn dự đoán khối lượng truy vấn lớn hoặc cần lập chỉ mục cho tập dữ liệu khổng lồ, hãy cân nhắc:
- Kích thước vector nhỏ hơn (ví dụ: 384-768 chiều) để giảm chi phí lưu trữ và tính toán.
- Batch encoding và các pipeline bất đồng bộ để tối ưu thông lượng.
Quy tắc tham khảo: Bắt đầu với các mô hình mở để thử nghiệm, sau đó nâng cấp lên các API được quản lý khi chi phí và quy mô đã trở nên có thể dự đoán được.
Giới hạn về hạ tầng
Hạ tầng hiện có của bạn ảnh hưởng lớn đến việc bạn có thể triển khai mô hình nào một cách hiệu quả.
Bộ nhớ GPU: Các mô hình cao cấp như E5-Large hoặc OpenAI 3-Large đòi hỏi lượng VRAM đáng kể (≥24 GB) để xử lý batch hiệu quả. Với GPU nhỏ hơn, hãy chọn các phiên bản E5-Small hoặc BGE-Base.
Vector Database: Việc lựa chọn vector DB (Pinecone, Weaviate, Chroma, Qdrant) quyết định cách kích thước embedding và quy mô lập chỉ mục ảnh hưởng đến độ trễ.
- Vector số chiều thấp hơn = tìm kiếm nhanh hơn, kích thước index nhỏ hơn.
- Vector số chiều cao hơn = ngữ nghĩa phong phú hơn, nhưng tìm kiếm chậm hơn và tốn nhiều bộ nhớ hơn.
Môi trường triển khai: Nếu bạn vận hành trên hạ tầng cloud như AWS hay GCP, các dịch vụ được quản lý với khả năng tự động mở rộng (ví dụ: Pinecone hoặc Vertex AI Matching Engine) giúp việc mở rộng quy mô trở nên đơn giản hơn. Đối với AI chủ quyền hoặc triển khai on-premise, hãy cân nhắc các giải pháp tự host với FAISS hoặc Milvus để có nhiều quyền kiểm soát hơn.
Chiến lược thích ứng theo domain và fine-tuning
Các embedding model dùng ngay “out-of-the-box” được huấn luyện trên dữ liệu web tổng quát, phù hợp cho các tác vụ diện rộng, nhưng thường yếu về thuật ngữ chuyên ngành. Fine-tuning giúp căn chỉnh embedding cho phù hợp với kho dữ liệu nội bộ của bạn.
Fine-tuning theo domain cụ thể: Sử dụng các framework như SentenceTransformers hoặc Hugging Face PEFT để fine-tune trên các cặp câu hỏi-trả lời hoặc tài liệu từ domain của bạn (pháp lý, y tế, tài chính, v.v.).
Kỹ thuật tiết kiệm tham số: Áp dụng LoRA hoặc adapter tuning để cải thiện khả năng thích ứng theo domain mà không cần huấn luyện lại toàn bộ mô hình.
Học liên tục: Làm mới embedding định kỳ nếu dữ liệu của bạn thường xuyên thay đổi (ví dụ: các cập nhật về quy định hoặc khoa học).
Ví dụ: Một công ty trong lĩnh vực y tế fine-tune BGE-base trên các bản tóm tắt nghiên cứu nội bộ đã ghi nhận mức tăng 15-20% về độ chính xác truy xuất đối với các truy vấn lâm sàng.
Tóm lại, khi chọn embedding model cho hệ thống RAG của bạn:
- Chọn quy mô mô hình phù hợp với trường hợp sử dụng và hạ tầng của bạn.
- Cân bằng giữa độ chính xác với độ trễ và chi phí.
- Fine-tune để phù hợp với domain bất cứ khi nào có thể.
Không có một embedding model “tốt nhất” duy nhất nào cả - chỉ có mô hình phù hợp nhất với mục tiêu truy xuất, domain dữ liệu và giới hạn vận hành của riêng bạn.
Khám phá GreenMind Embedding: Biến văn bản thành trí tuệ có ý nghĩa
Các hệ thống AI hiện đại không chỉ cần đọc được văn bản - chúng cần hiểu được văn bản. Đó chính là lúc GreenMind Embedding (GreenNode-Embedding-Large-1007) phát huy vai trò của mình.
Được phát triển bởi GreenNode AI, GreenMind Embedding là một text embedding model quy mô lớn, được xây dựng để chuyển đổi văn bản thành các vector số nhiều chiều, lưu giữ được ý nghĩa ngữ nghĩa sâu sắc. Thay vì chỉ dựa vào việc khớp từ khóa ở mức bề mặt, mô hình này nắm bắt được ngữ cảnh, ý định và mối quan hệ giữa các đoạn văn bản, khiến nó trở thành một thành phần cốt lõi cho các hệ thống tìm kiếm và truy xuất thông minh.

Được xây dựng vì chất lượng, không chỉ vì tốc độ
Kiến trúc Large của GreenNode-Embedding-Large-1007 được tối ưu cho chất lượng embedding và độ chính xác ngữ nghĩa. So với các embedding model nhỏ hơn hoặc đã được nén lại, nó tạo ra các vector dày đặc và biểu cảm hơn - mang lại hiệu năng vượt trội rõ rệt trong các tác vụ tìm kiếm tương đồng, phân cụm và phân loại.
Phiên bản 1007 đại diện cho một bản phát hành ổn định, sẵn sàng cho production, được tinh chỉnh cho các khối lượng công việc thực tế, nơi tính nhất quán và độ tin cậy quan trọng không kém gì năng lực thô của mô hình.
Những thế mạnh của GreenMind Embedding
GreenMind Embedding được thiết kế dành cho các đội ngũ xây dựng sản phẩm AI cần khả năng hiểu văn bản ở quy mô lớn, bao gồm:
- Tìm kiếm ngữ nghĩa trả về kết quả dựa trên ý nghĩa, không chỉ dựa trên từ khóa
- Truy xuất và xếp hạng thông tin nâng cao cho knowledge base và pipeline RAG
- Phân cụm và phân loại các tập dữ liệu văn bản lớn
- Hệ thống gợi ý dựa trên độ tương đồng ngữ nghĩa
- Các ứng dụng đòi hỏi khả năng hiểu tinh tế về mức độ tương đồng và ngữ cảnh của văn bản
Một thành phần cốt lõi cho AI production
Từ tìm kiếm doanh nghiệp cho đến các tầng bộ nhớ và truy xuất của agent, GreenMind Embedding cung cấp một nền tảng ngữ nghĩa đáng tin cậy cho các hệ thống AI hiện đại. Bằng cách mã hóa ngôn ngữ thành các embedding phong phú và có ý nghĩa, nó cho phép các mô hình và ứng dụng ở tầng sau suy luận trên văn bản với độ chính xác cao hơn nhiều - thu hẹp khoảng cách giữa ngôn ngữ thô và trí tuệ thực sự.
Trải nghiệm GreenMind Embedding ngay hôm nay
Sẵn sàng để thấy sự khác biệt mà embedding chất lượng cao mang lại? Đăng nhập vào nền tảng GreenNode để khám phá GreenMind Embedding, chạy thử với văn bản của riêng bạn và đánh giá hiệu năng thực tế chỉ trong vài phút.
