
Key Takeaways
- LLM về bản chất là statelesstateless, không có memory layer, agent sẽ bắt đầu lại từ đầu mỗi phiên làm việc. Nhồi toàn bộ lịch sử vào context window không phải giải pháp; kiến trúc memory chọn lọc theo từng fact có thể giảm chi phí token hơn 90% và giảm latency 91% so với full-history prompting.
- AI agent sản xuất cần kiến trúc memory 4 tầng: working memory (phiên hiện tại), episodic memory (nhật ký hoạt động), semantic memory (facts và preferences đã trích xuất), và procedural memory (quy trình và best practices), mỗi tầng đảm nhiệm vai trò riêng biệt mà không một vector database đơn lẻ nào có thể thay thế.
- Memory là bài toán hạ tầng, không chỉ là bài toán ứng dụng, session leakage, context truncation, embedding drift và memory bloat là những rủi ro trong môi trường production cần được thiết kế từ đầu, bao gồm cả data residency, retrieval latency và kiểm soát truy cập theo tenant.
Bạn đã bao giờ thấy khó chịu khi một AI agent hỏi lại đúng thông tin mà bạn đã trả lời từ tuần trước? Hoặc một chatbot hỗ trợ khách hàng quên sạch lịch sử đơn hàng ngay sau khi session kết thúc? Trong đa số trường hợp, đây không phải là lỗi của model mà là vấn đề ở kiến trúc bộ nhớ của hệ thống.
Về bản chất, LLM là stateless. Mỗi lần gọi model gần như là một lần bắt đầu lại từ đầu, trừ những gì bạn chủ động đưa vào context của phiên hiện tại. Điều đó có nghĩa là nếu không có cơ chế memory rõ ràng, agent sẽ không thể giữ được thông tin quan trọng qua nhiều phiên làm việc.
Ở giai đoạn cân nhắc triển khai, câu hỏi không còn là “có cần memory hay không” mà là: doanh nghiệp nên thiết kế persistent memory như thế nào để agent nhớ đúng thứ cần nhớ, truy xuất đủ nhanh và vẫn kiểm soát được chi phí vận hành?
Vì sao context window không thể thay thế long-term memory?
Context window và long-term memory giải quyết hai bài toán khác nhau. Context window chỉ giúp model nhìn thấy những gì đang diễn ra trong phiên hiện tại, còn memory dài hạn mới giúp agent giữ lại facts, preferences, history và workflow context qua nhiều phiên làm việc.
| Tiêu chí | Context window | Long-term memory |
|---|---|---|
| Phạm vi | Trong một phiên | Xuyên nhiều phiên |
| Lưu trữ | RAM / in-process | Vector DB / structured DB |
| Chi phí | Tăng theo token | Truy xuất chọn lọc, thấp hơn |
| Độ bền | Mất khi session kết thúc | Persistent, có thể cập nhật |
Đây là lý do nhiều team gặp trần chi phí rất sớm khi cố “nhét” toàn bộ lịch sử vào prompt. Theo nghiên cứu Mem0 công bố năm 2025, kiến trúc bộ nhớ chọn lọc có thể giúp giảm hơn 90% token cost và giảm 91% p95 latency so với cách nạp full-history context.
Kiến trúc 4 tầng bộ nhớ cho AI agent production
Trong các hệ thống agent triển khai thực tế, bộ nhớ thường được tách thành nhiều tầng với vai trò khác nhau thay vì dồn hết vào một vector database. Cách phân tầng này giúp hệ thống dễ mở rộng hơn, dễ debug hơn và phù hợp hơn với governance ở môi trường enterprise.
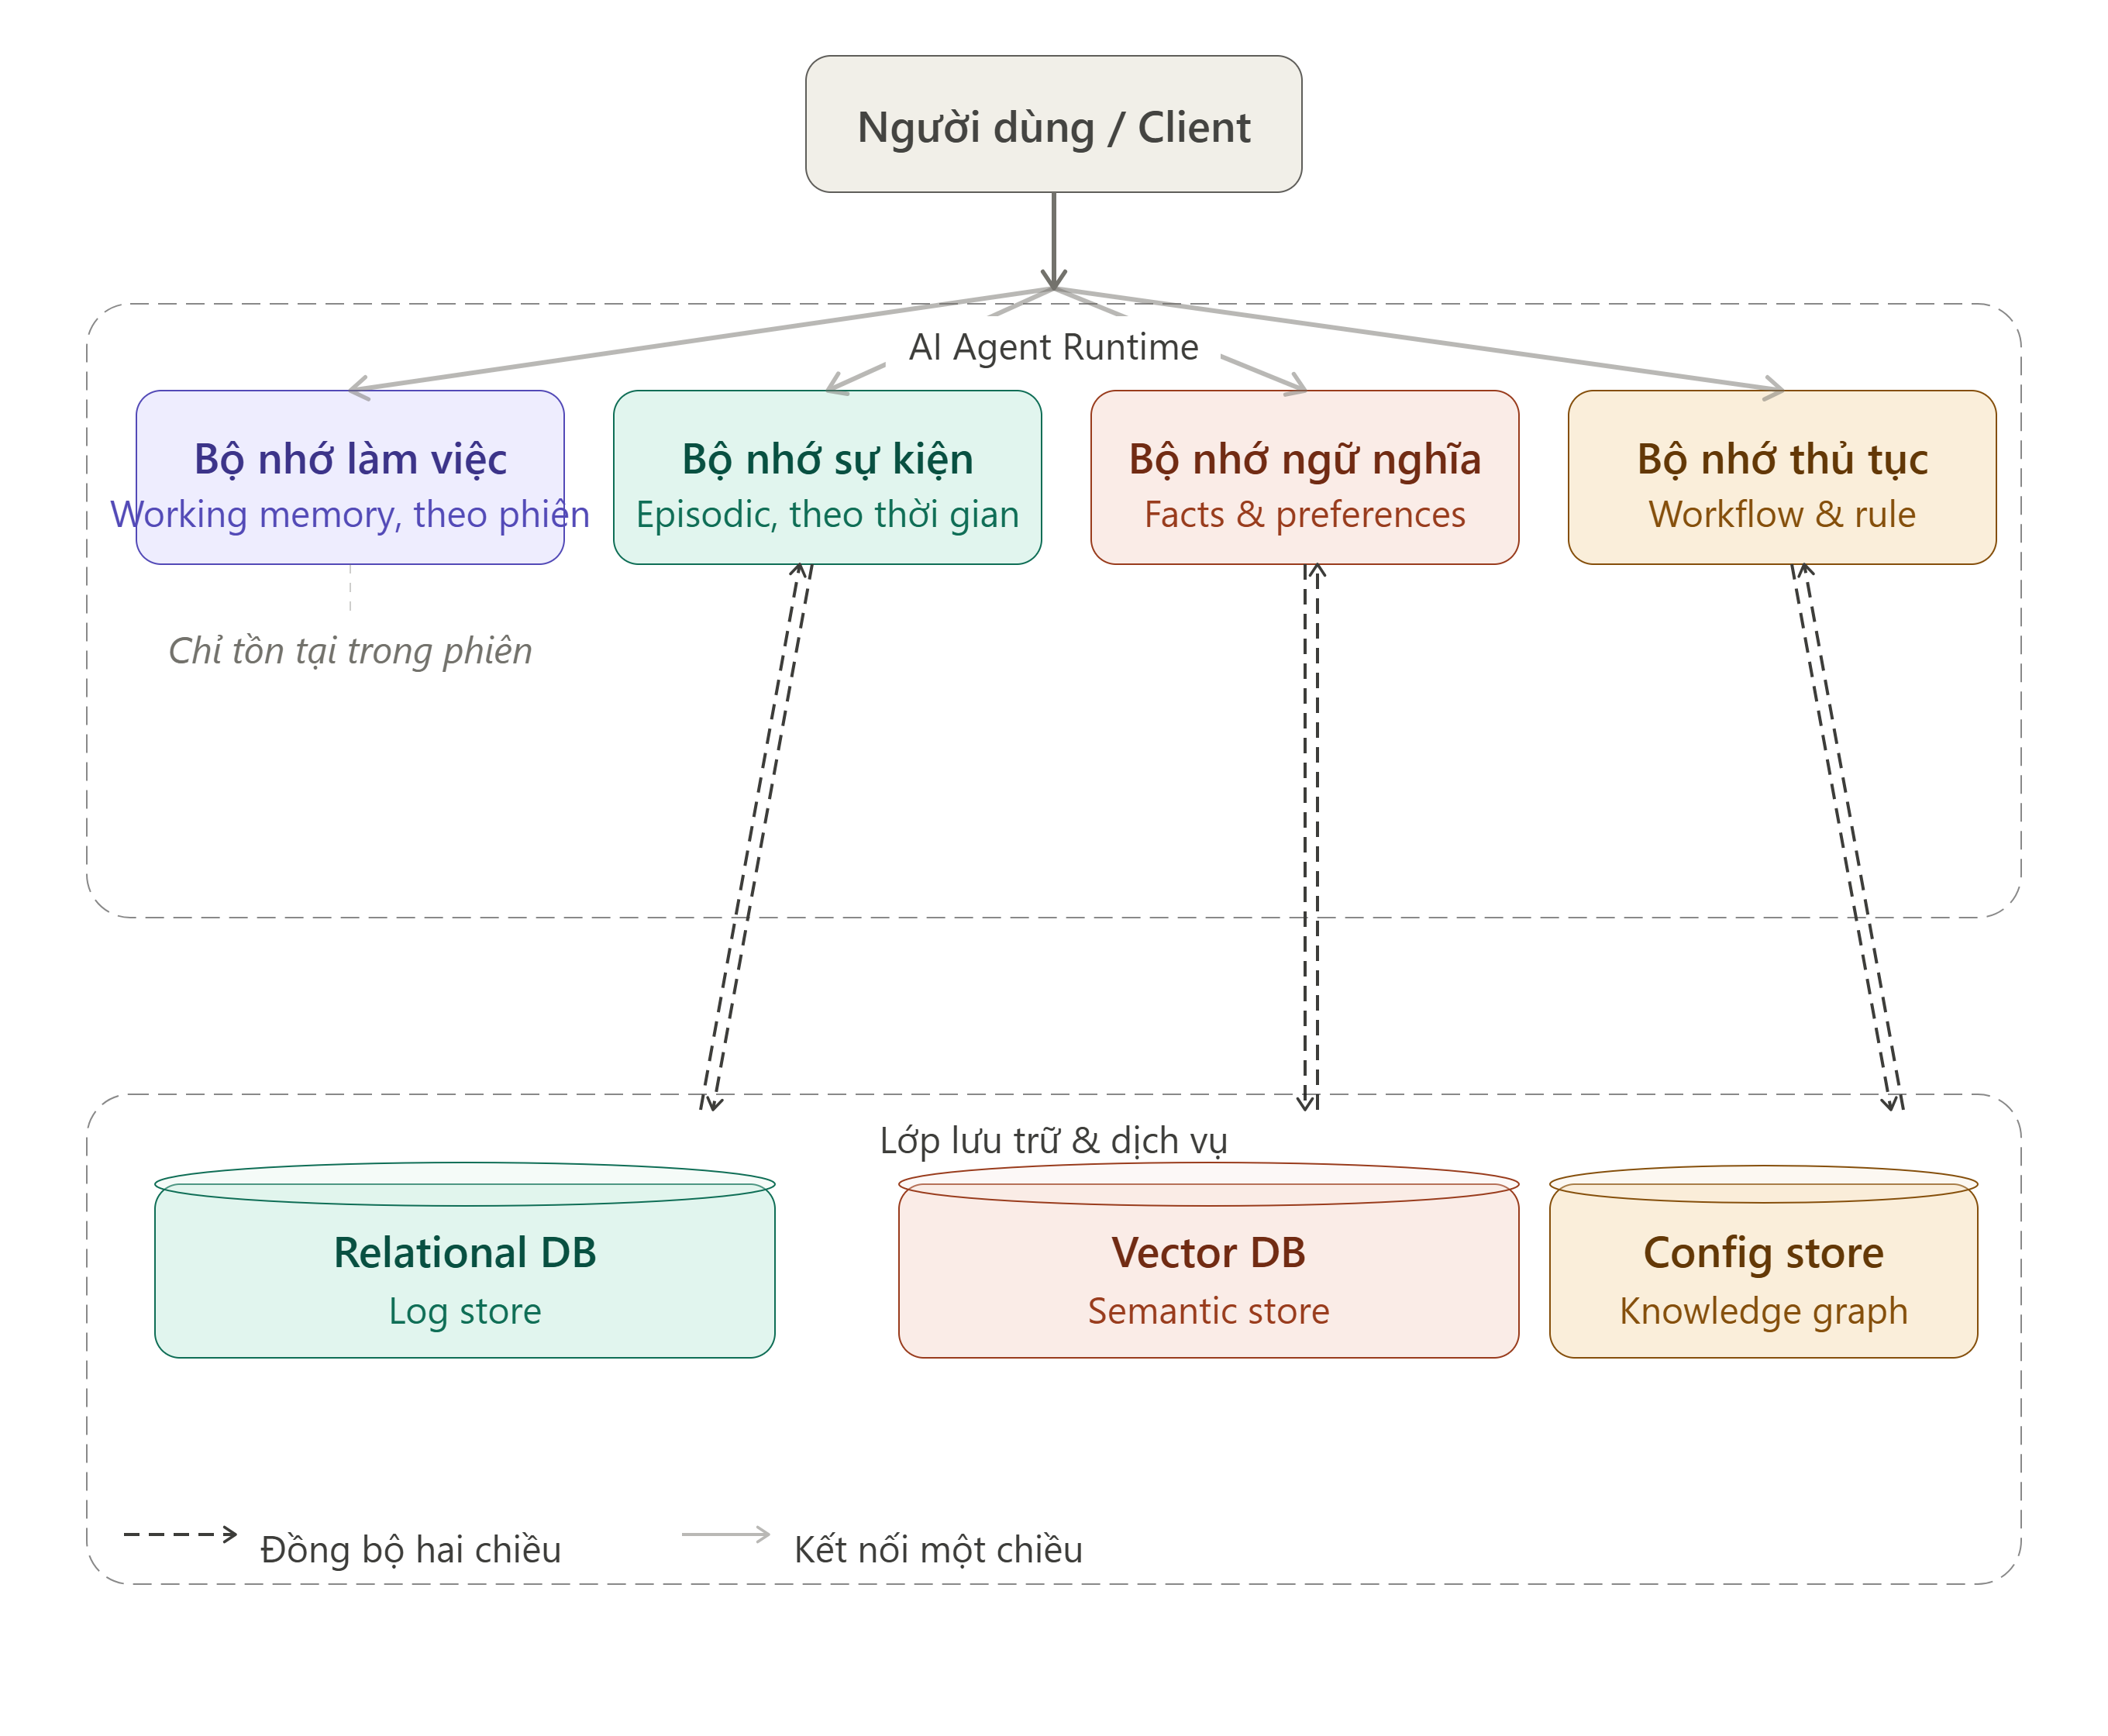
1. Working memory
Đây là bộ nhớ ngắn hạn trong phiên hiện tại. Nó bao gồm vài turn hội thoại gần nhất, kết quả tool call, trạng thái task đang xử lý và các dữ liệu tạm cần cho reasoning ngay lúc đó.
Working memory thường nằm trong RAM của tiến trình agent và bị xóa khi session kết thúc. Nó rất cần thiết để agent xử lý được tác vụ hiện tại, nhưng không đủ để tạo ra trải nghiệm “nhớ người dùng” giữa nhiều phiên.
2. Episodic memory
Episodic memory lưu lại các sự kiện đã xảy ra theo dòng thời gian: user đã hỏi gì, agent đã làm gì, kết quả ra sao, có lỗi gì phát sinh. Có thể xem đây là nhật ký hoạt động của agent qua từng phiên.
Tầng này đặc biệt hữu ích cho audit, debugging và replay. Tuy nhiên, nếu dùng trực tiếp toàn bộ episodic history để reasoning, bạn sẽ kéo theo rất nhiều noise không cần thiết.
3. Semantic memory
Semantic memory là tầng quan trọng nhất nếu bạn muốn agent không bị “quên”. Thay vì lưu raw conversation, hệ thống trích xuất các facts và preferences quan trọng rồi lưu chúng dưới dạng structured data hoặc semantic facts để truy xuất ở phiên sau.
Ví dụ, agent có thể nhớ rằng một user thích báo cáo bằng tiếng Việt, một dự án đang ở giai đoạn migration Q3, hoặc một khách hàng có yêu cầu SLA đặc biệt. Đây là những thông tin có giá trị lâu dài và có tác động trực tiếp đến cách agent phản hồi ở lần tương tác tiếp theo.
4. Procedural memory
Procedural memory lưu “cách làm” thay vì chỉ lưu “điều gì đã xảy ra”. Đó có thể là workflow đã được kiểm chứng, tool-call pattern ổn định, hoặc các bước recovery khi hệ thống gặp lỗi.
Với enterprise agents, tầng này rất quan trọng vì nó giúp hành vi của agent nhất quán hơn giữa nhiều phiên và nhiều team, thay vì mỗi lần lại xử lý theo một hướng khác nhau.
Bài viết kiến trúc bộ nhớ cho multi-agent systems phân tích chi tiết cách thiết kế từng tầng và khi nào nên dùng shared team memory giữa nhiều agent.
Pipeline trích xuất và hợp nhất bộ nhớ
Việc lưu raw conversation vào vector DB là sai lầm phổ biến. Mỗi turn chat đều có nhiều token "noise" (filler phrases, repetition, meta-commentary) không mang giá trị ngữ nghĩa lâu dài.
Pipeline đúng gồm 3 bước:
Fact extraction: Chạy một LLM phụ (hoặc một prompt chuyên biệt) cuối mỗi session để parse ra các entity quan trọng. Ví dụ: {"user_preference": "ưa báo cáo dạng bảng", "project": "migration sang cloud Q3", "constraint": "budget < 500M VND"}. Chỉ những facts có actionable value mới được lưu.
Vectorization: Embed từng fact bằng model như text-embedding-3-small hoặc nomic-embed-text. Tag thêm metadata: user_id, timestamp, topic, confidence_score.
Deduplication và update: Khi fact mới mâu thuẫn với fact cũ (ví dụ: user đổi yêu cầu), cần logic để overwrite thay vì stack thêm. Mem0 xử lý việc này bằng contradiction detection, đạt score 92.5 trên benchmark LoCoMo.
Framework RAG và Agentic RAG cho low-latency cho thấy cách kết hợp retrieval với agent execution mà không làm tăng latency ở inference.
Retrieval đúng mới làm memory có giá trị
Một agent không nên nạp toàn bộ memory vào prompt ở đầu mỗi phiên. Điều đúng hơn là chỉ retrieve những facts liên quan nhất với intent hiện tại, rồi inject chúng vào system prompt dưới dạng block có cấu trúc.
Trong thực tế, nhiều hệ thống dùng dense retrieval cho truy vấn ngữ nghĩa và hybrid retrieval cho các trường hợp vừa có keyword vừa có meaning. Mục tiêu không phải là lưu càng nhiều càng tốt, mà là lấy đúng đúng lúc và đúng scope người dùng.
[MEMORY CONTEXT]
- User: Nguyễn Văn A, team DevOps tại Công ty B
- Current project: migration Kubernetes lên managed VKS, deadline Q3/2026
- Preferences: báo cáo tiếng Việt, format bảng
- Last session: đã review network policy, còn thiếu storage class
[/MEMORY CONTEXT]
Những lỗi phổ biến khi đưa persistent memory vào production
- Session leakage: dữ liệu của user A bị dùng cho user B do thiếu filter theo user_id hoặc tenant_id khi retrieval.
- Context truncation: memory được retrieve đúng nhưng không còn đủ chỗ trong prompt nên bị cắt mất ở cuối.
- Embedding drift: khi thay embedding model mà không re-index dữ liệu cũ, độ chính xác của retrieval sẽ giảm theo thời gian.
- Memory bloat: không có retention policy hoặc pruning job, khiến vector store tích lũy hàng triệu facts lỗi thời.
Đây là lý do memory không nên được xem là một tính năng nhỏ thêm vào sau cùng. Nếu bạn định đưa AI agent vào workflow thật, memory nên được thiết kế ngay từ đầu như một phần của runtime architecture.
Bài designing production-ready architecture for AI agents phân tích thêm về observability và monitoring để phát hiện các lỗi memory ở production.
Góc nhìn consideration stage: doanh nghiệp nên đánh giá gì trước khi triển khai?
Nếu team của bạn đang ở giai đoạn đánh giá giải pháp, có bốn câu hỏi quan trọng nên trả lời sớm. Câu trả lời cho bốn câu hỏi này sẽ quyết định bạn cần một memory layer đơn giản hay một kiến trúc đầy đủ hơn.
- Agent có cần nhớ thông tin qua nhiều phiên hay chỉ cần context trong một phiên duy nhất?
- Loại dữ liệu nào cần được lưu lâu dài: facts, preferences, events hay workflow?
- Memory có cần audit, retention policy và phân quyền theo team hay không?
- Latency truy xuất memory và chi phí token có nằm trong giới hạn production hay không?
Nếu use case là customer support, sales assistant, enterprise copilot hoặc internal operations assistant, gần như chắc chắn bạn sẽ cần ít nhất semantic memory và episodic memory. Nếu use case phức tạp hơn, ví dụ nhiều tool và nhiều workflow nội bộ, procedural memory cũng trở thành một phần rất quan trọng.
Triển khai memory trên hạ tầng cloud: điều gì cần lưu ý?
Persistent memory không chỉ là bài toán application logic mà còn là bài toán hạ tầng. Vector database cần latency thấp, pipeline embedding cần throughput đủ lớn, và toàn bộ memory store phải nằm trong mô hình network, governance và data residency mà doanh nghiệp chấp nhận được.
GreenNode AgentBase hiện có Memory module dưới dạng managed service, hỗ trợ lưu conversation history và semantic facts như các lớp memory nền tảng cho AI agents. Điều này giúp team kỹ thuật không phải tự dựng toàn bộ memory infrastructure từ đầu chỉ để đưa agent vào production.
Bộ nhớ tốt là nền tảng của AI agent đáng tin cậy
Một AI agent chỉ thực sự hữu ích khi nó biết người dùng là ai, họ đang làm gì và họ đã đi đến đâu trong workflow. Nếu không có persistent memory, mỗi phiên làm việc sẽ lại bắt đầu từ đầu và trải nghiệm đó rất khó chấp nhận trong môi trường enterprise.
Kiến trúc nhiều tầng gồm working, episodic, semantic và procedural memory là hướng tiếp cận phù hợp hơn cho các team đang muốn đi từ prototype sang production. Vấn đề không phải là có nên dùng memory hay không, mà là nên thiết kế memory đúng ngay từ đầu để tránh nợ kỹ thuật về sau.
Câu hỏi thường gặp (FAQs)
1. Làm thế nào để AI agent không bị quên thông tin giữa các phiên làm việc?
Cách tiếp cận phổ biến là tách bộ nhớ thành nhiều tầng: working memory cho context trong phiên hiện tại, episodic memory cho log các phiên trước, semantic memory để lưu các facts & preferences quan trọng, và procedural memory cho workflow/cách làm chuẩn. Agent chỉ retrieve những facts liên quan nhất từ semantic memory khi bắt đầu phiên mới, rồi inject vào prompt, thay vì cố nhồi toàn bộ lịch sử vào context window.
2. Chỉ dùng context window lớn có đủ thay thế long-term memory không?
Không. Context window lớn giúp giữ được nhiều thông tin hơn trong một phiên, nhưng không giải quyết được bài toán lưu trữ và truy xuất xuyên phiên. Ngoài ra, chi phí token tăng tuyến tính theo độ dài context và latency cũng cao hơn, trong khi persistent memory cho phép truy xuất chọn lọc, rẻ hơn và bền vững hơn về mặt kiến trúc.
3. Semantic memory khác gì so với lưu raw chat history vào vector database?
Semantic memory chỉ lưu những facts và mối quan hệ có giá trị lâu dài (ví dụ: sở thích của user, constraint của dự án, policy quan trọng) kèm metadata, còn raw chat history chứa rất nhiều noise. Các hệ thống hiện đại thường có bước fact extraction, vector hóa và deduplication trước khi ghi vào store, giúp retrieval chính xác và tránh phình bộ nhớ.
4. Khi nào doanh nghiệp nên đầu tư kiến trúc persistent memory cho AI agent?
Persistent memory trở nên cần thiết khi agent phục vụ các tác vụ đa bước, lặp lại theo thời gian, hoặc yêu cầu cá nhân hóa: ví dụ customer support, internal copilot, trợ lý vận hành cho DevOps/data/BI. Nếu workload chỉ là các nhiệm vụ một lần (single-turn), chi phí triển khai full stack memory có thể không cần thiết; nhưng khi agent phải “nhớ” người dùng và dự án qua nhiều phiên, persistent memory gần như là bắt buộc.
Nếu bạn đang xây dựng agent có yêu cầu về persistent memory và muốn tìm hiểu thêm về kiến trúc production cho AI agent, hoặc muốn triển khai trên hạ tầng có sẵn SLA và hỗ trợ kỹ thuật 24/7, GreenNode AgentBase là điểm khởi đầu thực tế.
