Điểm chính của bài đăng:
- GreenNode chính thức bổ sung NVIDIA H200 Tensor Core GPU và NVIDIA RTX PRO 6000 Blackwell vào danh mục AI Cloud.
- H200 là GPU đầu tiên trang bị 141GB HBM3e với băng thông 4.8 TB/s — gần gấp đôi dung lượng bộ nhớ và cao hơn 1.4 lần băng thông so với H100, lý tưởng cho training, HPC và production LLM.
- RTX PRO 6000 Blackwell mang đến 96GB GDDR7 ECC (gấp 3 lần bộ nhớ so với RTX 5090) và tối ưu tổng chi phí sở hữu (TCO) — tiết kiệm khoảng 32% so với H100 cho các workload inference và fine-tuning.
GreenNode chính thức bổ sung hai dòng GPU thế hệ mới nhất của NVIDIA: NVIDIA H200 Tensor Core GPU và NVIDIA RTX PRO 6000 Blackwell, vào danh mục AI Cloud, mang đến cho doanh nghiệp thêm lựa chọn hạ tầng hiệu năng cao, tối ưu chi phí để triển khai các workload AI hiện đại như huấn luyện mô hình lớn (LLM), fine-tuning, inference quy mô lớn và tính toán hiệu năng cao (HPC).
Việc mở rộng danh mục GPU đánh dấu một bước tiến quan trọng trong hành trình xây dựng nền tảng AI Cloud đẳng cấp hyperscale của GreenNode tại Việt Nam và Đông Nam Á, phục vụ nhu cầu ngày càng cao của các AI startup, doanh nghiệp chuyển đổi số và viện nghiên cứu trên nhiều lĩnh vực, từ tài chính - ngân hàng (BFSI), bán lẻ, game đến truyền thông.
GreenNode bổ sung hai dòng GPU thế hệ mới vào danh mục AI Cloud
Trước đây, hạ tầng GPU của GreenNode đã hỗ trợ nhiều dòng phổ biến như NVIDIA H100 Tensor Core GPU, NVIDIA L40S, NVIDIA A40 và các GPU GeForce RTX 4090/5090. Với việc bổ sung H200 và RTX PRO 6000 Blackwell, danh mục GPU của GreenNode giờ đây trải rộng và mang đến lựa chọn phục vụ đa dạng nhu cầu, từ huấn luyện và tinh chỉnh các mô hình AI quy mô lớn, triển khai inference hiệu năng cao, đến các tác vụ đồ họa, mô phỏng và xử lý dữ liệu chuyên sâu, cho phép khách hàng lựa chọn đúng cấu hình phù hợp với đặc thù workload và ngân sách.
Định hướng cốt lõi của GreenNode với hai dòng GPU mới:
- NVIDIA H200 là tier cao cấp dành cho training, HPC và production LLM — dòng nâng cấp trực tiếp so với H100 với băng thông bộ nhớ cao hơn, đặc biệt phù hợp với các workload memory-intensive.
- NVIDIA RTX PRO 6000 Blackwell với 96GB GDDR7 ECC đột phá, tối ưu cho LLM inference, fine-tuning và đồ họa Omniverse/VFX với chi phí tối ưu.
NVIDIA H200: bước nhảy về bộ nhớ và băng thông cho LLM & HPC
Được xây dựng trên kiến trúc NVIDIA Hopper, NVIDIA H200 là GPU đầu tiên trang bị 141GB bộ nhớ HBM3e với băng thông 4.8 TB/s — gần gấp đôi dung lượng bộ nhớ và cao hơn 1.4 lần băng thông so với NVIDIA H100. Đây chính là yếu tố quyết định giúp H200 xử lý các mô hình ngôn ngữ lớn với ngữ cảnh dài và các workload HPC đòi hỏi băng thông bộ nhớ cực cao.
So với H100, NVIDIA H200 mang lại mức tăng hiệu năng đáng kể:
- Llama 2 70B Inference: nhanh hơn tới 1.9 lần
- GPT-3 175B Inference: nhanh hơn tới 1.6 lần
- High-Performance Computing: nhanh hơn tới 110 lần so với CPU x86 truyền thống
Một số thông số kỹ thuật nổi bật của H200 (phiên bản SXM):
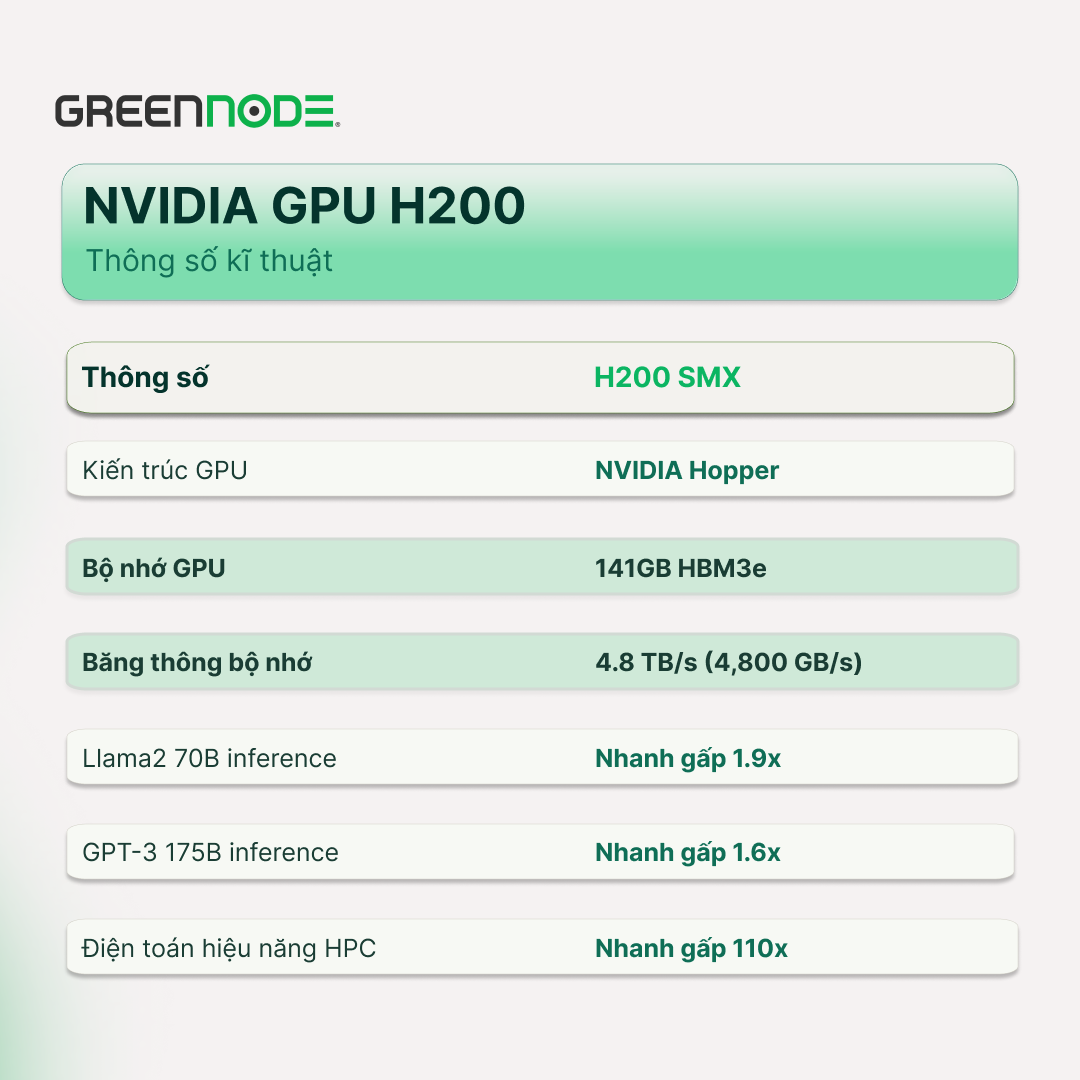
(Thông số mang tính tham khảo, có thể thay đổi. Các chỉ số Tensor Core được đo với sparsity.)
Khám phá bài so sánh chi tiết giữa NVIDIA H100 và NVIDIA H200 để hiểu rõ sự khác biệt về hiệu năng, bộ nhớ và các workload phù hợp.
NVIDIA RTX PRO 6000 Blackwell: 96GB GDDR7 ECC, tối ưu TCO
NVIDIA RTX PRO 6000 Blackwell được xây dựng trên kiến trúc NVIDIA Blackwell mới nhất, mang đến sự cân bằng ấn tượng giữa hiệu năng AI, khả năng đồ họa chuyên nghiệp và tối ưu tổng chi phí sở hữu. Với 96GB bộ nhớ GDDR7 ECC cùng 24,064 nhân CUDA và Tensor Core thế hệ 5, đây là lựa chọn lý tưởng cho các workload LLM inference, fine-tuning và đồ họa Omniverse/VFX.
So với thế hệ trước RTX 6000 Ada, RTX PRO 6000 Blackwell mang lại:
- Model Iteration: độ chính xác cao hơn 3 lần
- AI Training: nhanh hơn 2.5 lần so với RTX 6000 Ada
- Mô phỏng CFD: nhanh hơn 4.5 lần
Một số thông số kỹ thuật chính:
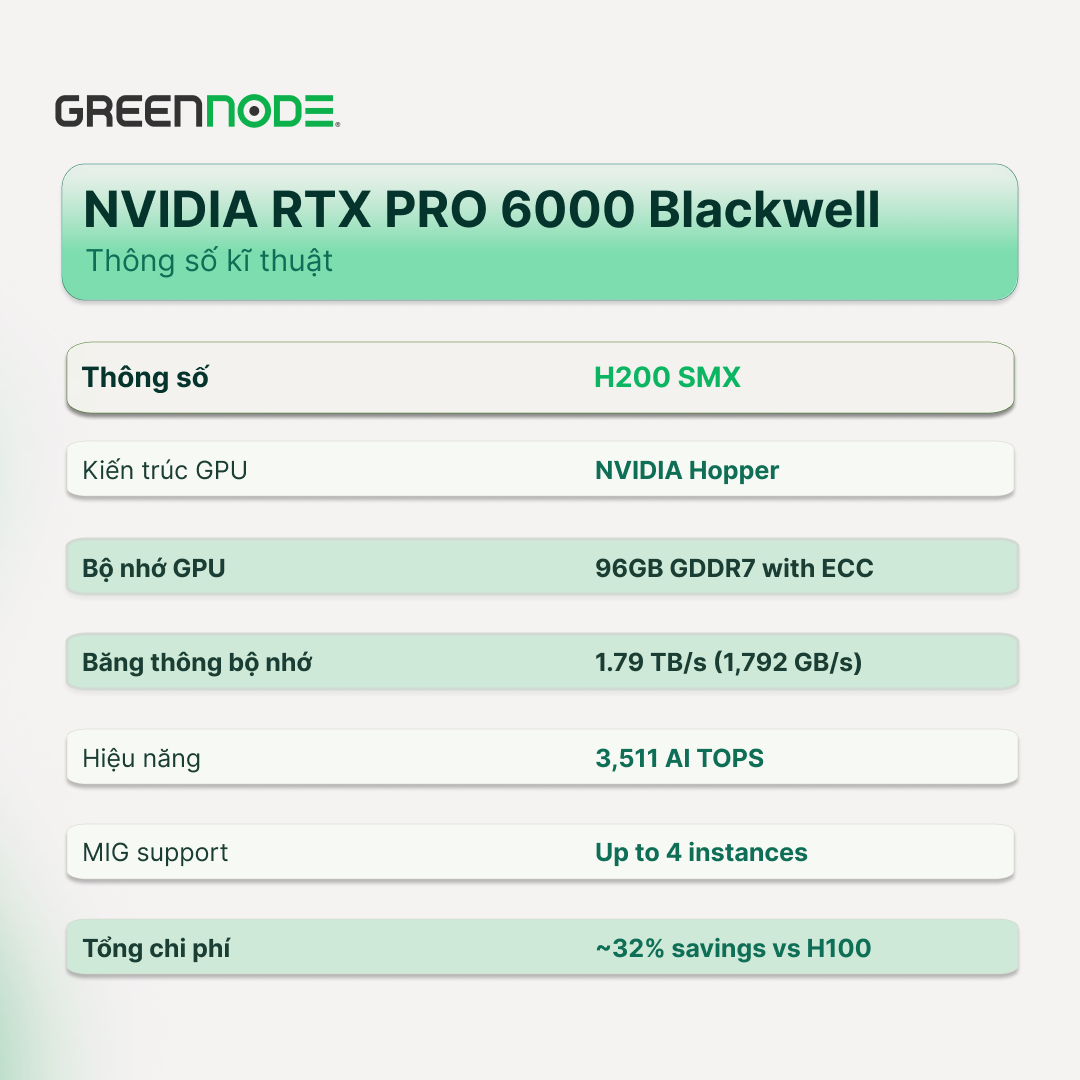
RTX PRO 6000 Blackwell so với các lựa chọn hiện có
| Thông số kỹ thuật chính | GeForce RTX 5090 (Consumer Flagship) | RTX PRO 6000 Blackwell | NVIDIA H100 (Enterprise Datacenter) |
|---|---|---|---|
| Kiến trúc | Blackwell | Blackwell PRO (Workstation/Server) | Hopper (Enterprise) |
| Dung lượng bộ nhớ (VRAM) | 32GB GDDR7 | 96GB GDDR7 ECC (gấp 3 lần) | 80GB HBM3 |
| Băng thông bộ nhớ | ~1.5 TB/s | 1.79 TB/s | 3.35 TB/s |
| Sức mạnh tính toán AI | ~1,600 TOPS (FP8) | 3,511 AI TOPS (hỗ trợ FP4 mới) | ~4,000 TOPS (FP8) |
| Ảo hóa GPU (MIG) | Không hỗ trợ | Tối đa 4 instance | Tối đa 7 MIG instance |
| Tối ưu chi phí (TCO) | Giá rẻ nhưng không có driver doanh nghiệp | Tối ưu vượt trội (~ tiết kiệm 32% so với H100) | Đầu tư ban đầu & vận hành cực cao |
Điểm khác biệt lớn nhất của RTX PRO 6000 Blackwell nằm ở bài toán tổng chi phí sở hữu: dung lượng bộ nhớ gấp 3 lần so với GeForce RTX 5090 nhưng đi kèm driver doanh nghiệp và độ ổn định cấp datacenter, trong khi tiết kiệm khoảng 32% chi phí so với H100 cho các workload inference và fine-tuning.
Danh mục cập nhật GPU của GreenNode: chọn đúng GPU cho từng tác vụ
GreenNode bổ sung 2 GPU cloud mới để doanh nghiệp lựa chọn đúng cấu hình cho từng giai đoạn và loại workload:
| Dòng GPU | Định vị & workload khuyến nghị |
|---|---|
| NVIDIA H200 (mới) | Phân khúc cao cấp dành cho huấn luyện mô hình trên 100 tỷ tham số, tính toán hiệu năng cao (HPC) và triển khai LLM ngữ cảnh dài trong môi trường sản xuất. Bộ nhớ 141GB HBM3e đáp ứng hiệu quả các ứng dụng ngữ cảnh dài (long-context) và hệ thống đa tác nhân (multi-agent). |
| RTX PRO 6000 Blackwell (mới) | Phù hợp cho suy luận (inference) và tinh chỉnh (fine-tuning) các mô hình từ 13B–70B tham số, đồng thời tối ưu cho đồ họa Omniverse/VFX với tổng chi phí sở hữu (TCO) thấp. Trang bị 96GB GDDR7 ECC. |
Với các ngành có yêu cầu cao về bảo mật và tuân thủ như tài chính – ngân hàng (BFSI), việc lựa chọn GPU phù hợp cho từng tác vụ AI – từ phát hiện gian lận theo thời gian thực (real-time fraud detection), xác minh danh tính qua video (video KYC) đến kiểm toán tài chính toàn diện bằng các mô hình ngôn ngữ lớn (LLM) có ngữ cảnh dài – là yếu tố then chốt để tối ưu hiệu năng, chi phí và khả năng mở rộng.
GreenNode tiếp tục mang đến những lựa chọn AI Cloud tối ưu cho doanh nghiệp
GreenNode được thiết kế để phục vụ các workload đòi hỏi hiệu năng tính toán cao, mạng mạnh và độ ổn định của hệ thống. Kết hợp với kiến trúc multi-AZ đa vùng tại Hà Nội, TP. Hồ Chí Minh và Bangkok, hai dòng GPU mới cho phép doanh nghiệp xây dựng hạ tầng AI hiện đại ngay tại Việt Nam với độ sẵn sàng cao và khả năng mở rộng linh hoạt.
Các workload phổ biến bao gồm:
- Pipeline AI / Machine Learning và fine-tuning mô hình lớn
- Hệ thống inference quy mô lớn và production LLM
- Phân tích Big Data (Spark, ClickHouse, Presto)
- Hệ thống backend lưu lượng cao
- Recommendation system và phân tích thời gian thực
Việc bổ sung NVIDIA H200 và RTX PRO 6000 Blackwell tiếp tục củng cố nền tảng AI Cloud hiệu năng cao của GreenNode dành cho doanh nghiệp, giúp các tổ chức triển khai hệ thống AI, nền tảng dữ liệu và ứng dụng quan trọng với độ sẵn sàng cao — trong khi vẫn giữ hạ tầng đặt tại Việt Nam và khu vực.
Liên hệ đội ngũ GreenNode ngay hôm nay để được tư vấn kiến trúc hạ tầng tối ưu và cấu hình GPU phù hợp nhất cho ứng dụng AI của doanh nghiệp bạn.