
Có một vấn đề mà hầu hết các đội kỹ thuật gặp phải khi mở rộng từ một agent đơn lẻ lên hệ thống nhiều agent: các agent bắt đầu "quên" nhau. Agent A thu thập dữ liệu khách hàng, agent B xử lý đơn hàng, agent C viết báo cáo, nhưng không agent nào chia sẻ ngữ cảnh với nhau. Kết quả là toàn bộ pipeline xuất ra những mảnh rời rạc, thiếu nhất quán.
Đây không phải lỗi của model. Đây là lỗi kiến trúc bộ nhớ, cụ thể hơn là lỗi bộ nhớ nhóm.
Nếu bạn chưa quen với các tầng bộ nhớ cơ bản của một agent đơn lẻ (working, episodic, semantic, procedural), bài viết How to Stop Your AI Agents From Forgetting là điểm khởi đầu tốt. Bài này giả định bạn đã nắm được nền tảng đó và đi thẳng vào vấn đề phức tạp hơn: khi có nhiều agent cùng chạy, bộ nhớ cần được chia sẻ, phân vùng và quản trị như thế nào để cả hệ thống phối hợp được.
Theo một bài phân tích của O'Reilly Media (tháng 2/2026), bộ nhớ nhóm không phải tính năng bổ sung sau khi hệ thống agent đã chạy, mà là hạ tầng nền tảng giúp kiến trúc agent phối hợp được.
Tại sao bộ nhớ agent đơn không đủ cho hệ multi-agent
Với agent đơn, persistent memory giải quyết bài toán "nhớ giữa các phiên". Nhưng khi bạn có 5 agent chạy song song, mỗi agent duy trì bộ nhớ riêng biệt tạo ra ba hậu quả khác hẳn:
- Context drift: Agent A và B đọc được hai phiên bản khác nhau của cùng một sự kiện.
- Duplicated work: Agent C làm lại việc agent A đã hoàn thành vì không biết kết quả đã có.
- Incoherent outputs: Orchestrator tổng hợp đầu ra từ các agent không chia sẻ cùng một "sự thật".
Một nghiên cứu trên arXiv (tháng 3/2026) về "Governed Memory" chỉ ra rằng hầu hết các hệ multi-agent thất bại trong production không phải vì model yếu, mà vì thiếu một lớp bộ nhớ chung có quản trị. Đây là bài toán distributed systems, không phải prompt engineering.
Blackboard pattern: "bảng đen" chung cho các agent
Blackboard pattern là kiến trúc chia sẻ ngữ cảnh phổ biến nhất và đáng tin cậy nhất cho hệ multi-agent. Ý tưởng cốt lõi: thay vì agent giao tiếp trực tiếp với nhau, tất cả đọc và ghi vào một không gian chung: "blackboard".
Cách hoạt động trong thực tế:
- Orchestrator khởi tạo task và ghi trạng thái ban đầu lên blackboard.
- Từng agent chuyên biệt giám sát blackboard, xử lý ngay khi thấy input phù hợp với năng lực của mình.
- Kết quả được ghi lại lên blackboard, kèm metadata: agent ID, timestamp, confidence score.
- Orchestrator đọc blackboard để tổng hợp kết quả cuối.
Blackboard pattern giải quyết được vấn đề coupling: agent không cần biết agent khác tồn tại, chỉ cần biết schema của blackboard. Điều này tạo ra tính linh hoạt cao khi thêm agent mới vào hệ thống.
Tuy nhiên, pattern này có một điểm yếu quan trọng: concurrent writes. Khi hai agent cùng ghi vào cùng một entry, cần có cơ chế conflict resolution rõ ràng. Phần này sẽ được đề cập cụ thể ở các phần sau.
Memory scoping: không phải mọi agent đều cần đọc mọi thứ
Một lỗi kiến trúc phổ biến là thiết kế shared memory như một database chung hoàn toàn phẳng, mọi agent đọc được mọi thứ. Điều này dẫn đến hai vấn đề: hiệu năng suy giảm do retrieval noise, và rủi ro bảo mật khi agent xử lý dữ liệu nhạy cảm có thể đọc context không liên quan.
Thực tế production năm 2026 đã hội tụ về một pattern được gọi là memory scoping hoặc "scope chain":
- Global scope: Semantic memory, business rules, shared facts — tất cả agent đọc được, chỉ privileged process mới ghi.
- Workflow scope: Episodic memory của một task cụ thể — chỉ agent trong cùng workflow đọc được.
- Agent scope: Working state riêng của từng agent — không chia sẻ, thường là in-context hoặc Redis key theo agent ID.
Cách triển khai đơn giản nhất: namespace trong vector DB theo {workflow_id}/{agent_id}, kèm permission matrix định nghĩa agent nào có quyền đọc namespace nào. Đây không phải tính năng xa xỉ — đây là yêu cầu tối thiểu cho bất kỳ hệ thống nào chạy dữ liệu khách hàng thực.
Các đội đang xây production-ready architecture cho AI agent thường triển khai memory scoping ngay từ đầu, thay vì refactor sau khi hệ thống đã scale.
Conflict resolution: khi hai agent không đồng ý
Xung đột bộ nhớ xảy ra theo hai dạng: write conflicts (hai agent ghi đồng thời vào cùng entry) và semantic conflicts (hai agent có thông tin mâu thuẫn về cùng một thực thể).
Với write conflicts: giải pháp đã có từ distributed systems — optimistic locking với version vector, hoặc last-write-wins với timestamp cho dữ liệu low-stakes. Với high-stakes data (quyết định tài chính, trạng thái đơn hàng), cần compare-and-swap atomic operation.
Với semantic conflicts, giải pháp phức tạp hơn nhiều. Nghiên cứu trên arXiv (tháng 1/2026) đề xuất kiến trúc "Team of Rivals": thay vì majority voting (agent nào thắng nhiều phiếu thì đúng), sử dụng hierarchy có veto authority. Planner agent đề xuất, Executor agent thực thi, Critic agent có quyền veto và yêu cầu re-planning nếu phát hiện conflict với semantic memory. Cơ chế này buộc hệ thống converge về điểm đồng thuận, thay vì chọn đáp án của agent "mạnh" nhất.
Một rule đơn giản nhưng hiệu quả: không để LLM đứng trên read path. Khi agent truy xuất memory, đừng dùng một LLM khác để "lọc" kết quả truy xuất vì làm như thế sẽ tăng latency và tạo điểm failure mới. Retrieval nên là vector similarity + metadata filter, deterministic và nhanh. LLM chỉ tham gia ở bước synthesis sau khi context đã được assembled.
Coordinated forgetting: memory cũng cần expire
Một khía cạnh thường bị bỏ qua: bộ nhớ nhóm cần chính sách xóa rõ ràng. Không có expiration policy, semantic memory tích lũy stale data và episodic memory phình ra không kiểm soát được sẽ dẫn đến retrieval precision giảm dần theo thời gian.
Ba trigger cho memory deletion:
- TTL-based: Working state tự xóa sau N phút/giờ.
- Event-triggered: Khi workflow kết thúc, xóa workflow-scope memory sau X ngày.
- Importance scoring: Dùng recency × relevance × importance score để rank, xóa entry dưới ngưỡng threshold.
Framework như Mem0 dùng scoring function để tự động chuyển hóa episodic memory thành semantic facts khi độ tin cậy đủ cao, về cơ bản là cách để hệ thống multi-agent "học" từ kinh nghiệm mà vẫn giữ được kiểm soát.
Điểm quan trọng với hệ multi-agent là coordinated forgetting phải nhất quán: nếu agent A xóa một fact khỏi working memory của mình nhưng agent B vẫn giữ bản sao trong workflow-scope memory, hệ thống có thể tiếp tục ra quyết định dựa trên dữ liệu đã lỗi thời. Expiration policy cần được enforce ở cấp memory layer, không phải ở cấp từng agent.
Hạ tầng phù hợp cho workload multi-agent
Bộ nhớ nhóm không chỉ là vấn đề thiết kế phần mềm, nó đặt ra yêu cầu cụ thể về hạ tầng:
- Low-latency reads: Retrieval phải dưới 50ms P95 để không làm nghẽn pipeline agent. Điều này đòi hỏi vector index được optimize (HNSW thay vì IVF flat cho <1M vectors) và compute đặt gần data store.
- Concurrent write throughput: Hệ thống 10 agent ghi song song cần backend chịu được concurrent writes với consistent ordering.
- Horizontal scalability: Khi thêm agent mới, memory layer không nên là bottleneck.
Đây là lý do các đội kỹ thuật ở Việt Nam và Đông Nam Á ngày càng chọn hạ tầng AI cloud có sẵn khả năng GPU tích hợp với low-latency regional deployment. GreenNode cung cấp môi trường phù hợp cho workload này thông qua AI Platform, bao gồm GPU Cloud tối ưu cho inference, managed Kubernetes (VKS) cho container orchestration, và vDB cho database operations — tất cả trong 6 availability zone tại Hà Nội, TP.HCM và Bangkok, giúp latency giữa agent và memory store ở mức chấp nhận được cho production.
Với các đội đang vận hành multi-agent workflows trên hạ tầng tự quản lý và cảm thấy complexity đang vượt tầm kiểm soát, chuyển sang hạ tầng được quản lí (managed infrastructure) thường là quyết định đúng thời điểm.
Checklist triển khai memory nhóm
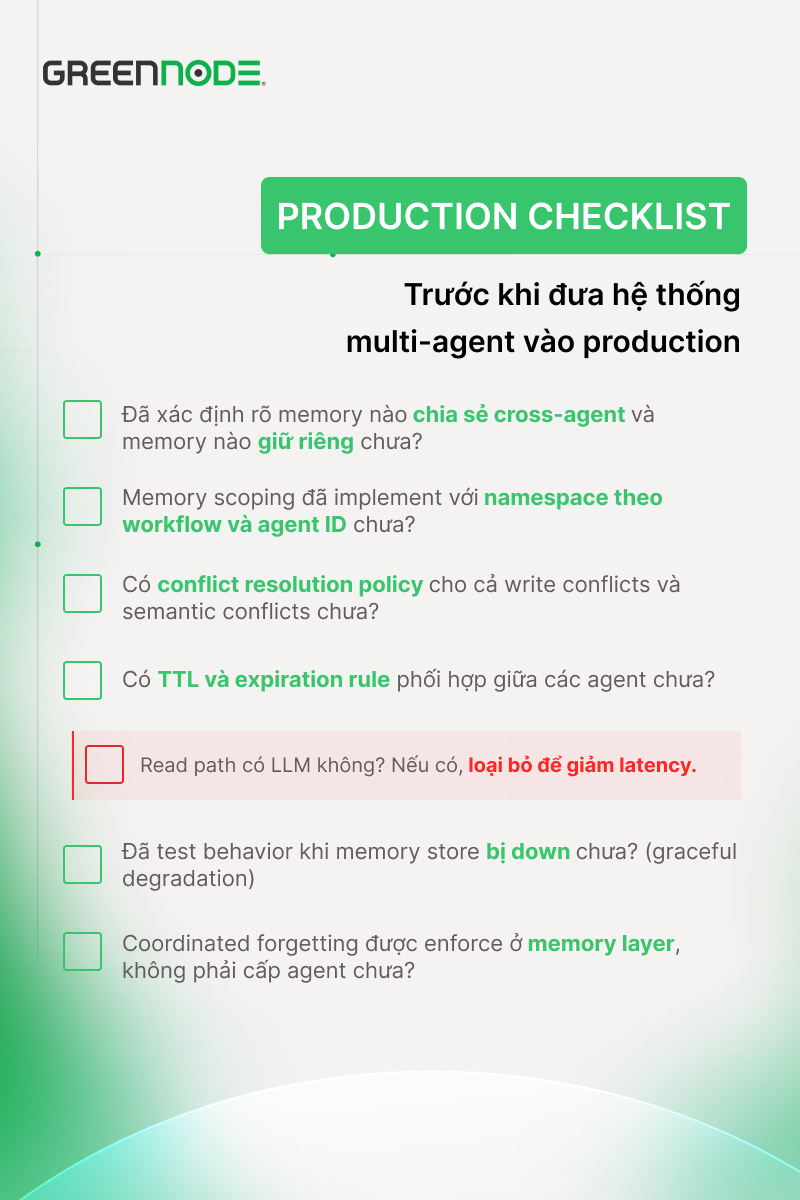
Trước khi đưa hệ thống multi-agent vào production, kiểm tra các điểm sau:
- Đã xác định rõ memory nào cần chia sẻ cross-agent và memory nào giữ riêng chưa?
- Memory scoping đã được implement với namespace theo workflow và agent ID chưa?
- Có conflict resolution policy cho cả write conflicts và semantic conflicts chưa?
- Có TTL và expiration rule phối hợp giữa các agent chưa?
- Read path có LLM không? Nếu có, loại bỏ để giảm latency.
- Đã test behavior khi memory store bị down chưa? (graceful degradation)
- Coordinated forgetting có được enforce ở cấp memory layer, không phải cấp agent chưa?
Thiết kế bộ nhớ nhóm từ sớm là điều phân biệt một hệ thống multi-agent thực sự phối hợp với một tập hợp các agent chạy độc lập. Bỏ qua bước này, dù hệ thống có hoạt động tốt trên lý thuyết, vẫn có thể đổ vỡ ngay khi gặp dữ liệu thực.
Nếu bạn đang xây dựng kiến trúc agentic RAG cho môi trường low-latency hoặc muốn tìm hiểu cách AgentBase handle memory và orchestration cho multi-agent workflows trong production, đó là điểm khởi đầu tốt để đi từ prototype sang hệ thống thực sự vận hành được.
