
Năm 2026, lượng dữ liệu toàn cầu dự kiến chạm ngưỡng 230–240 zettabyte — tăng gần 32% chỉ trong một năm.(Nguồn: Storage in Big Data Market Size & Growth Report 2035) Đằng sau con số khổng lồ đó là hàng nghìn pipeline AI đang chạy liên tục: huấn luyện mô hình ngôn ngữ lớn (LLM), xử lý ảnh y tế, phân tích dữ liệu IoT theo thời gian thực, dự báo nhu cầu bán lẻ. Tất cả đều có chung một điểm nghẽn: hạ tầng lưu trữ.
Câu hỏi mà các CTO, Data Engineer và IT Manager Việt Nam đang đặt ra ngày càng nhiều: "Loại storage nào đủ khả năng nuôi sống một pipeline AI quy mô lớn mà vẫn tối ưu chi phí vận hành doanh nghiệp?"
Câu trả lời, ngày càng được đồng thuận rộng rãi trong giới kỹ thuật, là Object Storage.
1. Object Storage là gì và tại sao nó phù hợp với Big Data & AI?
Object Storage (lưu trữ đối tượng) là kiến trúc lưu trữ dữ liệu theo dạng các object độc lập, mỗi object bao gồm: dữ liệu thực (file, ảnh, video, log), metadata mô tả dữ liệu đó, và một định danh duy nhất (unique ID) để truy xuất.
Không giống file storage với cây thư mục lồng nhau, hay block storage yêu cầu phân vùng cứng nhắc — object storage tổ chức dữ liệu trong không gian phẳng gọi là bucket, cho phép:
Mở rộng không giới hạn từ gigabyte lên petabyte mà không cần thay đổi kiến trúc
Truy cập qua HTTP/S3 API từ bất kỳ ngôn ngữ lập trình hoặc framework nào
Lưu trữ mọi loại dữ liệu phi cấu trúc: ảnh, video, audio, log file, model checkpoint, dataset CSV, parquet
Đây chính xác là những gì pipeline AI cần. Một mô hình deep learning điển hình tiêu thụ hàng trăm GB đến vài TB training data mỗi lần chạy. Dữ liệu đó không có cấu trúc thống nhất, không thể nhét vào database quan hệ, và cần được hàng chục GPU node truy cập song song với throughput cao.
2. Tại sao Object Storage trở thành xương sống của hạ tầng AI hiện đại?
Khảo sát từ MinIO với hơn 600 IT leader toàn cầu năm 2025 cho thấy: object storage đã trở thành công nghệ lưu trữ chiếm ưu thế trong môi trường enterprise — và xu hướng đó đang tăng tốc cùng với nhu cầu AI.
Có năm lý do kỹ thuật giải thích điều này:
2.1. Tách biệt compute và storage (Decoupled Architecture)
Trong kiến trúc AI hiện đại, GPU cluster (compute) và object storage (data) vận hành độc lập nhau. Nhóm data engineer có thể nạp thêm 50TB training data vào storage mà không cần dừng hay tái cấu hình cụm GPU. Ngược lại, đội AI có thể scale thêm GPU để tăng tốc training mà không cần chạm vào lớp storage.
Đây là điều không thể làm được với kiến trúc SAN/NAS truyền thống — nơi storage và compute bị gắn chặt với nhau.
2.2. S3 API — ngôn ngữ chung của hệ sinh thái AI
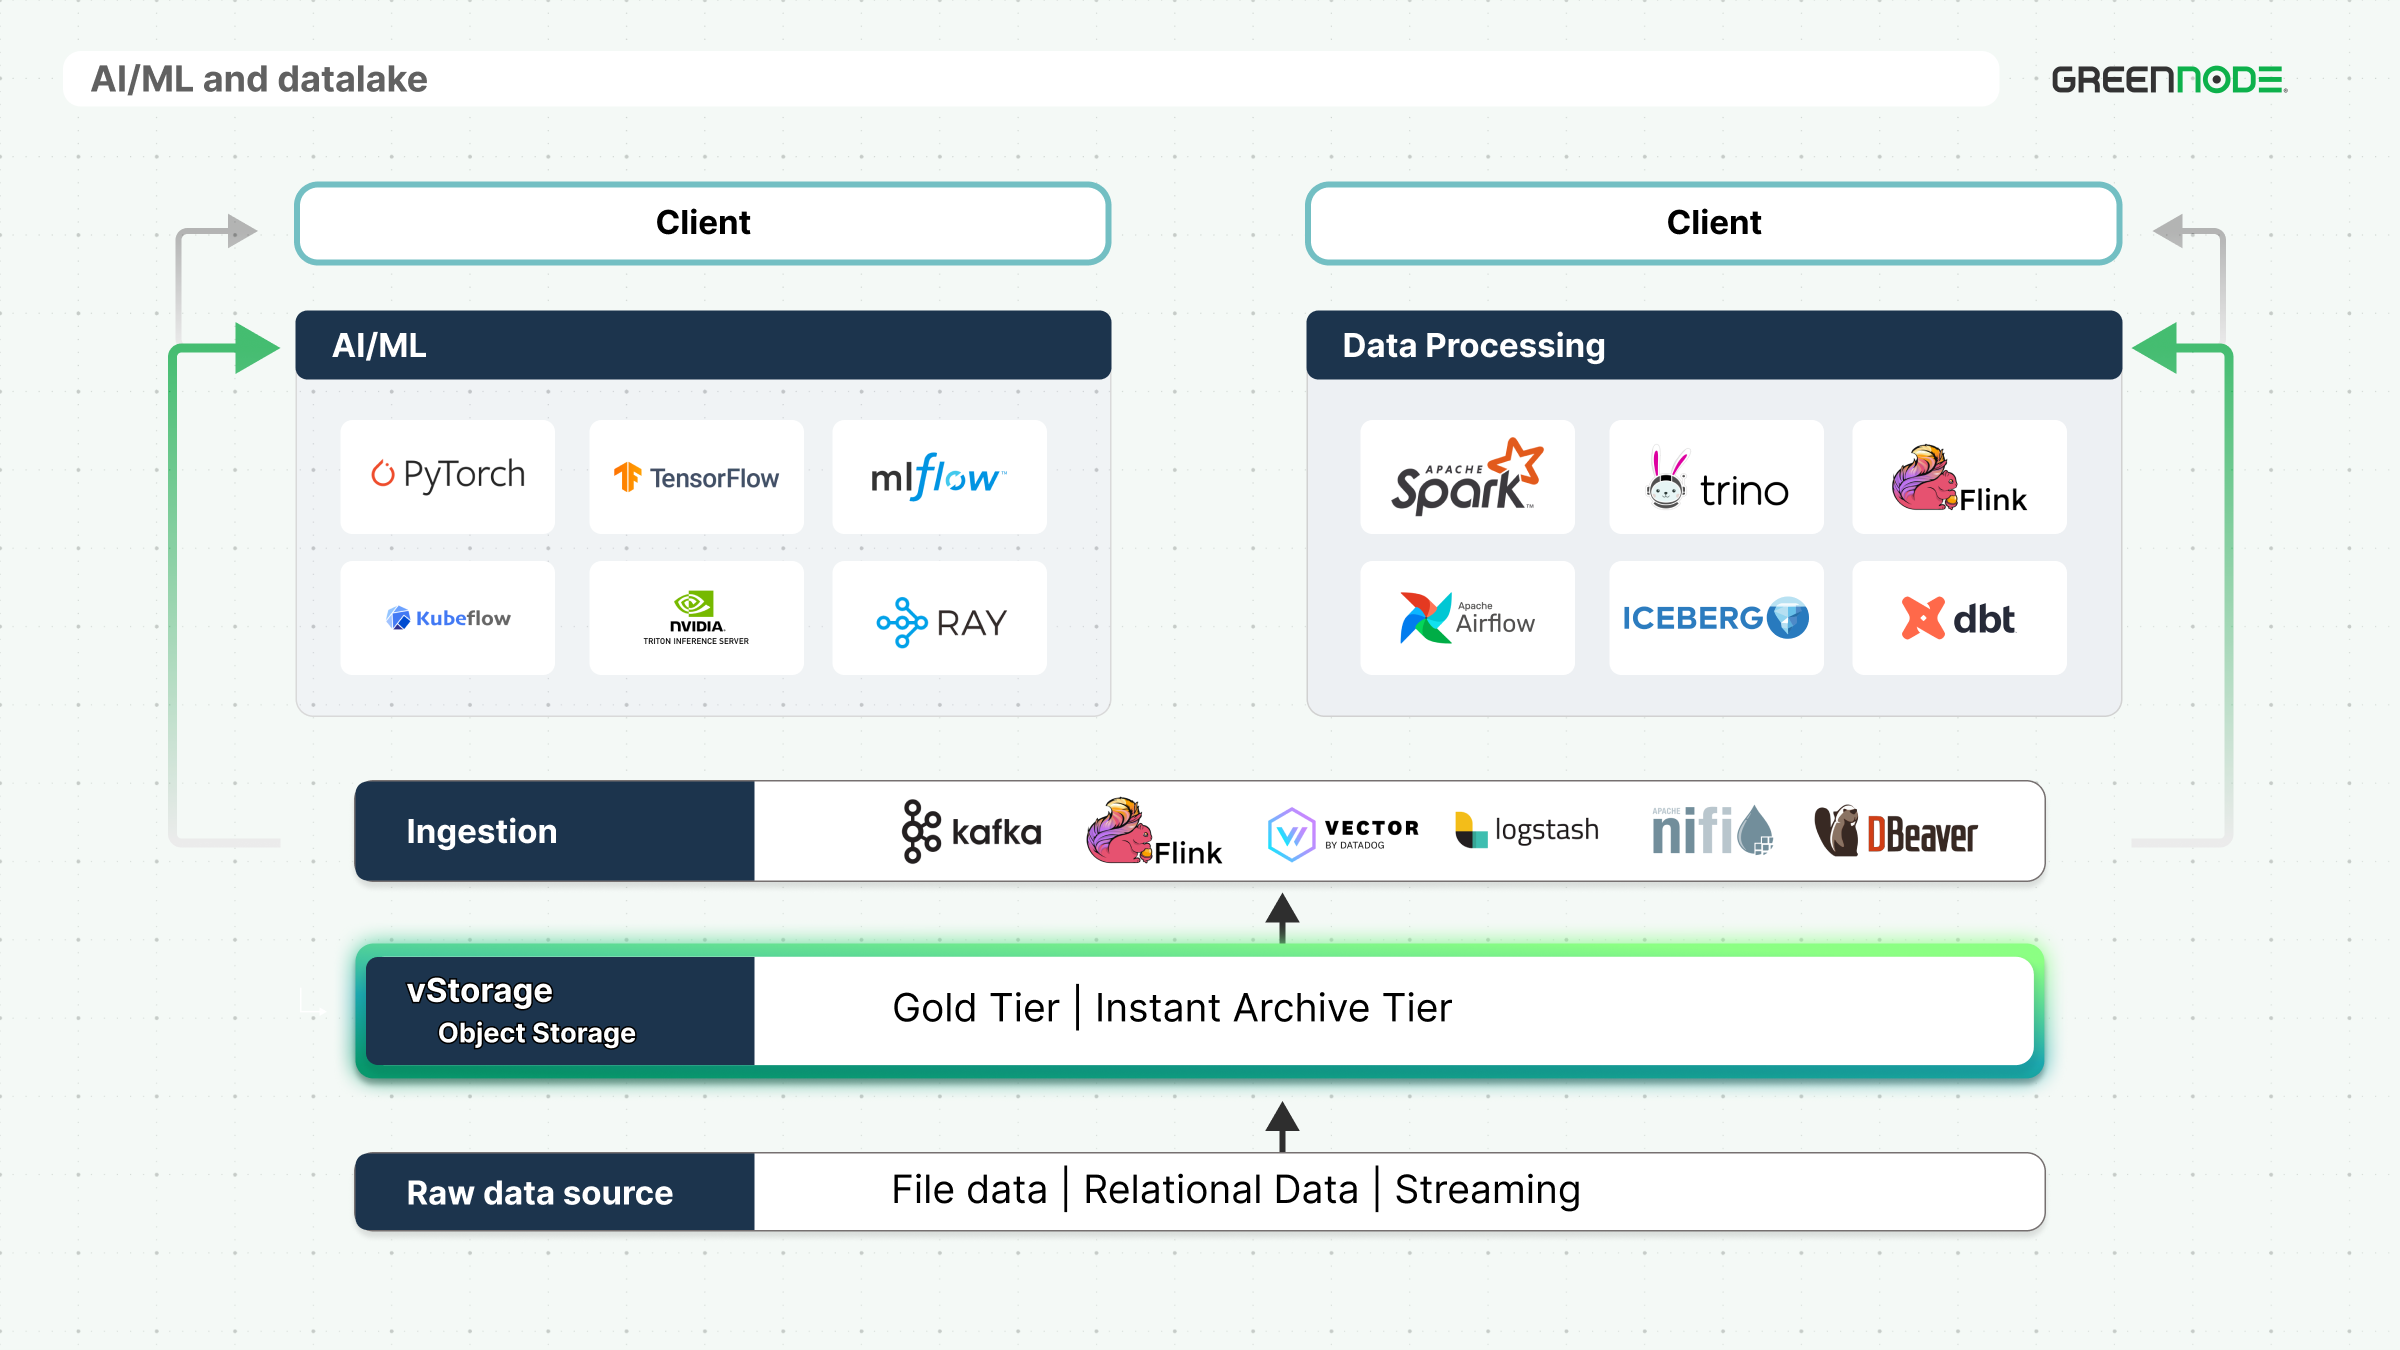
Gần như mọi framework AI/ML phổ biến đều hỗ trợ S3 API ngay từ đầu: TensorFlow, PyTorch, Apache Spark, Apache Kafka, Airflow, dbt, MLflow, Kubeflow. Điều đó có nghĩa là bất kỳ object storage nào tương thích S3 API — kể cả GreenNode Storage — đều có thể tích hợp ngay vào pipeline hiện có mà không cần viết lại code.
Đây là điểm mấu chốt: S3 API không còn là đặc quyền của AWS. Nó đã trở thành tiêu chuẩn công nghiệp mở.
2.3. Hiệu năng cao với dữ liệu phi cấu trúc quy mô lớn
Object storage hỗ trợ multipart upload và parallel I/O — cho phép upload/download nhiều phần của cùng một file đồng thời. Khi bạn cần nạp một dataset 500GB vào pipeline training, throughput của object storage có thể đạt hàng chục GB/s nếu được tối ưu đúng cách, vượt xa NAS truyền thống trong cùng workload.
2.4. Quản lý vòng đời dữ liệu tự động (Lifecycle Policy)
Một pipeline AI điển hình tạo ra nhiều loại dữ liệu với "nhiệt độ" khác nhau:
Dữ liệu nóng: raw data đang được ingest, model checkpoint của lần chạy hiện tại
Dữ liệu ấm: dataset đã được xử lý, model artifact của tháng trước
Dữ liệu lạnh: log file cũ, experiment data không còn active
Object storage cho phép thiết lập policy tự động chuyển dữ liệu giữa các tier theo thời gian — giữ hiệu năng cao cho dữ liệu nóng, đồng thời cắt giảm chi phí đáng kể cho dữ liệu lạnh.
2.5. Immutability và versioning cho reproducibility
Khoa học dữ liệu yêu cầu reproducibility — khả năng chạy lại cùng một experiment và nhận đúng kết quả cũ. Object versioning trong object storage cho phép lưu giữ mọi phiên bản của dataset và model artifact, đảm bảo audit trail đầy đủ cho cả yêu cầu kỹ thuật lẫn tuân thủ pháp lý.
3. Kiến trúc Data Lake trên Object Storage: Từ lý thuyết đến thực tế
Một data lake cho AI workload được xây trên object storage thường có cấu trúc ba tầng:
Tầng 1 — Raw Zone (Landing Zone)
Dữ liệu thô từ mọi nguồn được đổ vào đây: log từ ứng dụng, ảnh từ camera, dữ liệu giao dịch từ database, streaming data từ Kafka. Định dạng giữ nguyên, không biến đổi. Object storage phù hợp lý tưởng vì nó không quan tâm đến schema hay định dạng file.
Tầng 2 — Processed Zone
Dữ liệu được làm sạch, chuẩn hóa và chuyển về định dạng tối ưu cho analytics như Parquet hoặc ORC. Các framework như Apache Spark đọc thẳng từ object storage qua S3 API để thực hiện transformation.
Tầng 3 — Curated Zone (Feature Store)
Dữ liệu đã sẵn sàng cho training: feature vector, labeled dataset, augmented data. Pipeline ML tools như MLflow, Kubeflow đọc từ zone này để nạp vào GPU training cluster.
Toàn bộ ba tầng đều nằm trên cùng một object storage bucket, phân biệt bằng prefix và metadata tag. Không cần ba hệ thống storage riêng biệt — giảm độ phức tạp vận hành và chi phí đáng kể.
4. Bài toán chi phí: Tại sao egress fee là "bẫy ẩn" của cloud quốc tế?
Đây là điều mà nhiều doanh nghiệp Việt Nam cần lưu ý khi sử dụng cloud storage quốc tế
Khi lưu training data trên AWS S3 hoặc Google Cloud Storage tại region Singapore hay Tokyo, chi phí không chỉ là tiền lưu trữ. Mỗi lần pipeline AI đọc data từ storage về GPU cluster — nếu cluster đó đặt ở Việt Nam hoặc region khác — bạn phải trả egress fee. AWS tính khoảng $0.09/GB cho lưu lượng ra khỏi region. Với pipeline training tiêu thụ 10TB data mỗi tháng, đó là $900 tiền egress — chưa tính tiền storage.
Nhân con số đó với nhiều team, nhiều model, và scale dữ liệu tăng trưởng hàng năm — chi phí egress có thể vượt chi phí storage từ 10 đến 100 lần, như DigitalOcean đã chỉ ra trong nghiên cứu của mình.
Giải pháp: Đặt cả storage và compute trong cùng một data center, hoặc chọn nhà cung cấp có data center nội địa với chính sách egress minh bạch. Khi object storage và GPU cluster cùng nằm trong hạ tầng GreenNode tại Việt Nam, tốc độ truyền dữ liệu ngang hàng với tốc độ mạng LAN — không có latency xuyên quốc gia, không có egress fee phát sinh khi truy cập nội bộ.
5. Data Sovereignty: Yếu tố pháp lý mà pipeline AI không thể bỏ qua
Nếu pipeline AI của bạn xử lý dữ liệu khách hàng — dù là dữ liệu hành vi mua hàng, hồ sơ y tế, hay thông tin tài chính — bạn đang chịu ràng buộc của Luật An ninh mạng 2018 và Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân.
Về cơ bản, luật yêu cầu dữ liệu cá nhân của người dùng Việt Nam phải được lưu trữ trong lãnh thổ Việt Nam. Điều này ảnh hưởng trực tiếp đến lựa chọn hạ tầng: training data chứa thông tin người dùng không thể đặt tùy tiện trên AWS region Singapore hay Google Cloud Tokyo.
Object storage tại Data Center Tier III của GreenNode đặt hoàn toàn trong Việt Nam, đáp ứng 100% yêu cầu này — đồng thời cung cấp S3 API tương thích hoàn toàn để pipeline AI hiện có kết nối không cần thay đổi code.
6. Tại sao GreenNode là lựa chọn tối ưu cho Object Storage AI tại Việt Nam?
Khi đánh giá hạ tầng object storage cho Big Data và AI, doanh nghiệp cần đặt ra bốn câu hỏi:
Tốc độ: Latency từ storage đến compute cluster có đủ thấp cho pipeline AI không?
Chi phí thực: Egress fee có ẩn không? TCO thực sự là bao nhiêu?
Tuân thủ pháp lý: Dữ liệu có được lưu trong Việt Nam không?
Tích hợp: S3 API có tương thích hoàn toàn với tech stack hiện tại không?
GreenNode Storage trả lời cả bốn câu hỏi đó với hạ tầng Data Center Tier III đặt tại Việt Nam, S3 API tương thích hoàn toàn, không phát sinh egress fee nội địa khi chạy cùng hệ sinh thái GreenNode, và đảm bảo 100% tuân thủ Luật An ninh mạng.
Với hơn 1.000 doanh nghiệp đang sử dụng hệ sinh thái GreenNode, đây là nền tảng được kiểm chứng thực tế cho các workload từ startup AI đến hệ thống enterprise quy mô lớn.
Kết luận
Object storage không chỉ là nơi "để data". Với kiến trúc đúng, nó là nền tảng dữ liệu cho toàn bộ hạ tầng AI — từ data ingestion, feature engineering, model training, đến model serving và monitoring.
Doanh nghiệp Việt Nam đang bước vào giai đoạn chuyển đổi AI thực sự — không còn là pilot project mà là production workload. Ở giai đoạn đó, lựa chọn hạ tầng storage đúng từ đầu sẽ quyết định tốc độ phát triển, chi phí vận hành, và khả năng tuân thủ pháp lý lâu dài.
