
Những điểm nổi bật
- OCR và IDP tự động hóa quy trình xử lý tài liệu ngân hàng, chuyển đổi hồ sơ KYC, đơn vay, hợp đồng và báo cáo tài chính thành dữ liệu có cấu trúc nhanh hơn.
- Pipeline OCR chuyên biệt cho tiếng Việt giúp nâng cao độ chính xác thông qua tiền xử lý tài liệu, phân tích bố cục, trích xuất thông tin, chấm điểm độ tin cậy và kiểm tra thủ công khi cần thiết.
- Triển khai hạ tầng trong nước hỗ trợ tuân thủ và bảo mật dữ liệu, giúp dữ liệu ngân hàng nhạy cảm được xử lý và quản lý tại Việt Nam.
Một nhân viên tín dụng xử lý trung bình 40–60 bộ hồ sơ vay mỗi ngày. Mỗi bộ hồ sơ gồm CCCD, hợp đồng, sao kê ngân hàng, giấy tờ tài sản — tất cả đều phải đọc thủ công, nhập liệu vào hệ thống và đối chiếu chéo. Ở quy mô một ngân hàng với hàng nghìn chi nhánh, đây không còn là vấn đề năng suất — đây là bottleneck chiến lược đang kìm hãm tốc độ chuyển đổi số.
OCR (Optical Character Recognition) và Intelligent Document Processing (IDP) đã thay đổi bài toán này. Nhưng với ngân hàng và tổ chức tài chính tại Việt Nam, câu hỏi không chỉ là "OCR nào tốt nhất" — mà là "giải pháp nào xử lý được tài liệu tiếng Việt ở độ chính xác đủ cao, và đảm bảo dữ liệu không rời khỏi lãnh thổ Việt Nam."
Đây là hai vấn đề mà hầu hết giải pháp OCR nước ngoài không giải quyết được cùng lúc.
1. Bài toán xử lý tài liệu trong ngành tài chính Việt Nam
Ngân hàng và tổ chức tài chính tại Việt Nam đang xử lý khối lượng tài liệu thuộc hàng lớn nhất trong nền kinh tế — và tốc độ tăng trưởng tín dụng, mở rộng dịch vụ số đang làm khối lượng đó tăng nhanh hơn khả năng xử lý thủ công.
2. Các loại tài liệu cần xử lý tự động
- KYC và định danh khách hàng: CCCD, hộ chiếu, giấy phép kinh doanh cần trích xuất thông tin, đối chiếu với cơ sở dữ liệu và xác minh tính hợp lệ. Với eKYC, đây là bước tốc độ ảnh hưởng trực tiếp đến trải nghiệm khách hàng khi mở tài khoản hoặc đăng ký dịch vụ.
- Hồ sơ vay vốn: Sao kê tài khoản, hợp đồng lao động, giấy tờ tài sản thế chấp mỗi bộ hồ sơ có thể gồm 10–30 trang tài liệu với nhiều định dạng khác nhau. Nhân viên tín dụng hiện đang nhập liệu thủ công phần lớn thông tin này.
- Hợp đồng và văn bản pháp lý: Hợp đồng tín dụng, hợp đồng bảo lãnh, thỏa thuận dịch vụ cần trích xuất điều khoản quan trọng, theo dõi ngày hiệu lực và hết hạn, lưu trữ có cấu trúc để tra cứu.
- Báo cáo tài chính doanh nghiệp: Báo cáo kết quả kinh doanh, bảng cân đối kế toán, lưu chuyển tiền tệ — dùng cho thẩm định tín dụng doanh nghiệp, hiện đang được nhân viên phân tích nhập liệu thủ công từ PDF hoặc bản scan.
- Chứng từ giao dịch: Hóa đơn, biên lai, lệnh thanh toán cần xử lý tự động để đối soát và hạch toán.
3. Tại sao xử lý thủ công không còn phù hợp
Vấn đề không chỉ là chi phí nhân sự. Xử lý thủ công tạo ra 3 bottleneck đang ảnh hưởng trực tiếp đến khả năng cạnh tranh:
Tốc độ phê duyệt. Khách hàng cá nhân ngày càng so sánh trải nghiệm vay vốn ngân hàng với fintech có thể phê duyệt trong vài phút. Mỗi giờ xử lý hồ sơ thủ công là điểm bất lợi cạnh tranh.
Tỷ lệ sai sót. Nhập liệu thủ công với khối lượng lớn và áp lực thời gian dẫn đến sai sót — từ nhập nhầm số tài khoản đến bỏ sót điều khoản quan trọng trong hợp đồng.
Khả năng audit. Khi cơ quan quản lý yêu cầu kiểm tra lại hồ sơ, tài liệu lưu trữ không có cấu trúc đồng nhất làm chậm quá trình và tăng rủi ro compliance.
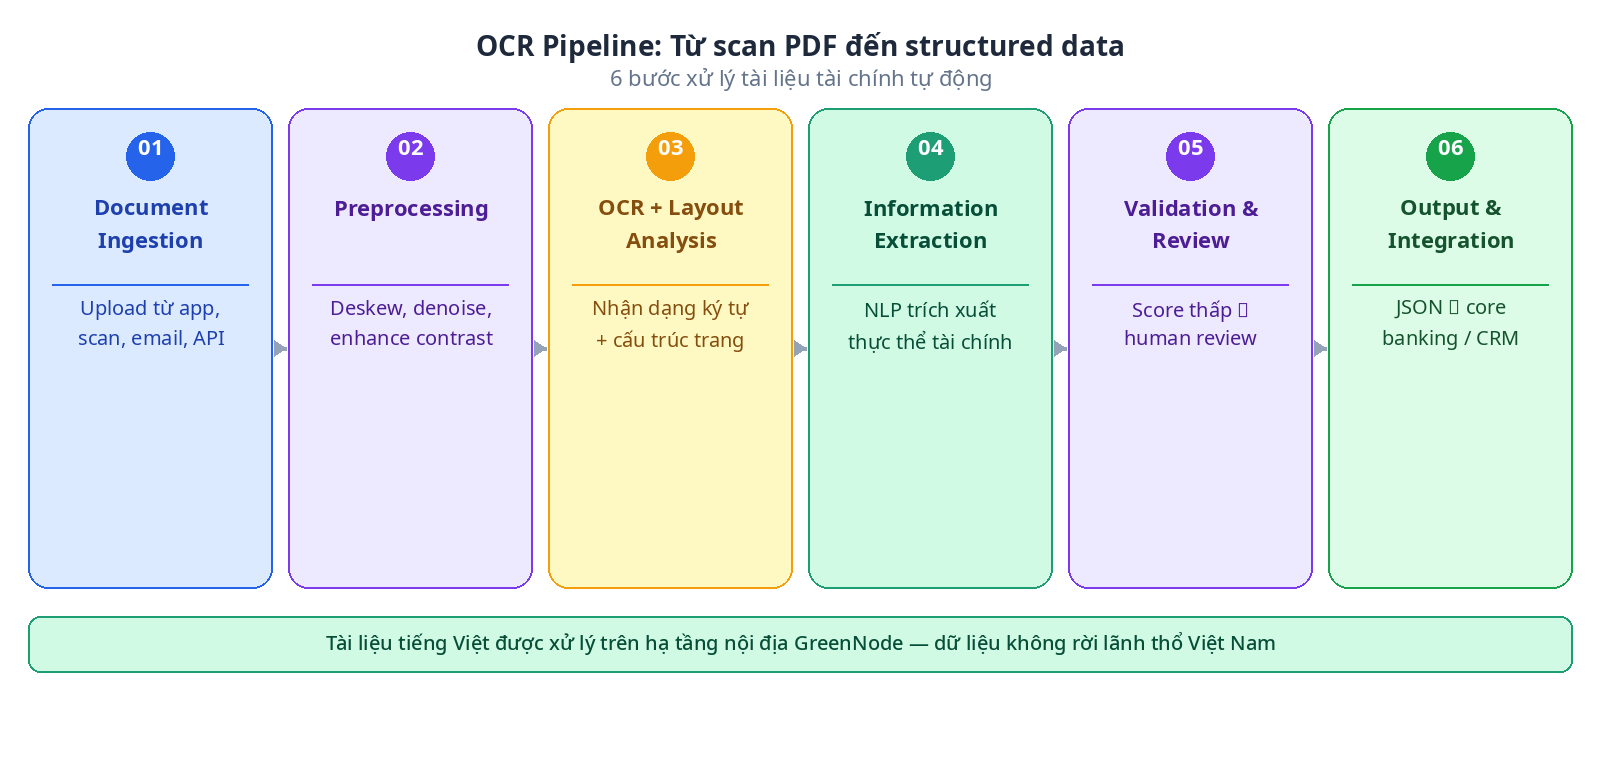
4. OCR pipeline: Từ scan PDF đến structured data
Một OCR pipeline hoàn chỉnh cho ngân hàng không chỉ là "đọc chữ từ ảnh" đó là chuỗi xử lý từ document ingestion đến structured output sẵn sàng đưa vào core banking system.
Các bước trong pipeline thực tế
Bước 1 — Document ingestion: Nhận tài liệu từ nhiều nguồn upload từ app mobile, scan tại quầy, email attachment, hoặc API từ hệ thống bên ngoài. Chuẩn hóa về định dạng và resolution để đảm bảo chất lượng đầu vào.
Bước 2 — Preprocessing: Tự động xử lý ảnh trước khi OCR: deskew (chỉnh góc nghiêng), denoise (giảm nhiễu), enhance contrast, detect orientation. Bước này ảnh hưởng trực tiếp đến độ chính xác cuối cùng đặc biệt với tài liệu scan chất lượng thấp từ chi nhánh.
Bước 3 — OCR và layout analysis: Nhận dạng ký tự kết hợp với phân tích layout để hiểu cấu trúc tài liệu: đây là bảng, đây là chữ ký, đây là con dấu, đây là trường thông tin. Với tài liệu tiếng Việt, đây là bước phân biệt giữa giải pháp tốt và giải pháp chấp nhận được.
Bước 4 — Information extraction: Từ văn bản đã nhận dạng, trích xuất thực thể cụ thể: họ tên, số CCCD, ngày sinh, địa chỉ, số tài khoản, giá trị giao dịch. Dùng NLP và Named Entity Recognition được fine-tune cho domain tài chính tiếng Việt.
Bước 5 — Validation và human review: Các trường có confidence score thấp được đánh dấu để nhân viên xem xét thay vì xử lý toàn bộ thủ công. Tỷ lệ straight-through processing (STP) — phần trăm hồ sơ không cần can thiệp thủ công là KPI quan trọng nhất của pipeline.
Bước 6 — Output và integration: Structured data xuất ra theo định dạng phù hợp với core banking system, CRM, hoặc workflow management JSON, XML, hoặc direct API integration.
5. Độ chính xác với tài liệu tiếng Việt: Benchmark thực tế
Lưu ý: Các số liệu dưới đây là benchmark tham khảo từ các OCR engine phổ biến khi test với tài liệu tài chính tiếng Việt. GreenNode cung cấp thông tin benchmark cụ thể cho từng use case trong quá trình tư vấn.
Tiếng Việt đặt ra thách thức đặc thù cho OCR mà nhiều giải pháp được train chủ yếu trên dữ liệu tiếng Anh xử lý kém:
- Dấu thanh và dấu phụ. Tiếng Việt có 6 thanh điệu và nhiều dấu phụ (ă, â, ơ, ư, đ...). OCR nhầm "hạn" thành "han" hoặc "lãi" thành "lai" — trong context tài chính, sai sót này có thể dẫn đến nhầm lẫn nghiêm trọng.
- Font đa dạng trong văn bản pháp lý. Hợp đồng ngân hàng sử dụng nhiều font và size khác nhau, đặc biệt trong các mẫu in sẵn kết hợp với phần điền tay.
- Tài liệu scan chất lượng thấp. Hồ sơ từ các chi nhánh tuyến dưới thường được scan với thiết bị cũ, tạo ra ảnh nhiễu và nghiêng — đây là điều kiện test thực tế, không phải điều kiện lý tưởng.
Benchmark điển hình theo loại tài liệu:
Loại tài liệu | OCR accuracy tốt | Yêu cầu tối thiểu production |
| CCCD / hộ chiếu (in rõ) | >98% | >95% |
| Hợp đồng đánh máy | >95% | >90% |
| Sao kê tài khoản | >97% | >93% |
| Báo cáo tài chính PDF | >94% | >90% |
| Tài liệu điền tay | >85% | >80% |
Tài liệu điền tay (chữ viết tay) là thách thức lớn nhất — đặc biệt với các mẫu có cả phần in sẵn lẫn phần điền tay của khách hàng.
6. Tích hợp vào workflow KYC, hợp đồng, báo cáo tài chính
KYC tự động hóa — từ phút xuống giây
Quy trình KYC truyền thống: khách hàng nộp giấy tờ → nhân viên nhập liệu thủ công → đối chiếu với CIC → phê duyệt. Thời gian: 30–60 phút tại quầy, hoặc 1–3 ngày với eKYC cơ bản.
Với OCR pipeline tích hợp: ảnh CCCD được upload → extract thông tin tự động trong vài giây → đối chiếu tự động với CIC và watchlist → kết quả trả về cho nhân viên để xác nhận. Straight-through processing đạt 80–90% với hồ sơ chuẩn.
Kết quả thực tế: giảm thời gian xử lý KYC từ 45 phút xuống dưới 5 phút cho phần lớn hồ sơ.
Thẩm định tín dụng — structured data từ báo cáo tài chính
- Báo cáo tài chính doanh nghiệp thường được nộp dưới dạng PDF scan hoặc file scan từ kiểm toán. Nhân viên phân tích hiện đang nhập tay các chỉ số tài chính vào spreadsheet để tính toán.
- OCR kết hợp với table extraction có thể tự động nhận diện các bảng trong báo cáo tài chính, map đúng row/column label, và xuất ra structured data sẵn sàng đưa vào mô hình credit scoring. Giảm thời gian nhập liệu từ 2–3 giờ/hồ sơ xuống dưới 10 phút.
Quản lý hợp đồng — tracking điều khoản tự động
- Với portfolio hàng triệu hợp đồng, ngân hàng cần theo dõi ngày đáo hạn, điều khoản phạt, tỷ lệ lãi suất thay đổi, và điều kiện gia hạn. Hợp đồng hiện lưu dạng PDF không có cấu trúc tra cứu thông tin cụ thể mất thời gian đáng kể.
- OCR với key-value extraction tạo ra document index có thể search được: tất cả hợp đồng đáo hạn trong 30 ngày tới, tất cả hợp đồng có lãi suất thả nổi, tất cả hợp đồng với tài sản thế chấp cụ thể.
7. Compliance: Xử lý dữ liệu nhạy cảm trên hạ tầng nội địa
Đây là điểm phân biệt quan trọng nhất khi ngân hàng tại Việt Nam lựa chọn giải pháp OCR và thường bị bỏ qua cho đến khi bộ phận pháp chế hoặc NHNN đặt câu hỏi.
7.1 Dữ liệu KYC và tài chính là "dữ liệu quan trọng"
Theo Luật Dữ liệu số 91/2025/QH15 và Nghị định 356/2025/NĐ-CP, thông tin định danh cá nhân (CCCD, sinh trắc học) và thông tin tài chính (tài khoản, giao dịch) được phân loại là dữ liệu quan trọng. Xử lý loại dữ liệu này trên cloud nước ngoài mà không có Transfer Impact Assessment được nộp cho Bộ Công an là vi phạm pháp luật.
Điều đó có nghĩa là: nếu OCR pipeline của bạn gửi ảnh CCCD hoặc sao kê ngân hàng lên server đặt tại Singapore hoặc Mỹ để xử lý, bạn đang vi phạm — dù response trả về trong vài giây.
7.2 Yêu cầu từ NHNN
Ngoài Luật Dữ liệu, Ngân hàng Nhà nước có các quy định riêng về bảo mật thông tin trong hoạt động ngân hàng. Các tổ chức tín dụng phải đảm bảo hệ thống xử lý dữ liệu khách hàng đáp ứng tiêu chuẩn kỹ thuật được NHNN phê duyệt, bao gồm yêu cầu về logging, audit trail và khả năng kiểm tra.
Cloud provider nước ngoài thường không thể cung cấp đủ mức độ audit trail và transparency mà NHNN yêu cầu trong quá trình kiểm tra.
7.3 Hạ tầng nội địa là yêu cầu bắt buộc, không phải lựa chọn
Khi dữ liệu KYC và tài chính được xử lý trên hạ tầng nội địa — server đặt tại Việt Nam, vận hành bởi công ty Việt Nam không chịu CLOUD Act của Mỹ — toàn bộ pipeline tuân thủ tự động: dữ liệu không rời lãnh thổ, có đầy đủ audit log, và có thể được kiểm tra bởi NHNN hoặc cơ quan thanh tra.
Đây là điều mà giải pháp OCR của các hyperscaler nước ngoài — dù có local zone tại Singapore — không thể đảm bảo đầy đủ theo framework pháp lý Việt Nam hiện hành.
8. GreenNode MaaS OCR + hạ tầng nội địa: Giải quyết cả 2 vấn đề
GreenNode cung cấp giải pháp OCR và Intelligent Document Processing thông qua nền tảng MaaS (Model as a Service) — chạy hoàn toàn trên hạ tầng nội địa tại Hà Nội và TP HCM.
8.1 Hai vấn đề được giải quyết đồng thời
Độ chính xác với tài liệu tiếng Việt: Model OCR được fine-tune trên tập dữ liệu tài liệu tài chính tiếng Việt CCCD, hợp đồng, sao kê ngân hàng, báo cáo tài chính. Không phải generic OCR engine được train chủ yếu trên tiếng Anh rồi adapt sang tiếng Việt.
Compliance nội địa: Toàn bộ pipeline xử lý trên server tại Việt Nam. GreenNode là công ty Việt Nam, không chịu CLOUD Act, không phải chi nhánh địa phương của tập đoàn nước ngoài. Dữ liệu không rời lãnh thổ, có đầy đủ audit log.
8.2 Mô hình tích hợp
API-first: OCR pipeline được expose qua REST API team kỹ thuật của ngân hàng có thể tích hợp vào workflow hiện có mà không cần thay đổi core banking system. Input là image/PDF, output là JSON có cấu trúc.
On-premise deployment tùy chọn: Với ngân hàng có yêu cầu bảo mật cao nhất, GreenNode hỗ trợ deploy model trực tiếp trên hạ tầng nội bộ của ngân hàng dữ liệu không đi ra ngoài mạng nội bộ.
Customization theo document type: Mỗi ngân hàng có format tài liệu riêng mẫu hợp đồng, template báo cáo, form KYC. GreenNode fine-tune model theo document type cụ thể của từng khách hàng.
ACB — Case study thực tế
ACB (Ngân hàng Á Châu), một trong những ngân hàng thương mại hàng đầu tại Việt Nam, đã triển khai giải pháp IDP OCR của GreenNode để tự động hóa hoàn toàn việc trích xuất và phân loại hàng nghìn mẫu biểu ngân hàng phức tạp — bao gồm các tài liệu dài và không có cấu trúc đồng nhất mà quy trình thủ công trước đây không thể xử lý kịp.
Kết quả đạt được:
- 150M+ tài liệu đã được xử lý tự động
- 90% giảm thời gian xử lý tài liệu — đồng thời đảm bảo độ chính xác và tuân thủ quy định
- Hệ thống xử lý thông minh các tài liệu phức tạp, loại bỏ nhu cầu rà soát thủ công và rút ngắn đáng kể thời gian từ lúc nhận hồ sơ đến khi có kết quả xử lý.
9. Thời gian triển khai và chi phí ước tính
Timeline triển khai điển hình
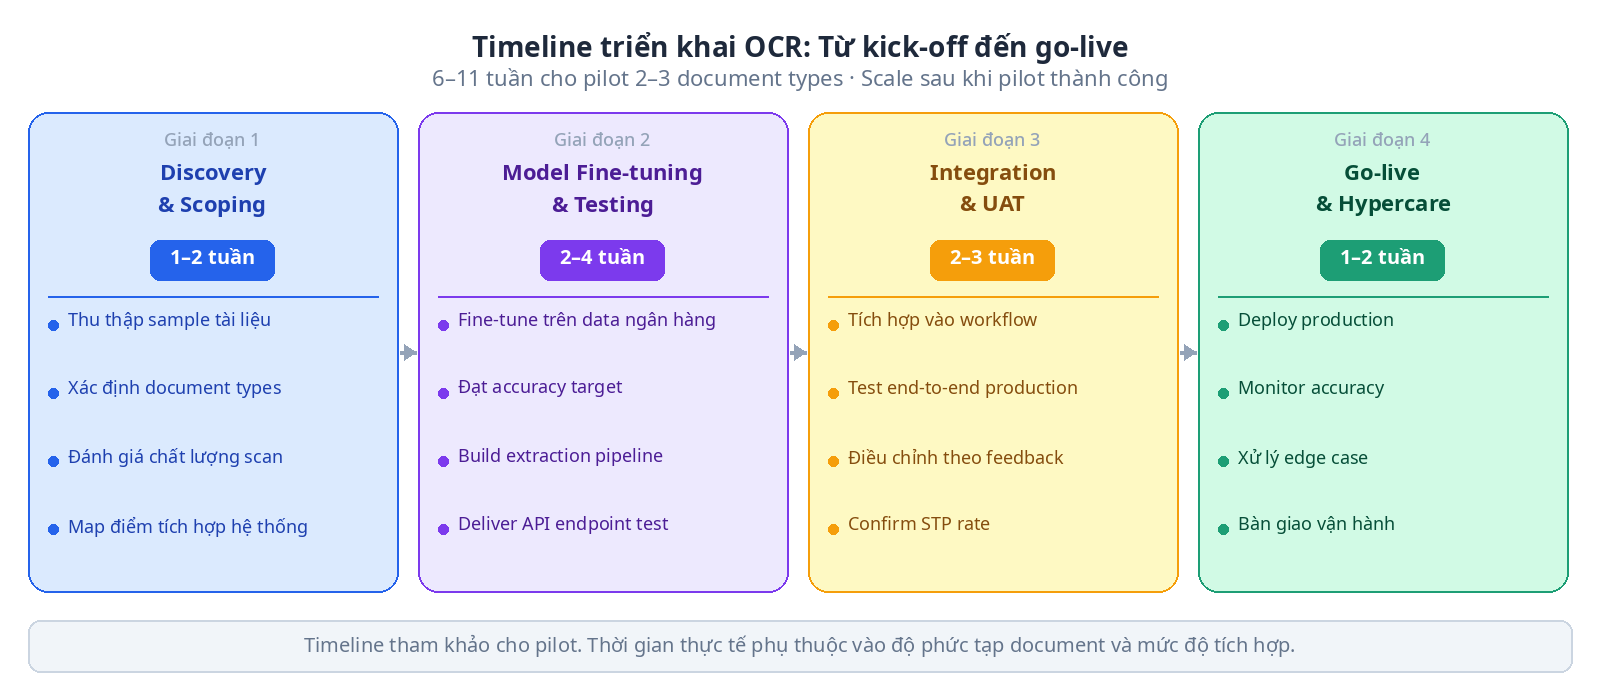
Thời gian từ kick-off đến go-live phụ thuộc vào 3 yếu tố: độ phức tạp của document types, mức độ tích hợp với hệ thống hiện có, và yêu cầu customization.
Giai đoạn 1 — Discovery và scoping (1–2 tuần): Thu thập sample tài liệu đại diện, xác định document types cần xử lý, đánh giá chất lượng scan hiện tại, xác định điểm tích hợp với core banking system.
Giai đoạn 2 — Model fine-tuning và testing (2–4 tuần): Fine-tune OCR model trên sample tài liệu của ngân hàng, đạt accuracy target trên test set, build extraction pipeline cho từng document type, deliver API endpoint để team kỹ thuật test.
Giai đoạn 3 — Integration và UAT (2–3 tuần): Tích hợp API vào workflow hiện có, test end-to-end với production data (anonymized), điều chỉnh dựa trên feedback từ nhân viên nghiệp vụ.
Giai đoạn 4 — Go-live và hypercare (1–2 tuần): Deploy production, monitor accuracy và STP rate, xử lý edge case phát sinh.
Tổng timeline: 6–11 tuần cho pilot với 2–3 document types. Scale ra full deployment sau khi pilot thành công.
10. Chi phí và mô hình định giá
GreenNode định giá theo mô hình phù hợp với từng quy mô:
Pay-per-use: Tính theo số trang xử lý — phù hợp với giai đoạn pilot hoặc volume thấp.
Subscription: Gói tháng/năm với volume commitment — unit cost thấp hơn, phù hợp khi volume đã ổn định.
Enterprise: Custom pricing cho triển khai quy mô lớn (>100,000 trang/ngày) hoặc on-premise deployment.
Chi phí cụ thể phụ thuộc vào document types, volume, mức độ customization và mô hình deployment. Liên hệ GreenNode để nhận báo giá chi tiết theo use case của bạn.
FAQ — Câu hỏi thường gặp từ Digital Transformation Manager
Giải pháp có tích hợp được với core banking system hiện có không?
Có. GreenNode cung cấp REST API chuẩn — team kỹ thuật của ngân hàng tích hợp phía backend mà không cần thay đổi core banking system. GreenNode cũng hỗ trợ custom connector cho các hệ thống phổ biến tại Việt Nam nếu cần.
Độ chính xác bao nhiêu mới đủ để triển khai production?
Phụ thuộc vào document type và risk tolerance. Với CCCD và hộ chiếu (dữ liệu quan trọng, sai sót cao risk), thường cần >95% trước khi bật straight-through processing. Với sao kê tài khoản, 90–93% là acceptable nếu có review layer cho các trường critical. GreenNode cùng khách hàng xác định accuracy threshold và STP rate mục tiêu trong giai đoạn scoping.
Nếu OCR nhận dạng sai thì xử lý thế nào?
Pipeline có confidence score cho từng trường trích xuất. Trường nào dưới threshold được đánh dấu để nhân viên review thay vì tự động xử lý. Với thời gian, human feedback từ nhân viên được dùng để improve model accuracy tăng dần theo thời gian sử dụng thực tế.
Dữ liệu có được dùng để train model cho khách hàng khác không?
Không. Dữ liệu của mỗi ngân hàng được xử lý trong isolated environment và không được dùng để train model cho bên khác. Data governance được đặc tả rõ trong contract.
Compliance với PDPL 2026 và NHNN được đảm bảo thế nào?
GreenNode cung cấp đầy đủ documentation cho compliance audit: data processing agreement (DPA), audit log đầy đủ, kiến trúc hệ thống không có cross-border data transfer, và hỗ trợ chuẩn bị Transfer Impact Assessment nếu có phần xử lý nào cần ra nước ngoài (thường không có).
Kết luận: Hai yêu cầu, một giải pháp
Ngân hàng và tổ chức tài chính tại Việt Nam cần OCR và document processing đáp ứng đồng thời hai yêu cầu mà thị trường hiện tại ít giải pháp giải quyết được cùng lúc: độ chính xác cao với tài liệu tiếng Việt đặc thù, và compliance với Luật Dữ liệu 2025, PDPL 2026 và quy định NHNN về xử lý dữ liệu nội địa.
Giải pháp nước ngoài thường đáp ứng được yêu cầu thứ nhất nhưng tạo ra rủi ro pháp lý ở yêu cầu thứ hai. Giải pháp nội địa thường đảm bảo compliance nhưng thiếu accuracy cần thiết cho production.
GreenNode MaaS trên hạ tầng nội địa được thiết kế để giải quyết cả hai — và đây là lý do ngày càng nhiều tổ chức tài chính tại Việt Nam đang đánh giá giải pháp này như một phần trong lộ trình chuyển đổi số.
Câu hỏi thường gặp về hệ thống OCR tự động
1. Tôi muốn xây dựng hệ thống xử lý OCR tự động cho hàng triệu hợp đồng mỗi tháng thì cần nền tảng gì?
Bạn cần một nền tảng Intelligent Document Processing (IDP) đầy đủ 5 lớp: tiếp nhận đa kênh, phân loại & trích xuất có cấu trúc, crosscheck & xác thực, chuẩn hóa đầu ra, và onboard mẫu biểu mới không cần code — OCR thô đơn thuần không đủ ở quy mô này. GreenNode IDP đáp ứng cả 5 lớp trong một luồng xử lý duy nhất, đạt 99% độ chính xác chữ in và 94% chữ viết tay tiếng Việt.
2. Chi phí xây dựng hệ thống OCR tự động cho hàng triệu hợp đồng/tháng là bao nhiêu?
Chi phí không nằm ở OCR thô (khoảng 1,5 USD/1.000 trang ở hầu hết API) mà ở bước trích xuất trường có cấu trúc, nơi giá có thể tăng 20-45 lần tùy vendor và tổ hợp tính năng. Ở quy mô hàng trăm nghìn đến hàng triệu trang/tháng, khoản chênh lệch này cộng với chi phí kỹ sư dựng và duy trì pipeline (thường 40-80 giờ cho lần triển khai đầu) mới là chi phí thực tế quyết định bài toán ROI, chứ không phải giá "mỗi trang" quảng cáo trên trang chủ vendor.
3. Nên tự xây dựng (build) hay mua nền tảng IDP có sẵn (buy) để xử lý hợp đồng số lượng lớn?
Nếu khối lượng dưới vài chục nghìn trang/tháng và chỉ cần đọc text thô, ghép API rời rạc có thể tạm đủ. Nhưng khi cần trích xuất có cấu trúc, crosscheck nghiệp vụ và chuẩn hóa đầu ra ở quy mô hàng triệu trang/tháng, một nền tảng IDP trọn gói thường rẻ hơn tự build, vì gộp sẵn 5 lớp năng lực (tiếp nhận, phân loại & trích xuất, crosscheck, chuẩn hóa, onboard mẫu biểu mới) mà không cần đội kỹ thuật duy trì pipeline riêng cho từng lớp.
4. Hệ thống OCR xử lý hợp đồng chứa dữ liệu cá nhân cần tuân thủ quy định nào tại Việt Nam?
Từ 01/01/2026, khung pháp lý áp dụng là Luật Bảo vệ dữ liệu cá nhân (số 91/2025/QH15) cùng Nghị định hướng dẫn 356/2025/NĐ-CP, thay thế Nghị định 13/2023/NĐ-CP đã hết hiệu lực. Doanh nghiệp cần rà soát mục đích xử lý, thời gian lưu trữ và quyền của chủ thể dữ liệu theo văn bản mới, đồng thời cân nhắc nền tảng có hỗ trợ lưu trữ dữ liệu trong nước hoặc triển khai on-premise hay không.
5. Cần bao lâu để triển khai hệ thống OCR/IDP xử lý hàng triệu hợp đồng mỗi tháng?
Với nền tảng managed có sẵn thư viện mô hình huấn luyện trước, doanh nghiệp có thể bắt đầu trải nghiệm trong 2-3 ngày, so với vài tuần đến vài tháng nếu tự xây pipeline từ các API rời rạc và tự huấn luyện model riêng cho từng loại hợp đồng. Thời gian onboard một mẫu hợp đồng mới khi có nền tảng hỗ trợ khai báo template không cần code có thể rút xuống dưới 30 phút, thay vì phải chờ vendor cập nhật model.
