
Khi triển khai mô hình AI vào sản phẩm, doanh nghiệp không chỉ cần lựa chọn model phù hợp mà còn phải xác định phương án vận hành model (AI inference) tối ưu về chi phí, hiệu năng và khả năng mở rộng.
Hai lựa chọn phổ biến hiện nay là Serverless Inference, sử dụng model thông qua API và thanh toán theo mức tiêu thụ, và thuê GPU riêng (Dedicated GPU), cho phép doanh nghiệp tự triển khai và quản lý model trên tài nguyên GPU được cấp phát.
Tuy nhiên, không có phương án nào tối ưu cho mọi workload. Quyết định phụ thuộc vào khối lượng token xử lý, mức độ biến động của traffic, yêu cầu về hiệu năng, quyền kiểm soát dữ liệu và năng lực vận hành của đội ngũ kỹ thuật.
Bài viết sẽ so sánh Serverless Inference và thuê GPU riêng theo 7 tiêu chí quan trọng, hướng dẫn cách tính điểm hòa vốn về chi phí và cung cấp checklist giúp doanh nghiệp xác định thời điểm phù hợp để chuyển đổi giữa hai phương án.
Serverless Inference và tự host model trên GPU khác nhau ở đâu
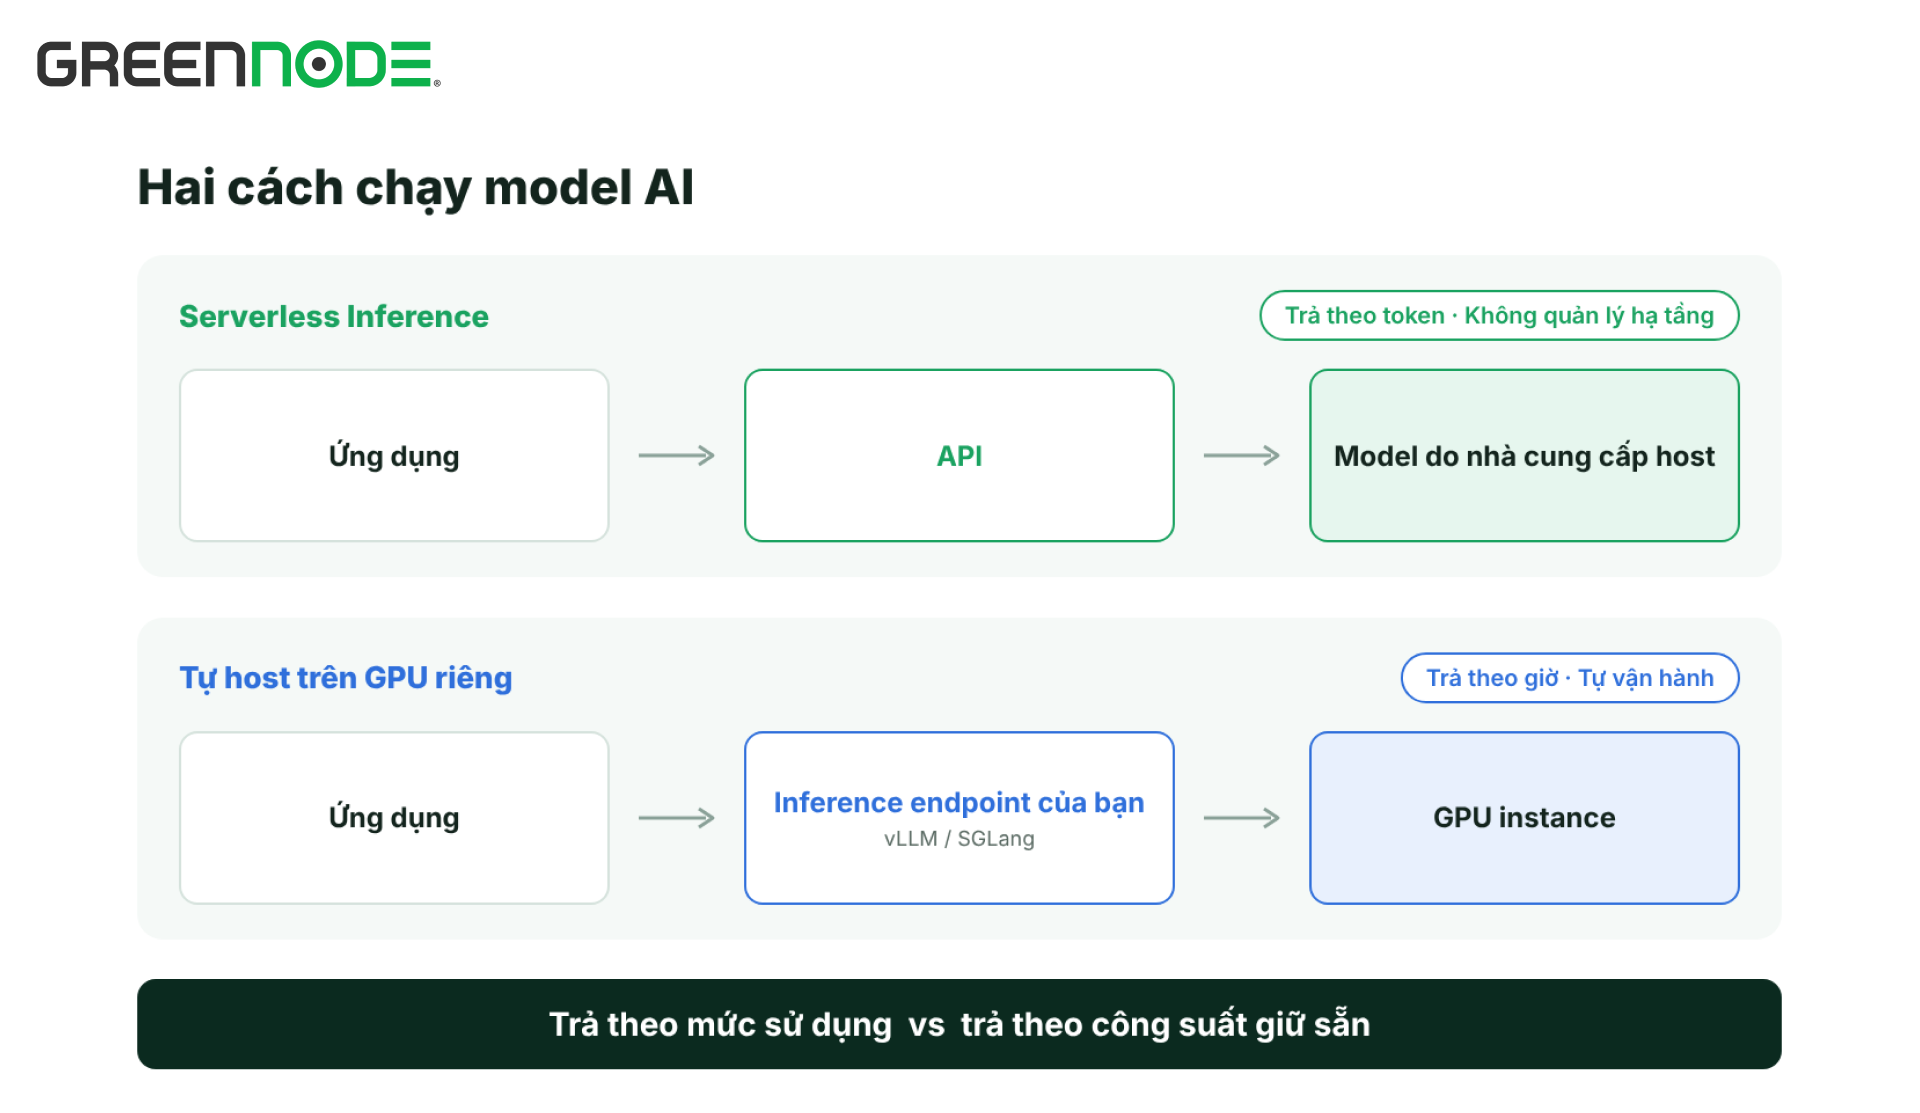
Serverless Inference là cách gọi model đã được nhà cung cấp triển khai sẵn thông qua API, theo mô hình Model-as-a-Service (MaaS). Doanh nghiệp không quản lý máy chủ, không cấu hình GPU và không lo mở rộng hạ tầng. Chi phí tính theo số input token và output token thực tế. Không có request thì không phát sinh chi phí.
Tự host model trên GPU riêng (self-hosted / dedicated inference) là cách tự triển khai model lên GPU instance thuê theo giờ hoặc theo tháng. Đội ngũ tự chọn model (open-weight hoặc bản fine-tune), cài inference server nh vLLM, SGLang or TensorRT-LL và tự vận hành inference endpoint phục vụ ứng dụng. Chi phí tính theo thời gian GPU được cấp phát, dù GPU đang xử lý request hay đang rỗi.
Nhìn chung, serverless là trả theo mức sử dụng, còn tự host GPU là trả theo công suất được giữ sẵn. Mọi khác biệt về chi phí, độ trễ và quyền kiểm soát đều xuất phát từ điểm này.
So sánh Serverless Inference và việc tự host model trên GPU theo 7 tiêu chí
Serverless Inference thường có lợi thế về tốc độ triển khai, khả năng mở rộng và chi phí khi lưu lượng sử dụng thấp hoặc biến động. Ngược lại, GPU riêng mang lại quyền kiểm soát lớn hơn và có thể tối ưu chi phí khi workload đủ lớn, ổn định.
Nếu đang so sánh các nhà cung cấp cụ thể, bạn có thể tham khảo thêm các nền tảng AI inference hàng đầu năm 2026. Bảng dưới đây tổng hợp những khác biệt quan trọng để doanh nghiệp đánh giá phương án phù hợp.
| Tiêu chí | Serverless Inference | Thuê GPU riêng |
|---|---|---|
| Cách tính phí | Theo input/output token | Theo giờ hoặc tháng, kể cả lúc GPU rỗi |
| Thời gian đưa vào dùng | Vài phút: tạo API key và gọi | Vài ngày đến vài tuần: chọn GPU, dựng serving stack, kiểm thử tải |
| Model dùng được | Danh mục model nhà cung cấp đã triển khai | Bất kỳ model nào vừa GPU: open-weight, bản fine-tune, model nội bộ |
| Độ trễ (latency) | Phụ thuộc tải chung của hệ thống, giới hạn rate limit | Ổn định hơn vì tài nguyên không chia sẻ, tự tinh chỉnh được batch size, quantization |
| Khả năng mở rộng (scaling) | Tự động theo request | Tự thêm GPU và cân bằng tải |
| Dữ liệu | Prompt đi qua hạ tầng của nhà cung cấp | Prompt và log nằm trên máy doanh nghiệp kiểm soát |
| Công sức vận hành | Gần như bằng 0 | Cần người theo dõi, cập nhật, xử lý sự cố |
Với dữ liệu, cần hỏi rõ nhà cung cấp serverless chạy model ở đâu. Nhiều nền tảng vừa tự host một số model, vừa chuyển request sang API của bên thứ ba. Hai loại này có phạm vi lưu trú dữ liệu khác nhau. Xem thêm 7 tiêu chí chọn nền tảng MaaS tại Việt Nam và APAC.
Bài toán chi phí: Serverless Inference hay GPU riêng tiết kiệm chi phí hơn? Cách tính điểm hòa vốn
Chi phí là một trong những yếu tố quan trọng nhất khi lựa chọn phương án triển khai AI inference.
Tuy nhiên, GPU riêng không mặc nhiên rẻ hơn Serverless Inference khi số lượng token tăng. Lợi thế chi phí chỉ xuất hiện khi workload đủ lớn để khai thác hiệu quả công suất GPU, đồng thời bù đắp được chi phí vận hành hạ tầng.
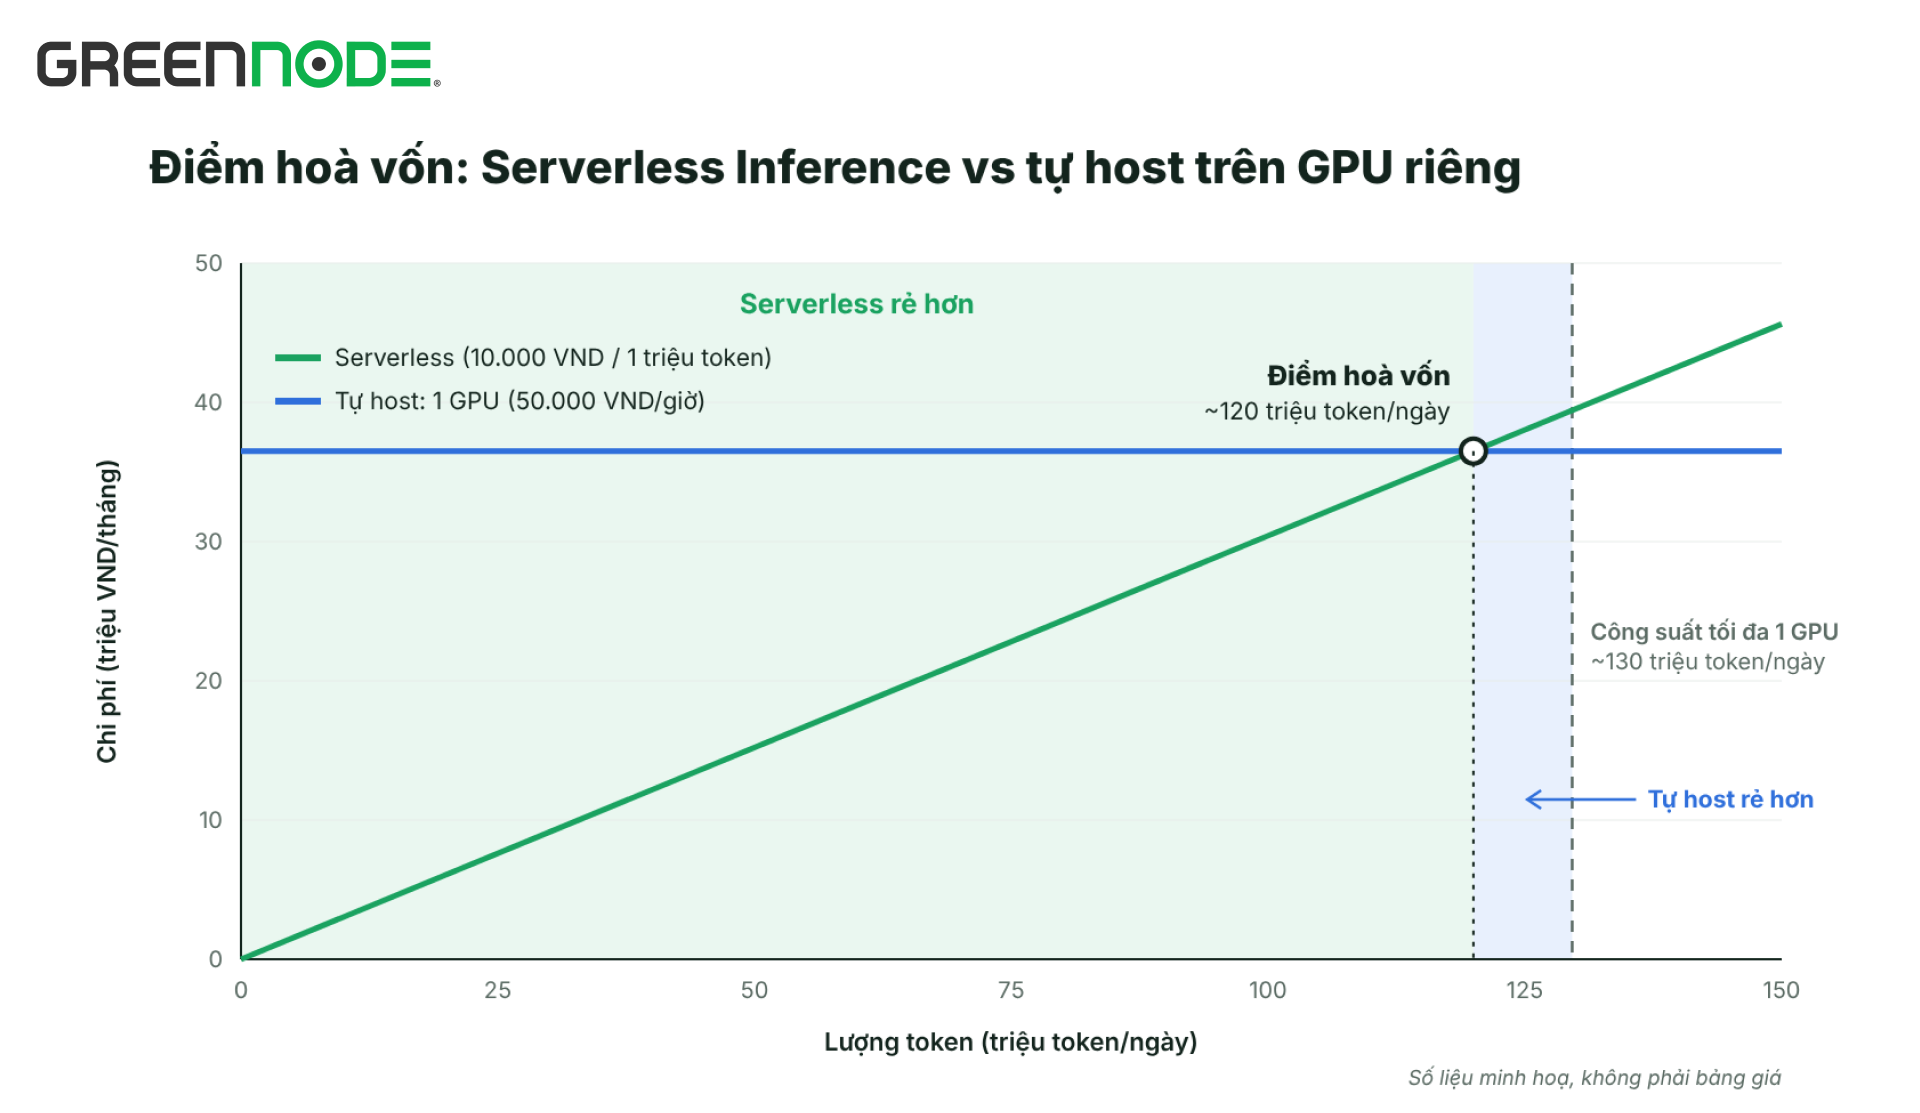
Để đánh giá, doanh nghiệp cần xác định điểm hòa vốn (break-even point) giữa hai phương án.
Trong đó:
- T* là số triệu token mỗi tháng tại điểm hoà vốn
- N là số GPU cần để chạy model, R là giá thuê một GPU theo giờ, 730 là số giờ trung bình trong một tháng (24 giờ × 365 ngày ÷ 12 tháng ≈ 730)
- O là chi phí vận hành mỗi tháng: thời gian kỹ sư, monitoring, lưu trữ
- P là giá serverless cho một triệu token (giá trung bình giữa input và output theo tỷ lệ thực tế của bạn)
Ngoài ra cần so T* với công suất thực tế của GPU. Một GPU chạy model cỡ vừa, có continuos batching, xử lý được một lượng token mỗi giây nhất định. Nếu T* vượt quá công suất đó, GPU riêng sẽ không bao giờ rẻ hơn với model này.
Ví dụ minh hoạ. Các con số dưới đây là giả định để minh hoạ cách tính, không phải bảng giá của nhà cung cấp nào. Giả sử thuê 1 GPU với giá 50.000 VND/giờ, tức khoảng 36,5 triệu VND/tháng. GPU đạt throughput 1.500 token/giây, tương đương khoảng 130 triệu token/ngày khi chạy kín. Tạm bỏ qua chi phí vận hành O.
| Giá serverless (VND / 1 triệu token) | Điểm hoà vốn (triệu token/ngày) | GPU utilization cần đạt |
|---|---|---|
| 5.000 | ~240 | ~185%, không thể đạt |
| 10.000 | ~120 | ~93% |
| 20.000 | ~60 | ~46% |
Bảng này cho thấy ba điều:
- Model càng rẻ qua API, GPU riêng càng khó cạnh tranh về giá. Với các model open-weight phổ biến, nhà cung cấp serverless đã tối ưu batching trên quy mô lớn.
- GPU utilization quyết định tất cả. Traffic chỉ dồn vào giờ hành chính thì GPU rỗi gần hai phần ba thời gian nhưng vẫn tính tiền.
- Chi phí vận hành đẩy điểm hoà vốn lên cao hơn. Cộng thêm O vào công thức thì T* tăng tương ứng. Model cần 2 GPU trở lên thì T* cũng nhân lên.
Các phân tích trong ngành thường đặt ngưỡng hoà vốn trong khoảng 30–60% GPU utilization trung bình, tùy model và nhà cung cấp. Cách an toàn nhất là đo trên dữ liệu của chính bạn: chạy serverless vài tuần, lấy số token thực tế, rồi benchmark throughput của model trên GPU định thuê.
Khi nào nên chọn Serverless Inference và khi nào nên tự host model trên GPU riêng?
Sau khi đánh giá chi phí, doanh nghiệp cần xem xét đặc điểm workload và nguồn lực kỹ thuật để xác định phương án phù hợp.
Chọn Serverless Inference khi:
- Sản phẩm đang ở giai đoạn PoC hoặc MVP. Chưa biết lượng người dùng thì chưa nên cam kết công suất GPU.
- Traffic thấp hoặc biến động mạnh. Ví dụ chatbot nội bộ chỉ dùng trong giờ làm việc, hoặc tác vụ xử lý tài liệu chạy theo batch.
- Cần thử nhiều model. Đổi model chỉ cần đổi tên model trong API request, không phải triển khai lại.
- Đội ngũ chưa có người chuyên MLOps. Thời gian kỹ sư nên dành cho sản phẩm.
Chọn tự host model trên GPU riêng khi:
- Lượng token lớn và đều. GPU utilization duy trì cao qua nhiều tuần, vượt điểm hoà vốn đã tính.
- Dùng model riêng. Bản fine-tune trên dữ liệu doanh nghiệp (xem vì sao foundation model chưa đáp ứng tác vụ đặc thù), model quantize theo cấu hình riêng, hoặc model chưa có trên nền tảng serverless.
- Cần latency ổn định. Ứng dụng real-time cần time to first token (TTFT) ổn định, không phụ thuộc tải của khách hàng khác và không bị rate limit.
- Cần kiểm soát dữ liệu chặt. Ngành BFSI và y tế thường cần biết chính xác prompt và log nằm ở đâu, ai truy cập được (xem vì sao vị trí xử lý dữ liệu quan trọng trong kỷ nguyên AI).
Nếu workload rơi vào cả hai nhóm, đó là tín hiệu nên dùng mô hình kết hợp.
Mô hình kết hợp Serverless Inference và tự host model trên GPU riêng để tối ưu AI workload
Doanh nghiệp không nhất thiết phải lựa chọn hoàn toàn một trong hai phương án.
Trên thực tế, kiến trúc hybrid inference có thể kết hợp GPU riêng với Serverless Inference để cân bằng giữa chi phí, hiệu năng và khả năng mở rộng. Phần lớn doanh nghiệp không chọn hẳn một bên. Ba mô hình kết hợp phổ biến:
- GPU riêng xử lý tải nền, Serverless Inference đáp ứng tải đột biến. GPU riêng xử lý phần tải nền ổn định. Serverless Inference nhận phần vượt đỉnh. Công suất GPU nên tính theo mức tải nền, không tính theo đỉnh.
- Phân bổ hạ tầng theo đặc điểm tác vụ. Tác vụ real-time chạy trên GPU riêng (tham khảo kiến trúc low-latency cho RAG và AI agent). Tác vụ batch, không có người đang chờ kết quả, chạy qua serverless.
- Sử dụng Serverless Inference cho thử nghiệm, GPU riêng cho production. Dev và staging dùng serverless để thử model nhanh. Production dùng GPU riêng khi lượng token đã đủ lớn.
Trước khi chuyển một workload từ Serverless Inference sang GPU riêng, đây là checklist 7 điều cần kiểm tra trước khi đưa ra quyết định cho doanh nghiệp:
- Dữ liệu sử dụng: Đã thu thập tối thiểu 4–8 tuần dữ liệu token, bao gồm phân bố traffic theo giờ và thời điểm cao điểm.
- Hiệu năng thực tế: Đã benchmark throughput, TTFT và latency trên đúng loại GPU dự kiến sử dụng.
- Yêu cầu phần cứng: Đã xác định số lượng GPU, dung lượng VRAM và nhu cầu quantization của model (ví dụ so sánh H100 và H200).
- Tổng chi phí: Đã tính cả chi phí thuê GPU, nhân sự vận hành, monitoring và lưu trữ.
- Chất lượng model: Đã kiểm tra sự tương đồng về chất lượng đầu ra giữa hai môi trường triển khai, bao gồm phiên bản model và cấu hình quantization.
- Năng lực vận hành: Có đội ngũ chịu trách nhiệm giám sát, cập nhật và xử lý sự cố.
- Phương án dự phòng: Đã thiết kế cơ chế fallback khi GPU quá tải, bảo trì hoặc gặp sự cố.
Triển khai Serverless Inference và GPU riêng trên hạ tầng GreenNode
GreenNode cung cấp cả hai cách trên cùng một hạ tầng, nên doanh nghiệp có thể bắt đầu nhỏ và chuyển dần mà không đổi nhà cung cấp.
- Serverless Inference (MaaS): gọi model qua API tương thích OpenAI, trả theo token, không phí cố định hàng tháng. Các model open-weight do GreenNode tự host chạy trên hạ tầng tại Việt Nam và Đông Nam Á (8 model self-host vừa ra mắt).
- GPU Instances: thuê GPU NVIDIA theo nhu cầu (H200, H100, L40S, A40, RTX 5090, RTX 4090) để tự triển khai model, kể cả bản fine-tune.
Nếu cần linh hoạt, GreenNode cũng có các lựa chọn compute cho inference không ràng buộc hợp đồng dài hạn. Lộ trình gợi ý: bắt đầu với Serverless Inference để đo lượng token thực tế, sau đó chuyển phần tải nền sang GPU Instances khi vượt điểm hoà vốn.
Câu hỏi thường gặp
Serverless Inference có bị cold start không?
Với model phổ biến mà nhà cung cấp luôn giữ sẵn (warm), cold start gần như không đáng kể. Cold start chủ yếu xảy ra với nền tảng serverless GPU phải tải model của bạn vào bộ nhớ khi có request đầu tiên.
Có thể chạy model fine-tune trên Serverless Inference không?
Phụ thuộc nhà cung cấp. Nếu nền tảng không hỗ trợ triển khai model riêng, thuê GPU riêng là cách trực tiếp nhất.
Khi nào nên tính lại điểm hoà vốn?
Khi giá token thay đổi, khi đổi sang model khác kích thước, hoặc khi lượng token thay đổi đáng kể so với lần tính trước.
Chuyển từ serverless sang GPU riêng có phải sửa code nhiều không?
Nếu cả hai đều dùng API tương thích OpenAI (vLLM và SGLang đều hỗ trợ), thường chỉ cần đổi base URL và tên model.
