
Với ngân hàng, bảo hiểm và fintech, dữ liệu không chỉ là tài sản phục vụ vận hành mà còn là một phần cốt lõi của hoạt động kinh doanh. Khi ngày càng nhiều workload, từ hệ thống nghiệp vụ đến AI, được triển khai trên hạ tầng Cloud, bài toán đặt ra không còn đơn thuần là dữ liệu được lưu trữ ở đâu, mà là doanh nghiệp có thể kiểm soát dữ liệu, workload, khóa mã hóa và quyền truy cập như thế nào trong suốt vòng đời xử lý.
Từ năm 2026, khung quản trị dữ liệu và AI tại Việt Nam tiếp tục được mở rộng với Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 và Nghị định 356/2025/NĐ-CP có hiệu lực từ ngày 01/01/2026; Luật Trí tuệ nhân tạo số 134/2025/QH15 có hiệu lực từ ngày 01/03/2026 và Nghị định 142/2026/NĐ-CP có hiệu lực từ ngày 01/05/2026. Đây cũng là bối cảnh khiến nhiều doanh nghiệp bắt đầu rà soát lại cách tiếp cận quản trị dữ liệu và AI của mình một góc nhìn tổng quan về vấn đề này đã được đề cập trong bài viết trước của chúng tôi, trước khi đi sâu vào từng workload cụ thể ở phần dưới đây.
Bên cạnh đó, các tổ chức trong ngành BFSI cần đặc biệt tuân thủ hệ thống khung pháp lý chuyên ngành:
- Bảo mật thông tin khách hàng: Luật Các tổ chức tín dụng số 32/2024/QH15 và Nghị định 117/2018/NĐ-CP về giữ bí mật, cung cấp thông tin khách hàng.
- An toàn hệ thống thông tin & Đưa workload lên Cloud: Thông tư 09/2020/TT-NHNN của Ngân hàng Nhà nước quy định về an toàn hệ thống thông tin trong hoạt động ngân hàng (cho phép đưa hệ thống cấp độ 3, 4, 5 lên Cloud khi đáp ứng đủ các tiêu chuẩn an toàn kỹ thuật).
- An ninh mạng & Lưu trữ dữ liệu: Luật An ninh mạng số 116/2025/QH15 (hiệu lực từ 01/07/2026) cùng hệ thống Nghị định hướng dẫn như Nghị định 331/2026/NĐ-CP (bảo vệ an ninh mạng đối với hệ thống thông tin), Nghị định 333/2026/NĐ-CP và Nghị định 330/2026/NĐ-CP. Quy định bắt buộc về lưu trữ dữ liệu tại Việt Nam tiếp tục được duy trì và áp dụng nghiêm ngặt đối với các hệ thống thông tin tài chính – ngân hàng.
- Quy định theo use case nghiệp vụ: Luật Phòng, chống rửa tiền số 14/2022/QH15 (quy định về KYC và lưu trữ hồ sơ giao dịch) và Luật Kinh doanh bảo hiểm số 08/2022/QH15.
Điều này khiến lựa chọn Cloud và AI infrastructure gắn chặt hơn với bài toán quản trị: dữ liệu nào được xử lý, ở đâu, ai có quyền truy cập, hạ tầng chịu chi phối bởi hệ thống pháp luật nào, và doanh nghiệp có thể chứng minh điều đó ra sao khi cần kiểm toán. Với ngành BFSI, đây là bài toán cần được nhìn nhận ngay từ khi thiết kế kiến trúc và lựa chọn nhà cung cấp, thay vì chỉ được xem xét sau khi hệ thống đã đi vào vận hành.
1. Vì sao ngành tài chính cần kiểm soát dữ liệu ngay từ đầu?
Với ngân hàng, bảo hiểm và fintech, không phải mọi dữ liệu đều có cùng mức độ nhạy cảm và mọi workload cũng cần cùng một mức kiểm soát. Vì vậy, khi đánh giá Cloud, câu hỏi đầu tiên không nên là “Dữ liệu được lưu ở đâu?” mà là “Doanh nghiệp đang xử lý loại dữ liệu nào, cho mục đích gì và dữ liệu đi qua những đâu trong suốt vòng đời?”
Điều này càng quan trọng khi AI được đưa vào các quy trình nghiệp vụ. Ngoài dữ liệu nguồn, một AI workload có thể phát sinh dataset, prompt, output, embedding, model artifact, log và backup. Doanh nghiệp vì vậy cần xác định rõ dữ liệu nào được xử lý, nơi lưu trữ và xử lý, ai có quyền truy cập và những control nào cần được duy trì.
Với BFSI, kiểm soát dữ liệu không bắt đầu từ việc chọn Cloud nào, mà bắt đầu từ việc hiểu rõ dữ liệu và workload mà doanh nghiệp đang đưa lên Cloud.
2. Phân tầng dữ liệu theo mức độ nhạy cảm để xác định mức kiểm soát tương ứng
Sau khi đã xác định được phạm vi dữ liệu và workload, bước tiếp theo là phân tầng dữ liệu để gắn mỗi nhóm với một mức kiểm soát tương ứng.
Một bước quan trọng trước khi lựa chọn Cloud là xác định dữ liệu nào đang được xử lý, dữ liệu đó thuộc nhóm nào và workload có liên quan đến những yêu cầu quản trị nào.
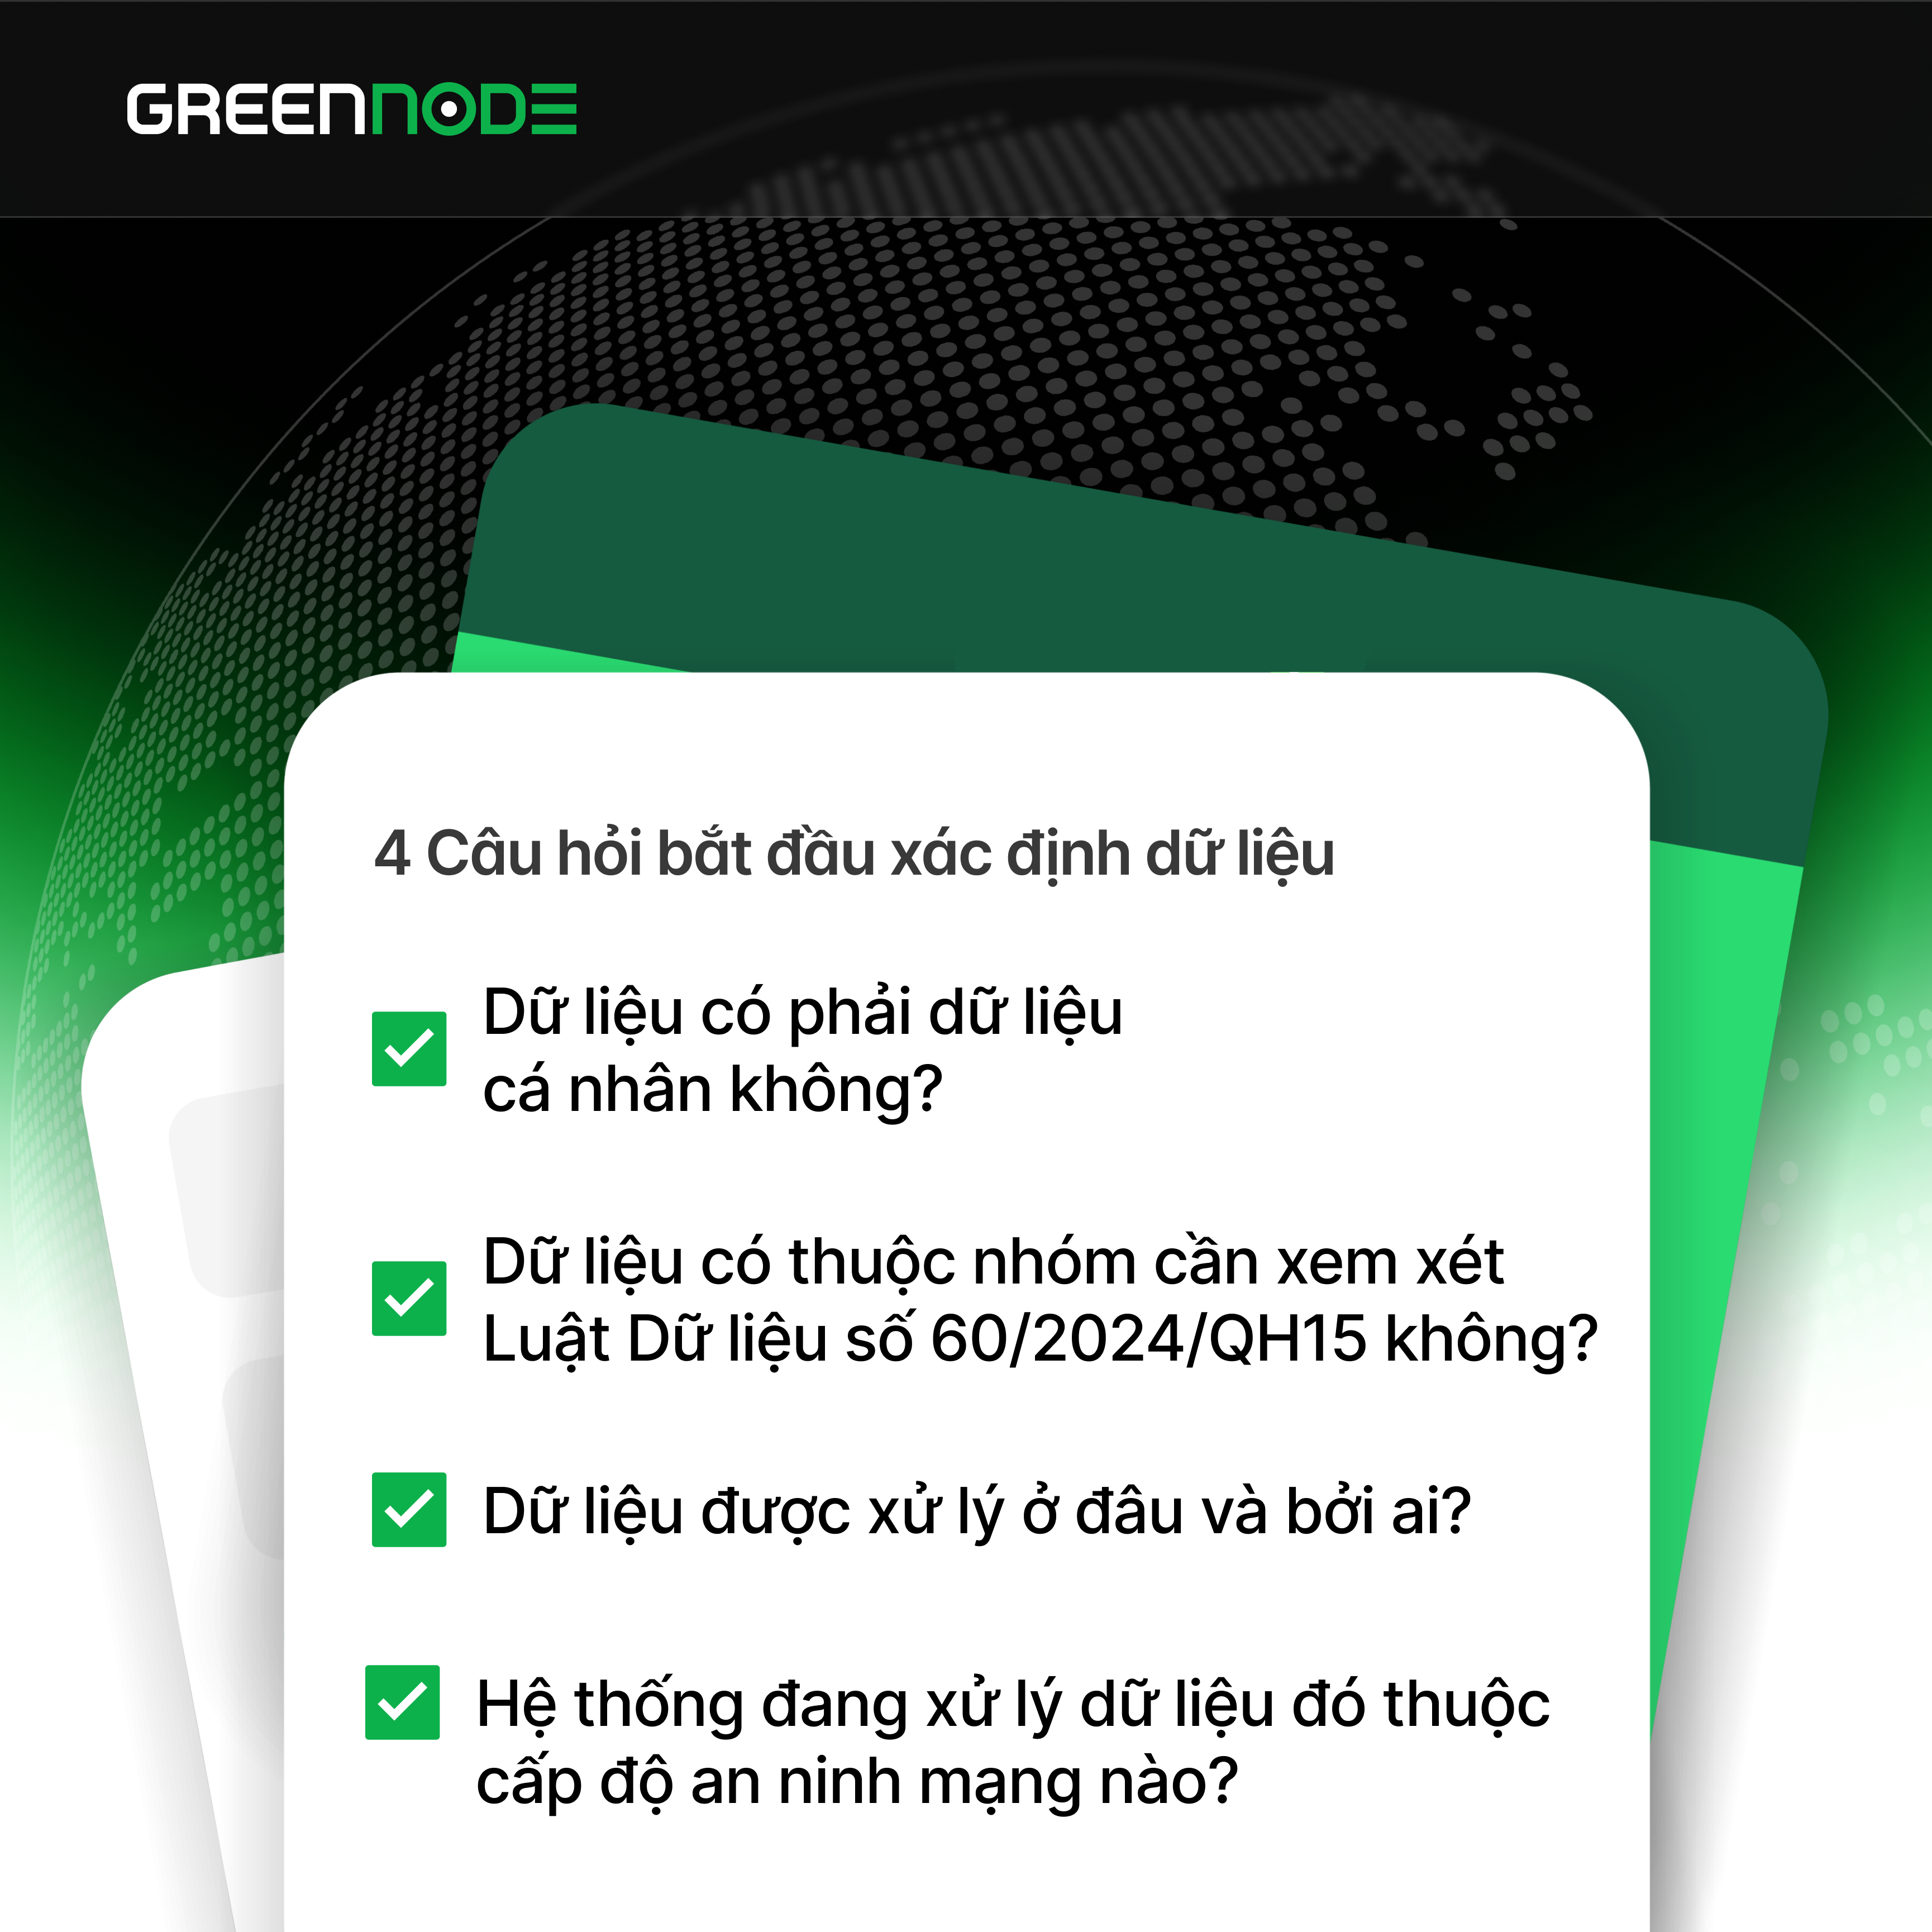
Bạn có thể bắt đầu từ 4 câu hỏi để xác định dữ liệu:
1. Dữ liệu có phải dữ liệu cá nhân không?
Nếu có, cần tiếp tục xác định đó là dữ liệu cá nhân cơ bản hay dữ liệu cá nhân nhạy cảm. Các nhóm như dữ liệu tài chính, sinh trắc học, sức khỏe, vị trí... được xếp vào nhóm dữ liệu cá nhân nhạy cảm. Với BFSI, điều này đặc biệt liên quan đến các use case như KYC, xác thực danh tính, AI và bảo hiểm.
2. Dữ liệu có thuộc nhóm cần xem xét thêm theo quy định về dữ liệu quan trọng, dữ liệu cốt lõi tại Luật Dữ liệu số 60/2024/QH15 không?
Ở đây không nên mặc định mọi dữ liệu tài chính đều thuộc một nhóm duy nhất. Cần xem xét bản chất dữ liệu, quy mô, ngưỡng áp dụng và bối cảnh xử lý. Danh mục dữ liệu quan trọng, dữ liệu cốt lõi do Thủ tướng Chính phủ ban hành, vì vậy doanh nghiệp nên đối chiếu với danh mục hiện hành thay vì tự suy đoán.
3. Dữ liệu được xử lý ở đâu và bởi ai?
Đây là điểm nối trực tiếp sang bài toán Sovereign Cloud: dữ liệu được lưu trữ tại Việt Nam hay ngoài Việt Nam, ai là bên xử lý, có sub-processor hay không và workload có phát sinh xử lý xuyên biên giới hay không.
4. Hệ thống đang xử lý dữ liệu đó thuộc cấp độ an ninh mạng nào?
Ngoài việc phân loại bản thân dữ liệu, doanh nghiệp cần xác định cấp độ của hệ thống thông tin đang xử lý dữ liệu đó. Nghị định 331/2026/NĐ-CP ngày 19/8/2026 quy định tiêu chí, thẩm quyền và trình tự xác định cấp độ hệ thống thông tin theo 5 cấp độ gắn với mức độ quan trọng và rủi ro, trong đó quy mô dữ liệu cá nhân được xử lý là một trong các tiêu chí đối chiếu, và kết quả đánh giá rủi ro cũng là một cơ sở để xác định cấp độ. Với BFSI, hệ thống nghiệp vụ lõi và hệ thống phục vụ khách hàng thường thuộc nhóm cấp độ cao, kéo theo yêu cầu bảo vệ chặt hơn và ảnh hưởng trực tiếp đến việc workload đó có thể triển khai trên Cloud theo mô hình nào.
Nhìn xa hơn, dự thảo Luật An ninh dữ liệu do Bộ Công an chủ trì đề xuất phân loại dữ liệu theo 04 cấp độ rủi ro an ninh: dữ liệu thông thường (cấp độ 1), dữ liệu nội bộ (cấp độ 2), dữ liệu quan trọng (cấp độ 3) và dữ liệu cốt lõi (cấp độ 4), căn cứ vào tính chất, quy mô tích tụ và mức độ tác động của dữ liệu. Dự thảo cũng đặt ra nguyên tắc dữ liệu ở cấp độ thấp hơn khi tích tụ đạt ngưỡng quy mô lớn, làm thay đổi bản chất rủi ro, sẽ được áp dụng cấp độ bảo vệ cao hơn tương ứng, kèm yêu cầu tổ chức vận hành hệ thống phải có cơ chế tự động giám sát, cảnh báo khi quy mô tích tụ vượt ngưỡng.
Dự thảo này chưa có hiệu lực và nội dung còn có thể thay đổi, nên không phải là nghĩa vụ tuân thủ ở thời điểm hiện tại. Tuy vậy, với BFSI nơi dữ liệu tích tụ rất nhanh theo số lượng khách hàng và giao dịch việc bắt đầu gán nhãn dữ liệu theo tư duy phân tầng này ngay từ bây giờ sẽ giúp doanh nghiệp tránh việc phải phân loại lại toàn bộ khối dữ liệu khi khung pháp lý được ban hành. Cũng cần phân biệt hai trục phân loại khác nhau và cần đánh giá song song: cấp độ của hệ thống thông tin theo pháp luật an ninh mạng, và cấp độ của bản thân dữ liệu theo cách tiếp cận nêu trên.
Vậy nên thay vì hỏi “dữ liệu nào cần tuân thủ?”, hãy hỏi:
Dữ liệu này là gì → mức độ nhạy cảm ra sao → được sử dụng cho workload nào → được xử lý ở đâu → ai có quyền truy cập → và cần những control nào để quản trị trong suốt vòng đời?
Đây là cách tiếp cận thực tế hơn khi thiết kế Cloud cho BFSI.
3. AI mở rộng phạm vi dữ liệu cần quản trị
AI làm cho bài toán quản trị dữ liệu trở nên phức tạp hơn vì dữ liệu có thể được sử dụng ở nhiều bước khác nhau trong vòng đời của một hệ thống AI.
Khi AI được đưa vào production, việc quản trị cũng cần được nhìn xuyên suốt từ dữ liệu, model đến workload và quyền truy cập. Vì vậy, việc phân vai trò trách nhiệm khi vận hành AI là điều không thể thiếu. Một data flow map của hệ thống AI vì vậy không nên chỉ thể hiện:
Database → Application mà cần xem xét toàn bộ chuỗi xử lý.
3.1 AI data lifecycle
Một AI workload có thể đi qua các bước như:
Data ingestion → Processing → Training/Fine-tuning → Inference → Output → Logging → Monitoring
Ở mỗi bước, doanh nghiệp cần xác định dữ liệu nào đang được sử dụng, workload chạy ở đâu và ai có quyền truy cập.
Điều này đặc biệt quan trọng với các hệ thống AI xử lý dữ liệu khách hàng, tài liệu nghiệp vụ hoặc dữ liệu giao dịch.
3.2 Training
Nếu dữ liệu được sử dụng để training hoặc fine-tuning, doanh nghiệp cần xác định:
- Dataset đến từ đâu?
- Dataset chứa loại dữ liệu nào?
- Ai được phép sử dụng?
- Dataset được lưu trữ ở đâu?
Sau khi kết thúc mục đích sử dụng, dữ liệu và các bản sao liên quan được xử lý thế nào?
Ở giai đoạn này, rủi ro không chỉ nằm ở dữ liệu gốc mà còn ở các bản sao, snapshot và artifact sinh ra trong quá trình training, vốn thường bị bỏ sót trong kiểm toán.
Ngoài ra, dưới góc độ pháp lý hiện nay, nhiều quy định về bảo vệ dữ liệu (như GDPR của EU, PDPA của Singapore hoặc pháp luật dữ liệu nội địa áp dụng cho ngành tài chính) đều đặt ra yêu cầu rõ ràng về giới hạn mục đích sử dụng và tối thiểu hóa dữ liệu. Điều này có nghĩa là dữ liệu khách hàng không nên được sử dụng cho mục đích training chỉ vì đang có sẵn trong hệ thống; doanh nghiệp cần xác định rõ cơ sở pháp lý, mục đích xử lý và điều kiện sử dụng phù hợp trước khi đưa dữ liệu vào quá trình huấn luyện hoặc fine-tuning.
Bên cạnh đó, một số quy định trong ngành tài chính còn yêu cầu khả năng truy vết và giải trình đối với dữ liệu được dùng trong mô hình AI, đặc biệt khi mô hình đó ảnh hưởng đến quyết định tín dụng, chống gian lận hoặc đánh giá rủi ro.
3.3 Inference
Ở giai đoạn inference, dữ liệu có thể được gửi vào model thông qua prompt hoặc các ứng dụng tích hợp.
Doanh nghiệp nên xác định:
- Dữ liệu nào được đưa vào prompt?
- Model xử lý workload ở đâu?
- Dữ liệu có được lưu lại hay không?
- Có được sử dụng cho mục đích khác hay không?
- Có thể kiểm soát region hoặc môi trường xử lý hay không?
Với các hệ thống GenAI, đây là điểm nhạy cảm nhất vì prompt có thể chứa thông tin khách hàng, giao dịch hoặc dữ liệu nội bộ.
Từ góc độ tuân thủ, nhiều khung pháp lý hiện nay coi prompt và output của AI là một phần của hoạt động xử lý dữ liệu cá nhân nếu chúng chứa hoặc suy ra thông tin định danh. Điều này kéo theo yêu cầu về lưu trú dữ liệu, chuyển giao dữ liệu xuyên biên giới, và trong một số trường hợp là nghĩa vụ thông báo hoặc kiểm soát việc sử dụng bên thứ ba (ví dụ AI model provider).
Ngoài ra, các quy định mới về AI governance (như EU AI Act, áp dụng theo lộ trình riêng cho từng nhóm rủi ro) cũng đặt ra yêu cầu doanh nghiệp phải có khả năng giải thích được cách hệ thống AI đưa ra quyết định, đặc biệt với các use case có tác động cao trong tài chính.
3.4 Logging
Log thường bị xem nhẹ khi đánh giá data flow của AI.
Trong thực tế, log có thể chứa thông tin về request, response, user, system event hoặc metadata liên quan đến quá trình xử lý.
Vì vậy, câu hỏi “dữ liệu khách hàng nằm ở đâu?” nên được mở rộng thành:
Dataset, prompt, embedding, output, log, model artifact và backup đang được lưu trữ và xử lý ở đâu?
Từ góc độ pháp lý, logging cũng là một nguồn dữ liệu nhạy cảm vì nó thường bị lưu trữ lâu hơn mục đích ban đầu, trong khi nhiều quy định về dữ liệu yêu cầu giới hạn thời gian lưu trữ. Nếu log chứa dữ liệu cá nhân hoặc dữ liệu tài chính, doanh nghiệp cần xác định rõ chính sách lưu trữ, quyền truy cập và cơ chế xóa dữ liệu theo yêu cầu của chủ thể dữ liệu — tại Việt Nam là quyền yêu cầu xóa dữ liệu cá nhân theo Luật Bảo vệ dữ liệu cá nhân; trong GDPR, quyền tương đương thường được gọi là Right to Erasure (Right to be Forgotten.
Đây cũng là lý do việc lựa chọn Cloud ngày càng trở thành một phần của chương trình quản trị dữ liệu và AI, thay vì chỉ là quyết định về giá, hiệu năng hay SLA.
4. Yêu cầu của kiểm toán là bằng chứng vận hành, không phải văn bản chính sách
Một chính sách có thể quy định rằng chỉ một số vai trò nhất định được phép truy cập dữ liệu.
Nhưng câu hỏi tiếp theo của kiểm toán sẽ là:
Hệ thống có thực sự thực thi chính sách đó không?
Đây là điểm doanh nghiệp cần giải trình:
Ví dụ, nếu doanh nghiệp quy định:
Dữ liệu chỉ được xử lý trong một phạm vi nhất định
→ cần có kiến trúc và bằng chứng vận hành để kiểm chứng.
Chỉ một số role được truy cập dataset
→ IAM cần thực thi và ghi nhận quyền truy cập.
Dữ liệu phải được xóa sau khi kết thúc mục đích xử lý
→ hệ thống cần hỗ trợ thực hiện và kiểm chứng quá trình xóa.
AI cần sự giám sát của con người
→ cần có cơ chế để con người thực sự có thể xem xét hoặc can thiệp khi phù hợp.
Nói cách khác:
Compliance không chỉ là có policy; đó còn là khả năng chứng minh policy đang được thực thi.
Đây cũng là cách tiếp cận đã được GreenNode đề cập trong việc chuyển các yêu cầu kiểm soát thành những kiểm soát và bằng chứng kỹ thuật có thể triển khai trong thực tế.
5. Duy trì vai trò của con người trong các quyết định tác động trực tiếp đến khách hàng
Khi AI được đưa vào các quy trình tài chính, việc quản trị không dừng lại ở dữ liệu và hạ tầng.
Doanh nghiệp cũng cần xác định AI đang đóng vai trò gì trong quy trình ra quyết định, chẳng hạn hỗ trợ phân tích hồ sơ, phát hiện bất thường, xử lý tài liệu hoặc đưa ra đề xuất cho nhân viên.
Với những quy trình có tác động trực tiếp đến khách hàng, doanh nghiệp cần xác định rõ:
- AI đang đưa ra quyết định cuối cùng hay hỗ trợ con người đưa ra quyết định?
- Khi kết quả AI có dấu hiệu bất thường, ai có quyền xem xét hoặc can thiệp?
- Quyết định hoặc kết quả AI có thể được truy vết về dữ liệu, model và quy trình xử lý hay không?
Luật Trí tuệ nhân tạo số 134/2025/QH15 đã có hiệu lực từ ngày 01/03/2026; cùng với Nghị định 142/2026/NĐ-CP, việc quản trị AI cần được xem xét theo toàn bộ vòng đời và vai trò của các bên liên quan.
Điều này không có nghĩa mọi AI workload đều cần cùng một mô hình governance. Điều quan trọng là doanh nghiệp phải xác định đúng mức độ rủi ro, vai trò của AI và trách nhiệm của từng bên trong hệ thống.
6. GreenNode đồng hành cùng MSB xây dựng hạ tầng an toàn, hỗ trợ tuân thủ cho ngành tài chính
Trong quá trình đồng hành cùng MSB, GreenNode triển khai hạ tầng cloud tích hợp với hạ tầng hiện có của doanh nghiệp (hybrid cloud), giúp MSB mở rộng các workload AI trên nền tảng vừa đáp ứng yêu cầu về hiệu năng, vừa chú trọng bảo mật và hỗ trợ ngân hàng kiểm soát, làm chủ dữ liệu.
Trên nền tảng này, MSB đã triển khai các ứng dụng như AI Agent Gamma và GenAI HR Chatbot. Theo MSB, các hệ thống này đã xử lý khoảng 20.000 câu hỏi/tháng, hơn 300.000 bộ hồ sơ và phục vụ hơn 8.000 cán bộ nhân viên.
Bên cạnh năng lực triển khai AI, mô hình AI Cloud có chủ quyền cũng là một định hướng trong hợp tác giữa GreenNode và MSB, nhằm hỗ trợ ngân hàng mở rộng AI trên nền tảng có khả năng kiểm soát dữ liệu, hạ tầng và workload phù hợp với yêu cầu của ngành tài chính.
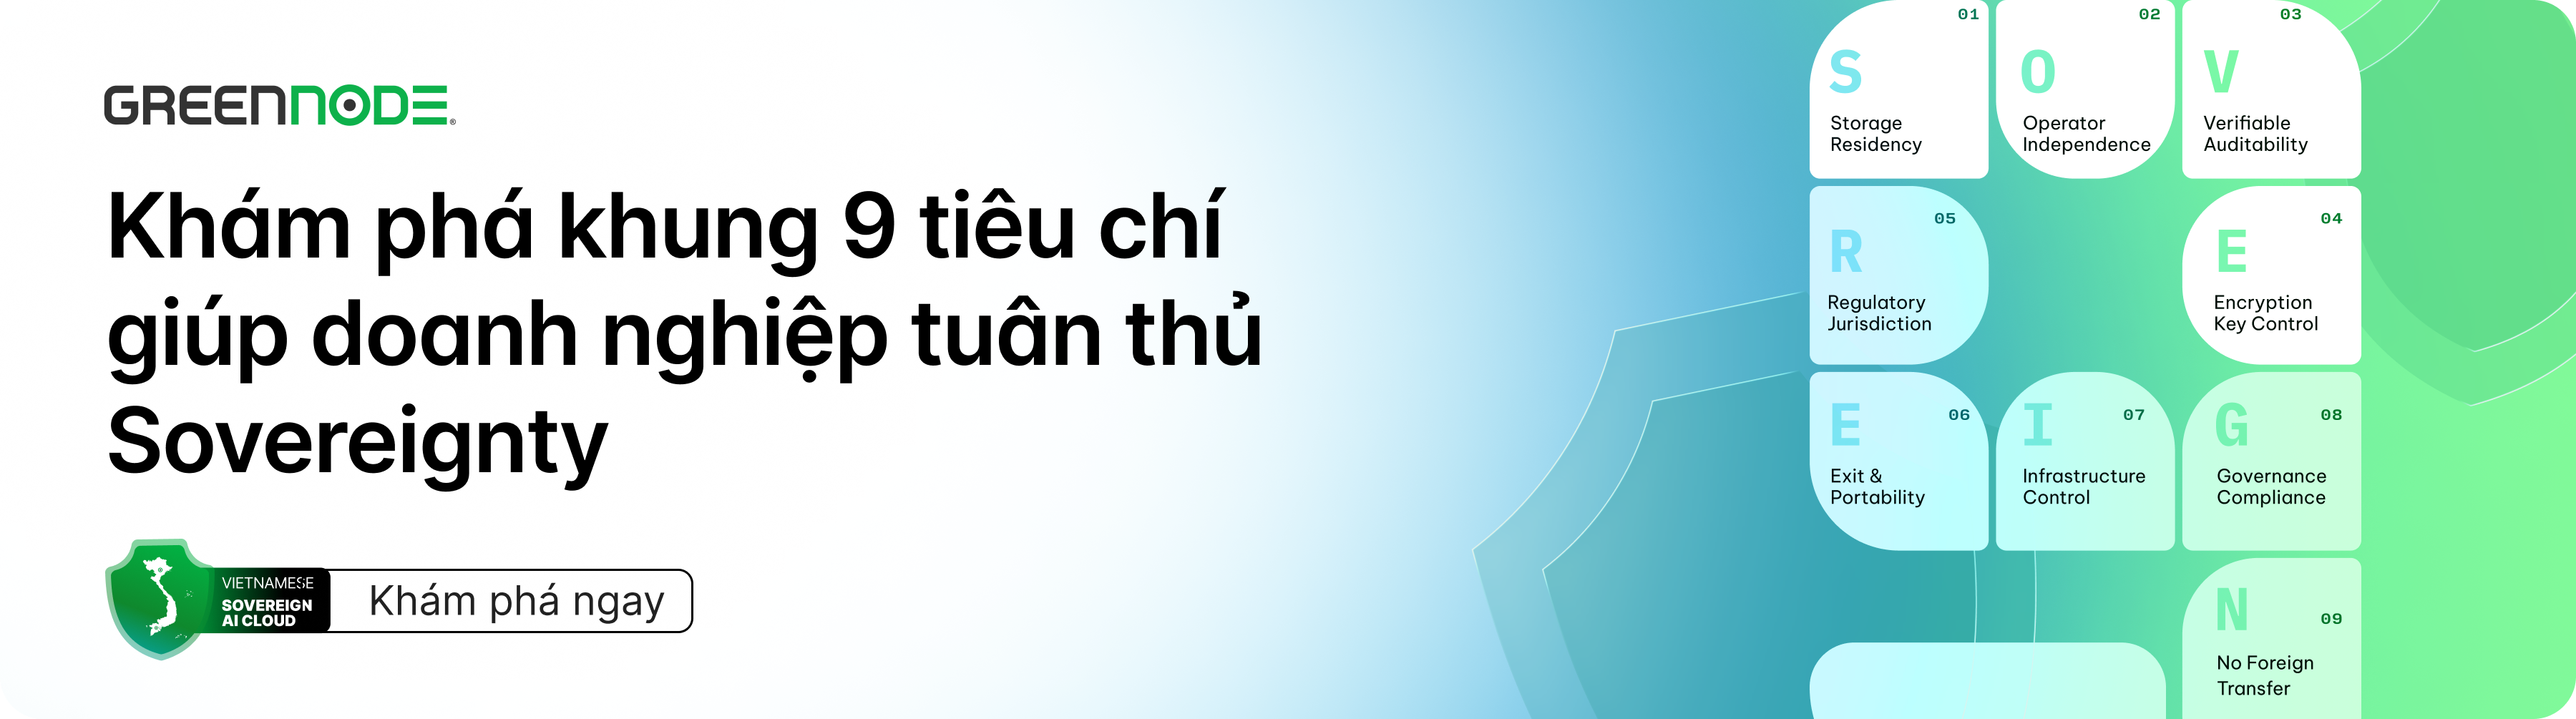
Banner xem thêm case study BFSI để tìm hiểu sâu hơn về cách GreenNode đồng hành cùng doanh nghiệp tài chính trong triển khai hạ tầng AI Cloud đáp ứng các yêu cầu về chủ quyền dữ liệu
Câu hỏi thường gặp
Sovereign Cloud cho ngân hàng là gì?
Sovereign Cloud cho ngân hàng là mô hình hạ tầng Cloud được thiết kế để tổ chức có khả năng kiểm soát rõ hơn về nơi dữ liệu và workload được lưu trữ, xử lý, tài phán áp dụng và quyền kiểm soát/vận hành dữ liệu. Với ngân hàng, việc đánh giá cần được thực hiện theo workload và loại dữ liệu cụ thể thay vì chỉ dựa trên vị trí của data center.
Data sovereignty trong tài chính ngân hàng khác data residency như thế nào?
Data residency tập trung vào nơi dữ liệu được lưu trữ hoặc xử lý. Data sovereignty mở rộng phạm vi sang quyền kiểm soát và hệ thống pháp luật có thể chi phối dữ liệu. Vì vậy, dữ liệu được lưu tại Việt Nam chưa phải là yếu tố duy nhất cần đánh giá khi doanh nghiệp muốn kiểm soát chủ quyền dữ liệu.
Khi sử dụng AI, ngân hàng cần quản trị thêm những loại dữ liệu nào?
Ngoài dữ liệu nguồn, doanh nghiệp có thể cần xem xét dataset, prompt, embedding, vector database, model artifact, output, log và backup. Các thành phần này cần được đưa vào data flow map để xác định nơi xử lý, quyền truy cập và vòng đời dữ liệu.
Cloud nào phù hợp cho doanh nghiệp tài chính cần tuân thủ dữ liệu tại Việt Nam?
Một nền tảng cloud phù hợp với doanh nghiệp tài chính thường thể hiện rõ ba điều: dữ liệu được lưu trữ và xử lý ở đâu, pháp nhân nào thực sự vận hành hạ tầng đó, và doanh nghiệp có thể tự kiểm soát được truy cập, khóa mã hóa đến mức nào. Với ngành tài chính, nên ưu tiên nền tảng có pháp nhân vận hành và trung tâm dữ liệu cùng nằm trong phạm vi tài phán được xác định rõ ràng, có chứng nhận như ISO 27001, SOC 2, và hỗ trợ được đầy đủ nhật ký (audit log) khi cần đối chiếu vận hành. Doanh nghiệp nên trao đổi trực tiếp với nhà cung cấp về ba điểm này, và xác nhận cùng đội Pháp chế/DPO nội bộ với các yêu cầu tuân thủ cụ thể của tổ chức.
Nội dung mang tính tham khảo, không thay thế ý kiến pháp lý
