
Khi lựa chọn nền tảng AI inference (suy luận AI), tốc độ và giá API thường là những yếu tố đầu tiên được đem ra so sánh. Nhưng với các đội ngũ phát triển sản phẩm tại Việt Nam và Đông Nam Á, hai con số đó chưa đủ để đưa ra quyết định.
Một model có thể đạt tốc độ xử lý ấn tượng trên benchmark, nhưng trải nghiệm thực tế vẫn phụ thuộc vào khoảng cách từ người dùng đến GPU. Một API có thể kết nối hàng trăm model, nhưng request của bạn sẽ đi qua những hệ thống nào trước khi được xử lý? Và nếu ứng dụng sử dụng dữ liệu khách hàng, bạn có biết chính xác dữ liệu được xử lý ở đâu không? Đây là những câu hỏi cần được đặt ra khi lựa chọn AI inference platform cho thị trường châu Á - Thái Bình Dương (APAC).
Bài viết này sẽ giúp bạn phân biệt inference provider với API router và dịch vụ AI managed, so sánh 7 nền tảng dựa trên thông tin công khai, đồng thời lựa chọn giải pháp phù hợp với workload, ngân sách và yêu cầu quản trị dữ liệu của doanh nghiệp.
Nhà cung cấp AI Inference là gì, và khác API router ở đâu?
Nhà cung cấp AI Inference trực tiếp vận hành hoặc kiểm soát hạ tầng chạy model, còn API router đóng vai trò trung gian, chuyển request đến các provider khác nhau.
Để biết dữ liệu của bạn thực sự được xử lý ở đâu, hãy hỏi mọi nền tảng một câu: GPU nào đang chạy prompt của tôi? Câu trả lời giúp xác định bên nào có thể tiếp cận dữ liệu, bên nào ảnh hưởng trực tiếp đến latency và hợp đồng nào bảo vệ dữ liệu của bạn.
- Inference provider trực tiếp: sở hữu hoặc kiểm soát hạ tầng thực thi model, bao gồm GPU, hệ thống batching và caching. Một số provider sử dụng GPU thuê hoặc hạ tầng đa cloud thay vì sở hữu toàn bộ phần cứng. Ví dụ: Together AI, Fireworks AI, Groq, DeepInfra, Baseten.
- API router hoặc gateway: API router cung cấp một giao diện chung để gửi request đến nhiều inference provider khác nhau. Thay vì tích hợp từng API riêng lẻ, developer có thể sử dụng một API key và lựa chọn model từ nhiều nguồn. Ví dụ: OpenRouter.
- Managed AI platform: nền tảng cloud, thường được cung cấp dưới dạng Model as a Service (MaaS), phục vụ một số model trên hạ tầng của mình và cung cấp lại các model khác từ vendor theo hợp đồng. Ví dụ: Amazon Bedrock, GreenNode MaaS. Trong cùng một nền tảng, câu trả lời cho "GPU của ai?" có thể khác nhau theo từng model.
Đánh đổi giữa các lựa chọn thường khá rõ ràng. Router thêm một hop mạng, nên không thể làm latency trung vị nhanh hơn, dù có thể tăng độ ổn định bằng cách chuyển khỏi upstream đang chậm. Và cam kết zero retention của router chỉ áp dụng cho router, chưa chắc áp dụng cho mọi upstream mà nó gửi dữ liệu tới (Fireworks). Với dữ liệu bị quản lý, ít hop hơn và ký hợp đồng trực tiếp với bên chạy GPU là lựa chọn an toàn hơn.
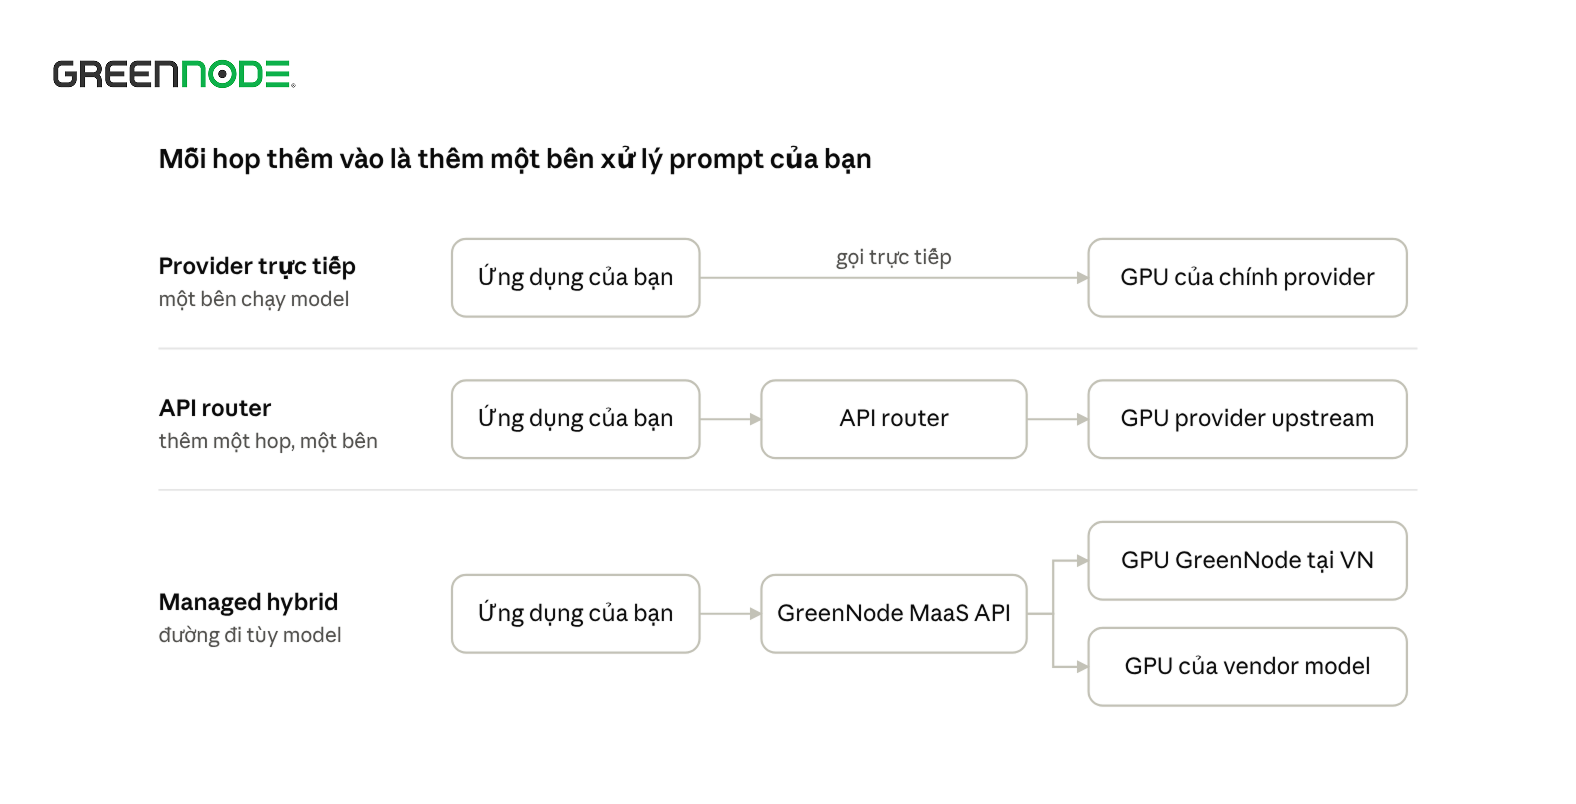
Với một nền tảng managed hybrid như GreenNode MaaS, model self-host nằm trên GPU của chính nền tảng, còn model partner đi thêm một hop tới vendor của model.
Sáu tiêu chí so sánh nền tảng AI inference từ góc nhìn APAC
Đánh giá mọi nền tảng theo sáu điểm: quyền kiểm soát việc thực thi, latency từ khu vực của bạn, quản trị dữ liệu, danh mục model, mô hình giá và hỗ trợ. Các bài so sánh từ Mỹ thường xét tốc độ và giá trước. Với đội ngũ APAC, ba tiêu chí đầu tiên quyết định nền tảng có dùng được hay không.
| Tiêu chí | Câu cần hỏi provider | Vì sao quan trọng ở APAC |
|---|---|---|
| 1. Quyền kiểm soát thực thi | Doanh nghiệp chạy model này trên GPU của mình, hay chuyển tiếp cho bên khác? | Quyết định ai thấy dữ liệu và doanh nghiệp có thể quy trách nhiệm cho ai |
| 2. Latency từ khu vực của doanh nghiệp | GPU của doanh nghiệp ở region nào? | Con số tokens/sec được đo gần GPU; mỗi request của người dùng còn phải cộng thêm một vòng vượt Thái Bình Dương |
| 3. Quản trị dữ liệu và sub-processor | Bạn có lưu prompt không? Zero retention là mặc định bật hay không? Sub-processor là ai, ở quốc gia nào? | Quy định chuyển dữ liệu xuyên biên giới (ví dụ Luật BVDLCN của Việt Nam) áp dụng cho mọi hop, không chỉ hop đầu tiên |
| 4. Danh mục model | Có những model open-weight và closed-weight nào? Model mới được bổ sung với tần suất ra sao? | Vị trí triển khai và điều kiện xử lý có thể khác nhau giữa các model trên cùng nền tảng |
| 5. Mô hình giá | Tính phí theo token, GPU-giờ hay endpoint chuyên dụng? Có mức sử dụng tối thiểu không? | Chi phí thực tế còn phụ thuộc vào traffic, cache, độ dài context và mức sử dụng tài nguyên |
| 6. SLA và hỗ trợ | Có SLA uptime không? Giờ hỗ trợ có trùng múi giờ của bạn không? | Hàng đợi ticket theo giờ Mỹ nghĩa là phải chờ qua đêm khi có sự cố ở châu Á |
Tuy nhiên, đừng chỉ dựa vào benchmark do nhà cung cấp công bố. Hãy đo latency từ khu vực người dùng của bạn. Có thể gửi cùng một prompt 100 lần từ một VM trong khu vực, sau đó so sánh time-to-first-token (TTFT) trung vị và p95 giữa các nền tảng. Để có checklist đầy đủ hơn sáu tiêu chí này, xem thêm hướng dẫn đánh giá nhà cung cấp Model-as-a-Service.
So sánh các nền tảng AI inference hàng đầu 2026
Không có một nền tảng phù hợp nhất cho mọi workload. Groq nổi bật về tốc độ với các model được hỗ trợ; Fireworks AI cung cấp tùy chọn dedicated deployment tại nhiều địa điểm APAC; Amazon Bedrock có độ phủ region APAC rộng; trong khi GreenNode MaaS có hạ tầng GPU tại Việt Nam theo thông tin trong tài liệu nguồn. Bảng dưới đây tổng hợp thông tin do các nhà cung cấp công bố. Đây không phải kết quả benchmark độc lập: latency thực tế cần được đo từ khu vực và workload của doanh nghiệp.
| Nền tảng | Loại | Hiện diện tại APAC (công khai) | Lưu giữ dữ liệu (mặc định công khai) | Mô hình giá | Phù hợp nhất cho |
|---|---|---|---|---|---|
| Together AI | Provider trực tiếp | Không công bố danh sách region APAC; dedicated endpoint private/VPC theo yêu cầu | Zero retention phải tự bật, theo từng tổ chức | Serverless theo token + dedicated endpoint | Danh mục model open rộng, fine-tune |
| Fireworks AI | Provider trực tiếp | Dedicated deployment tại Tokyo, Đài Loan, Malaysia và New South Wales (cần xin quota) | Zero retention mặc định với model open | Serverless theo token từ $0.10/1M; GPU on-demand từ $7/GPU-giờ | Model open nhanh, dedicated deployment ở APAC |
| GreenNode MaaS | Dịch vụ AI managed, hybrid | Availability zone tại Hà Nội, TP.HCM và Bangkok | Model self-host chạy trên GPU GreenNode; model partner được chuyển tới vendor theo hợp đồng | Theo token (input, cache, output), trả trước hoặc trả sau | Đội ngũ Việt Nam và Đông Nam Á cần lưu trú dữ liệu trong nước |
| Groq | Provider trực tiếp (chip LPU) | Site 4.5 MW tại Sydney cùng Equinix, ra mắt 11/2025 | Mặc định không lưu inference; log chống lạm dụng tới 30 ngày nếu chưa bật ZDR; dữ liệu lưu trữ ở GCP tại Mỹ | Theo token, có gói miễn phí | Latency thấp nhất với các model open được hỗ trợ |
| DeepInfra | Provider trực tiếp | Không công bố region APAC | Input chỉ nằm trong bộ nhớ, không log; model Google và Anthropic được chuyển tới các vendor đó | Theo token, giá niêm yết thấp | Dùng model open phổ biến với chi phí thấp nhất |
| Baseten | Provider trực tiếp, multi-cloud | Gộp 10+ cloud; có tuỳ chọn khóa region, self-hosted và hybrid | Công bố không bao giờ lưu input hoặc output; SOC 2 Type II, HIPAA | GPU dedicated theo phút + Model API | Model tuỳ biến và đã fine-tune trong production |
| Amazon Bedrock | Dịch vụ AI managed | Runtime tại 13 region APAC, gồm Singapore, Jakarta, Malaysia, Thái Lan, Tokyo, Sydney; chưa có region Việt Nam | Vendor model không truy cập được prompt hay kết quả | Theo token + provisioned throughput | Đội ngũ đã dùng AWS |
Ba lưu ý mà phần lớn bài so sánh bỏ qua:
- "Region APAC" không đồng nghĩa có hạ tầng ngay tại thị trường của doanh nghiệp. GPU ở Sydney hay Tokyo vẫn cách TP.HCM 4.000–7.000 km. Gần hơn Virginia, nhưng chưa phải trong nước. Nếu cần hạ tầng đặt tại Việt Nam, tham khảo các nhà cung cấp cloud hàng đầu tại Việt Nam.
- Dedicated không phải serverless. Các region APAC của Fireworks dành cho dedicated deployment có quota được cấp. Một lệnh gọi serverless vẫn có thể chạy ở nơi khác.
- Đánh giá cả sự thay đổi của nhà cung cấp, không chỉ hiệu năng hiện tại. Các thay đổi về công nghệ, chiến lược hoặc cơ cấu doanh nghiệp có thể ảnh hưởng đến lộ trình sản phẩm. Nếu dự định ký hợp đồng dài hạn, hãy đánh giá roadmap, SLA, điều khoản hợp đồng và phương án chuyển đổi sang provider khác.
GreenNode MaaS Model Catalog: model self-host và model partner
GreenNode MaaS cung cấp hai nhóm model: model self-host chạy trên GPU của GreenNode tại Việt Nam và model bên thứ ba được xử lý trên hạ tầng của vendor tương ứng theo thỏa thuận cung cấp dịch vụ.
Điều đó có nghĩa là nơi xử lý dữ liệu phụ thuộc vào model và endpoint bạn lựa chọn, không chỉ vào tên nền tảng.
| Self-hosted models | Third-party models | |
|---|---|---|
| Ví dụ hiện tại | GLM-5.2 | Kimi K2.7 Code, Kimi 2.6, Qwen 3.7 Plus, MiniMax M3, Gemma 4 31B; các model Claude và GPT |
| GPU của ai | Của GreenNode, trong các availability zone của GreenNode | Của vendor model |
| Prompt đi đâu | Nằm trên hạ tầng GreenNode | Được chuyển tới vendor theo hợp đồng chính thức |
| Phù hợp cho | Workload có dữ liệu cá nhân hoặc dữ liệu bị quản lý cần giữ tại Việt Nam | Tác vụ không chứa dữ liệu cá nhân, cần model frontier hoặc model chuyên biệt |
Danh sách model lấy từ GreenNode MaaS available models, tháng 10/2026.
Doanh nghiệp nên áp dụng điều này như thế nào?
- Với dữ liệu cần được quản lý chặt: cân nhắc endpoint dành riêng chạy model self-hosted tại Việt Nam. Bởi khi endpoint đạt giới hạn tải, request bị từ chối thay vì tự động chuyển sang provider bên ngoài.
- Điều hướng theo mức độ nhạy cảm. Gửi hồ sơ khách hàng, hợp đồng hay ghi chú y tế tới model self-host. Dùng model partner cho nội dung công khai, hỗ trợ coding hoặc tác vụ không có dữ liệu cá nhân.
- Kiểm tra nhãn trước khi xây dựng. Mỗi model trên nền tảng đều được gắn nhãn GreenNode self-host hoặc third-party. Hãy đưa nhãn này vào bước review thiết kế, giống như khi kiểm tra license của một thư viện.
Điều này càng quan trọng sau khi Luật Bảo vệ dữ liệu cá nhân có hiệu lực ngày 01/01/2026: vi phạm về chuyển dữ liệu xuyên biên giới có thể bị phạt tới 5% doanh thu năm trước (xem thêm vì sao doanh nghiệp cần quan tâm AI xử lý dữ liệu ở đâu). Một nền tảng cho bạn biết chính xác từng model chạy ở đâu giúp rủi ro đó trở thành thứ bạn quản lý được.
Cách chọn nền tảng inference theo workload
Phân loại từng workload theo hai câu hỏi: dữ liệu nhạy cảm đến đâu, và bạn cần bao nhiêu model khác nhau? Câu trả lời đặt bạn vào một trong bốn ô, và mỗi ô trỏ tới một loại nền tảng khác nhau. Phần lớn đội ngũ có workload ở nhiều hơn một ô, nên hiếm khi một provider đáp ứng được tất cả.
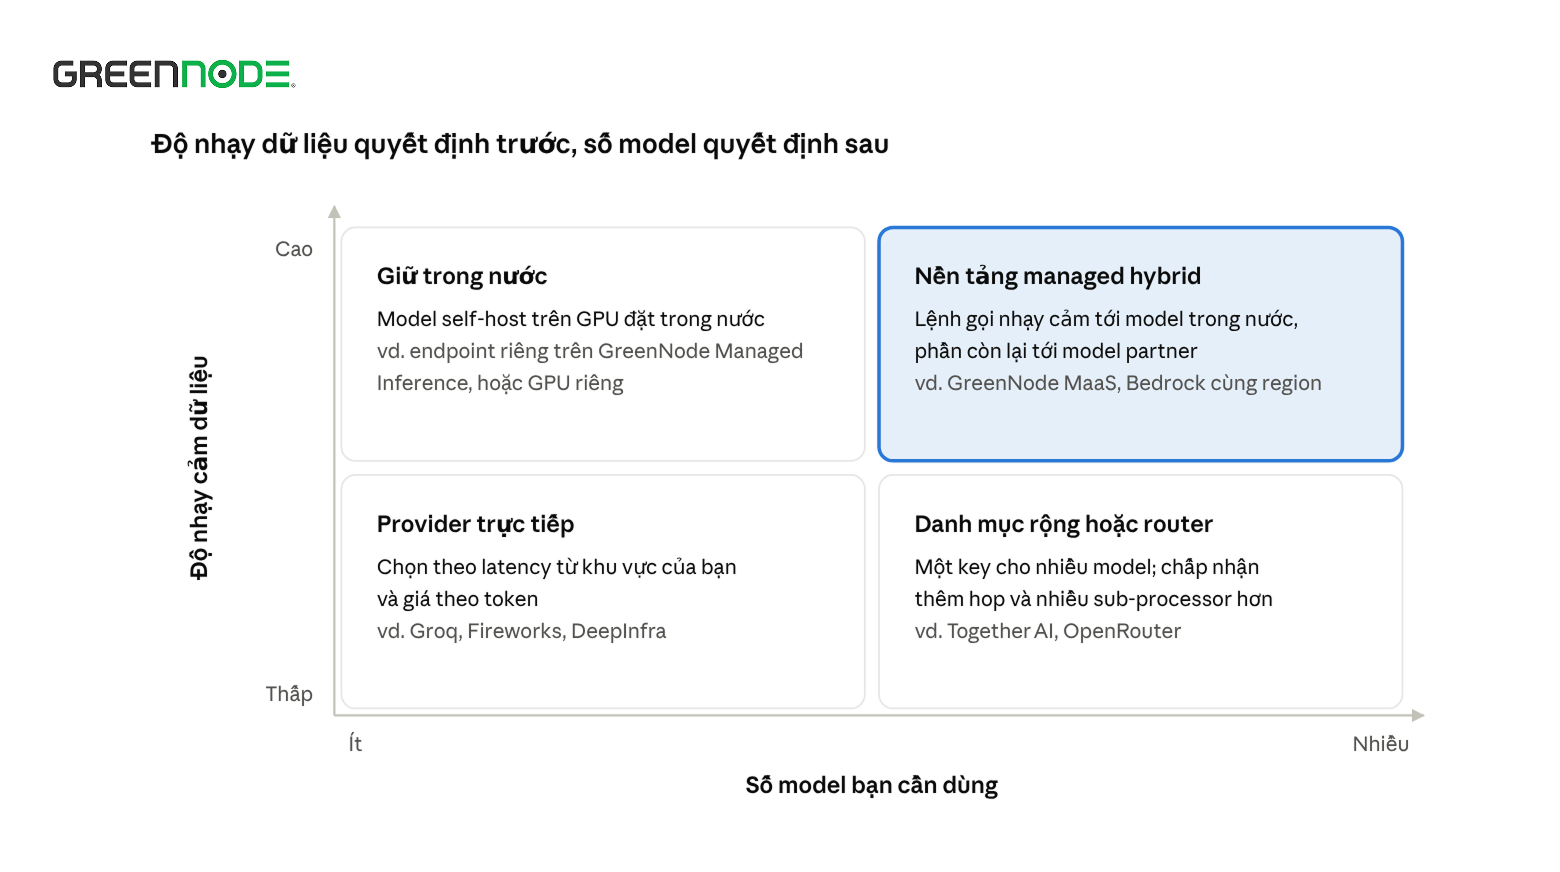
- Dữ liệu nhạy cảm, ít model: giữ inference trong nước. Model self-host trên GPU đặt trong nước, hoặc dedicated endpoint, cho bạn một đường đi dữ liệu ngắn và kiểm toán được. Nếu model còn cần hiểu nghiệp vụ riêng, xem doanh nghiệp Đông Nam Á chuyển từ LLM chung sang AI chuyên biệt như thế nào.
- Dữ liệu nhạy cảm, nhiều model: dùng nền tảng managed có gắn nhãn nơi từng model chạy, để điều hướng lệnh gọi nhạy cảm về trong nước và phần còn lại tới model partner. Đây là lựa chọn của phần lớn doanh nghiệp APAC.
- Dữ liệu ít nhạy cảm, ít model: chọn provider trực tiếp có latency tốt nhất từ khu vực của bạn và giá tốt nhất cho model đó.
- Dữ liệu ít nhạy cảm, nhiều model: danh mục rộng hoặc router sẽ tiện hơn. Chấp nhận thêm một hop và kiểm tra danh sách sub-processor một lần.
Câu hỏi thường gặp
Các nền tảng AI inference hàng đầu năm 2026 là gì?
Phổ biến nhất là Together AI, Fireworks AI, Groq, DeepInfra và Baseten trong nhóm inference provider trực tiếp, và Amazon Bedrock trong nhóm dịch vụ AI managed. Với đội ngũ tại Việt Nam và Đông Nam Á, GreenNode MaaS có thêm GPU tại Hà Nội, TP.HCM và Bangkok.
Inference provider nào nhanh nhất cho LLM?
Theo benchmark đã công bố, các provider dùng chip chuyên dụng như Groq và Cerebras dẫn đầu về tokens per second với các model open được hỗ trợ. Từ APAC, khoảng cách mạng tới GPU có thể lớn hơn lợi thế đó, nên hãy đo time-to-first-token từ chính khu vực của bạn.
Có inference provider miễn phí không?
Groq có gói miễn phí, và một số provider tặng credit ban đầu. Gói miễn phí giới hạn rate khá chặt, dùng để thử nghiệm chứ không dành cho production.
Inference provider và API router khác nhau thế nào?
Inference provider chạy model trên GPU mà họ kiểm soát. API router chuyển request tới một trong nhiều provider, thêm một hop mạng và thêm một bên xử lý dữ liệu của bạn.
Làm sao giữ dữ liệu AI inference trong Việt Nam?
Chọn model chạy trên GPU đặt tại Việt Nam, ví dụ model self-host trên GreenNode MaaS, và xác nhận danh sách sub-processor của provider. Model được phục vụ từ Singapore, Tokyo hay Mỹ đều tính là chuyển dữ liệu xuyên biên giới.
Bước tiếp theo: Thử model trên GreenNode MaaS Playground, hoặc liên hệ sales để trao đổi về dedicated endpoint.
