
1. Giới thiệu
Một agent xử lý qua một cuộc hội thoại dài cần nhiều hơn là câu hỏi mới nhất. Nó có thể cần mục tiêu ban đầu, các ràng buộc đã thống nhất từ trước, một exception do công cụ in ra, hoặc chính xác thay đổi mà nó đã áp dụng. Khi các message và tool output tích lũy dần, việc quyết định agent được "nhìn thấy" những gì trở thành một phần của thiết kế hệ thống.
Bài viết này dùng sre-agent, một sản phẩm AI nội bộ, làm ví dụ cụ thể. Trong cách triển khai được mô tả trong báo cáo, nó quản lý lịch sử bằng micro_compact và auto_compact. Câu hỏi rộng hơn phạm vi của sản phẩm này: làm sao một agent có thể duy trì hội thoại trong khi vẫn giữ được bằng chứng cần thiết để trả lời chính xác?
Chúng ta bắt đầu từ bài toán, xem xét ba cách quản lý ngữ cảnh, rồi mô tả cách so sánh chúng. Ý tưởng cốt lõi là đánh giá những gì còn dùng được sau khi ngữ cảnh bị thu gọn, thay vì mặc nhiên xem một ngữ cảnh nhỏ hơn là thành công.
Trạng thái bằng chứng. Đây là một thiết kế phương pháp và benchmark kèm một phép thăm dò ban đầu. Báo cáo chứa kết quả cho hai case, chưa phải một so sánh hoàn chỉnh. Chiến lược N latest giới thiệu ở đây là một nhánh so sánh (comparison arm) được đề xuất để đánh giá; nó chưa có kết quả đo lường nào.
2. Phát biểu bài toán
2.1 Lịch sử hội thoại và ngữ cảnh của model là hai thứ khác nhau
Ứng dụng có thể giữ lại toàn bộ cuộc hội thoại trong khi chỉ gửi cho model một phần được chọn lọc. Loại bỏ một message khỏi phần được gửi không nhất thiết xóa nó khỏi kho lưu trữ. Tuy nhiên, trừ khi có một cơ chế truy xuất đưa nội dung bị bỏ ra, agent không thể dùng nó trong câu trả lời tiếp theo.
Với một agent dùng công cụ, lịch sử bao gồm message của user và assistant, các tool call có cấu trúc, và tool result. Một log dài có thể chiếm nhiều dung lượng hơn nhiều message ngắn. Vì vậy, một giới hạn tính theo số lượng message chỉ kiểm soát số message, chứ không đảm bảo một ngân sách token.
Ví dụ, đoạn JSON dưới đây minh họa bốn message lịch sử theo định dạng chat-message của OpenAI. Log đã được rút gọn cho dễ đọc.
[
  {"role": "user",
   "content": "Run the tests and explain any failures."},
  {"role": "assistant", "tool_calls": [{
    "id": "call_001", "type": "function",
    "function": {
      "name": "execute_bash",
      "arguments": "{\"command\": \"pytest -q\"}"
    }
  }]},
  {"role": "tool", "tool_call_id": "call_001",
   "content": "[log shortened] ... 1 failed, 49 passed in 8.42s"},
  {"role": "assistant",
   "content": "One test failed. I will inspect the traceback."}
]
Lịch sử này chứa bốn message dù nội dung tool chỉ là một dòng hay một log 10.000 dòng. Mảng tool_calls thuộc về message của assistant, và tool_call_id liên kết kết quả với lời gọi đó. Giữ lại bốn message mới nhất sẽ giữ cả hai phiên bản, dù log dài hơn có thể cần nhiều token hơn rất nhiều. Trường arguments là một chuỗi được mã hóa JSON, đúng như định dạng message này yêu cầu.
2.2 Điều gì có thể biến mất khi ngữ cảnh bị thu gọn
Hãy xét một agent chạy test, thấy một exception, sửa một file, rồi sau đó nhận một câu hỏi tiếp nối. Đoạn trao đổi gần đây có thể giải thích kế hoạch hiện tại, trong khi exception chính xác hoặc lần sửa đầu tiên nằm ở phần sớm hơn nhiều trong lịch sử. Giữ lại các message mới nhất có thể loại bỏ chính bằng chứng đó. Tóm tắt lịch sử có thể giữ được câu chuyện tổng thể nhưng lại làm mất một con số chính xác, một định danh, hay một khối code.
Những mất mát này có hệ quả khác nhau. Một agent có thể xác định đúng file đã thay đổi nhưng lại không tái hiện được đoạn code nó đã chèn vào. Nó có thể nói rằng không rõ số lượng test, hoặc tự tin đưa ra một con số sai. Một phép đánh giá hữu ích phải phân biệt được những kết quả đó và so sánh chúng với một agent vẫn còn nhìn thấy bằng chứng gốc.
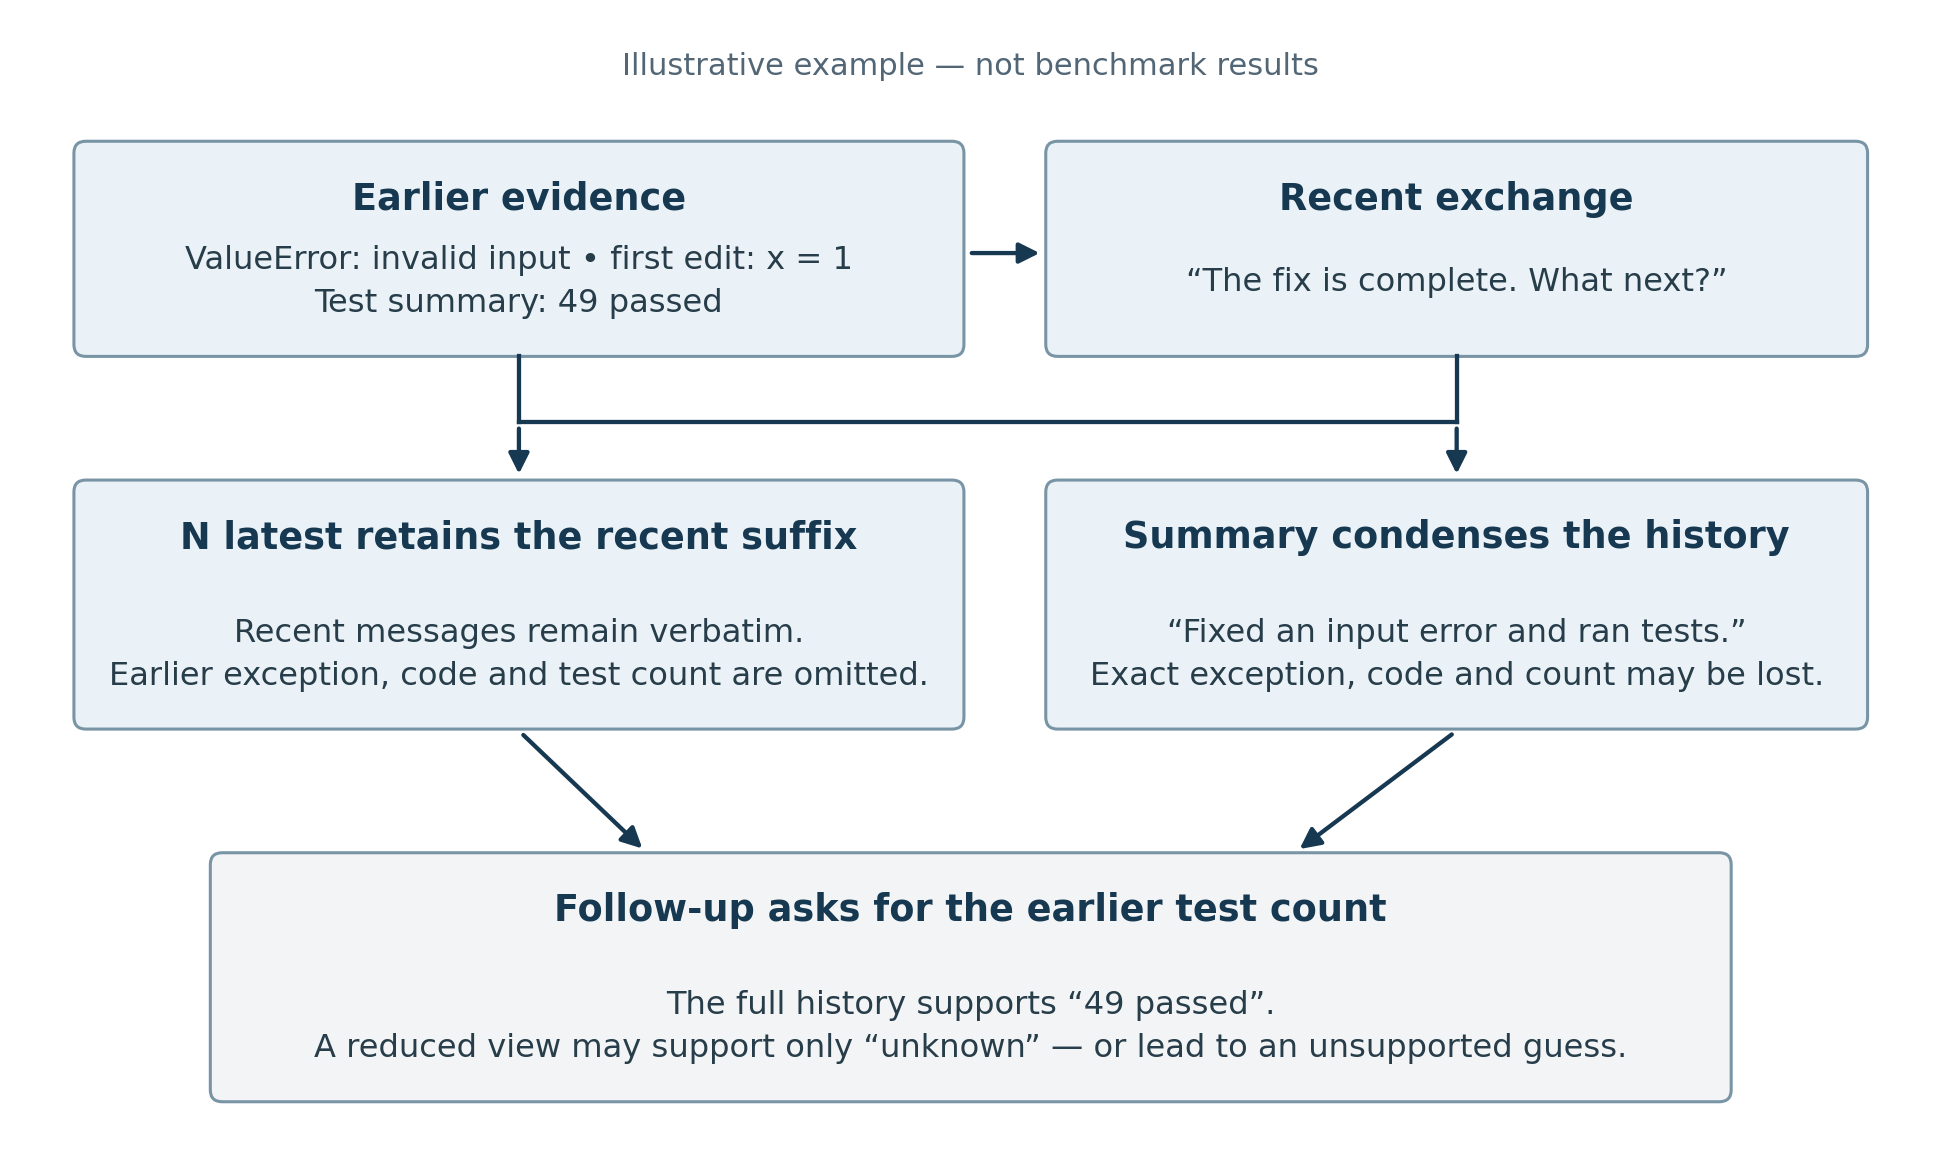
Hình 1. N latest bỏ qua bằng chứng cũ hơn, trong khi một bản tóm tắt có thể làm mất chi tiết chính xác. Đây là ví dụ minh họa, không phải kết quả đo lường.
2.3 Mục tiêu thiết kế
Chúng ta muốn thu gọn ngữ cảnh trong khi vẫn giữ được tác vụ, trạng thái hiện tại, các ràng buộc liên quan và khả năng truy cập bằng chứng chính xác. Các câu hỏi thực tiễn là: giữ nguyên văn (verbatim) cái gì, tóm tắt cái gì, nén (compact) khi nào, và agent có thể khôi phục những chi tiết không còn vừa trong ngữ cảnh hiện hoạt như thế nào.
Phần còn lại của bài viết tách thiết kế cơ chế khỏi kết quả thực nghiệm. Một thiết kế hợp lý là một ứng viên để kiểm thử, chứ không phải bằng chứng rằng vấn đề mất thông tin đã được giải quyết.
3. Các phương pháp quản lý hội thoại dài
3.1 Cách truyền thống với N message mới nhất
Chính sách đơn giản nhất là gửi N message mới nhất và bỏ các message hội thoại cũ hơn ra khỏi ngữ cảnh của agent. Không có bản tóm tắt nào cho phần lịch sử bị bỏ. System instruction và tool schema vẫn có sẵn riêng, và câu hỏi hiện tại của user phải luôn nằm trong input.
Ví dụ, nếu N là 20 và một hội thoại chứa 100 message lịch sử đủ điều kiện, agent nhận được 20 message gần nhất. Một ràng buộc nêu ở message số 5 sẽ không khả dụng trừ khi nó được lặp lại sau đó hoặc được truy xuất một cách tường minh. Chính sách này dễ triển khai và không cần gọi summarizer, nhưng việc mất thông tin cũ bị quyết định bởi vị trí chứ không phải mức độ liên quan.
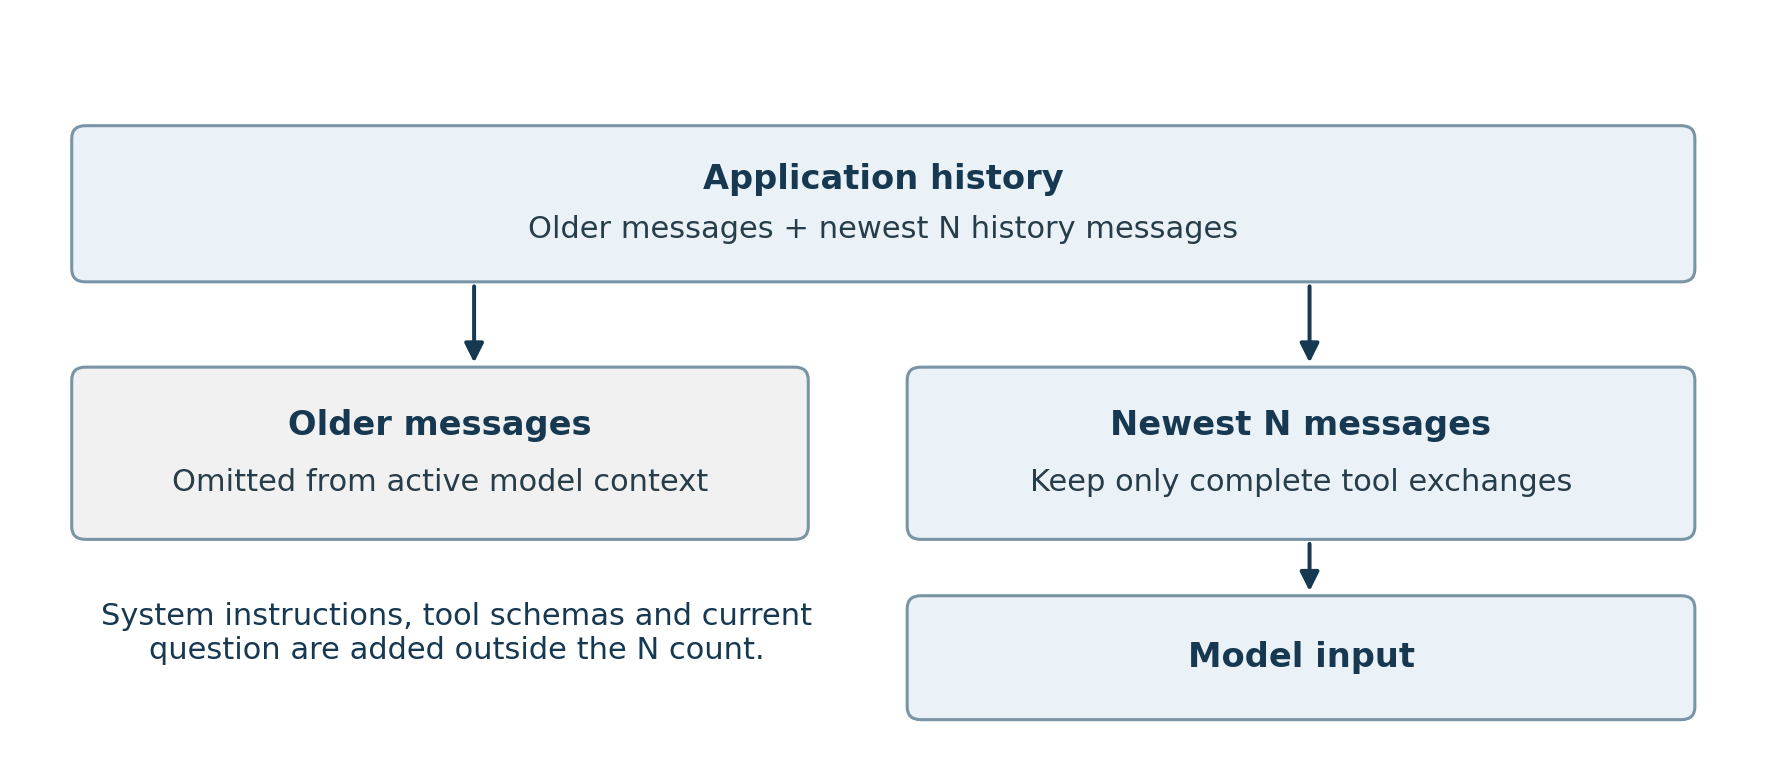
Hình 2. N latest bỏ qua lịch sử cũ mà không tạo bản tóm tắt.
Giao thức công cụ (tool protocol) đòi hỏi thêm một quy tắc. Một lần cắt không được để lại một tool result mà thiếu lời gọi tương ứng, hoặc giữ một lời gọi nhưng loại bỏ một phần của nhóm kết quả của nó. Với nhánh benchmark được đề xuất, N đếm số message lịch sử trước câu hỏi được nối thêm, và ranh giới dịch về phía các message mới hơn để loại trừ mọi trao đổi công cụ chưa hoàn chỉnh. Do đó lịch sử được giữ lại có thể chứa ít hơn N message. System prompt, tool schema và câu hỏi đánh giá nằm ngoài phần đếm này.
Định nghĩa này phải được ghi lại cùng mỗi lần chạy. N message mới nhất, N lượt (turn) mới nhất, và một ngân sách token cố định là ba chính sách khác nhau. Nếu phần đuôi (suffix) được chọn vẫn quá lớn, một cơ chế bảo vệ token có ghi chép rõ ràng phải cắt bớt các trao đổi hoàn chỉnh và báo cáo kích thước thực tế được giữ lại.
3.2 Cơ chế compaction trong ví dụ sre-agent
Cách triển khai sre-agent mô tả trong báo cáo dùng hai cơ chế tại những thời điểm khác nhau. micro_compact thu gọn các tool output cũ hơn trước khi gọi model. auto_compact tóm tắt lịch sử cũ hơn khi ngữ cảnh ước tính vượt một ngưỡng.
micro_compact. Các tool result từ những lượt trước vượt quá 500 ký tự đủ điều kiện để bị thay bằng một placeholder cố định khi chúng nằm ngoài nhóm kết quả mới nhất max(5, số tool result của lượt hiện tại). Điều này giảm lượng văn bản gửi tới model, nhưng nội dung đã bị xóa không thể khôi phục từ placeholder đó trong cơ chế đang được triển khai (shipped).
auto_compact. Khi lịch sử ước tính vượt 0.8 × cửa sổ ngữ cảnh, mọi thứ trước message cuối cùng của user bị thay bằng một bản tóm tắt do LLM tạo ra. Message cuối cùng của user được giữ nguyên văn. Báo cáo mô tả một prompt SRE gồm chín phần để tạo ra bản tóm tắt này.
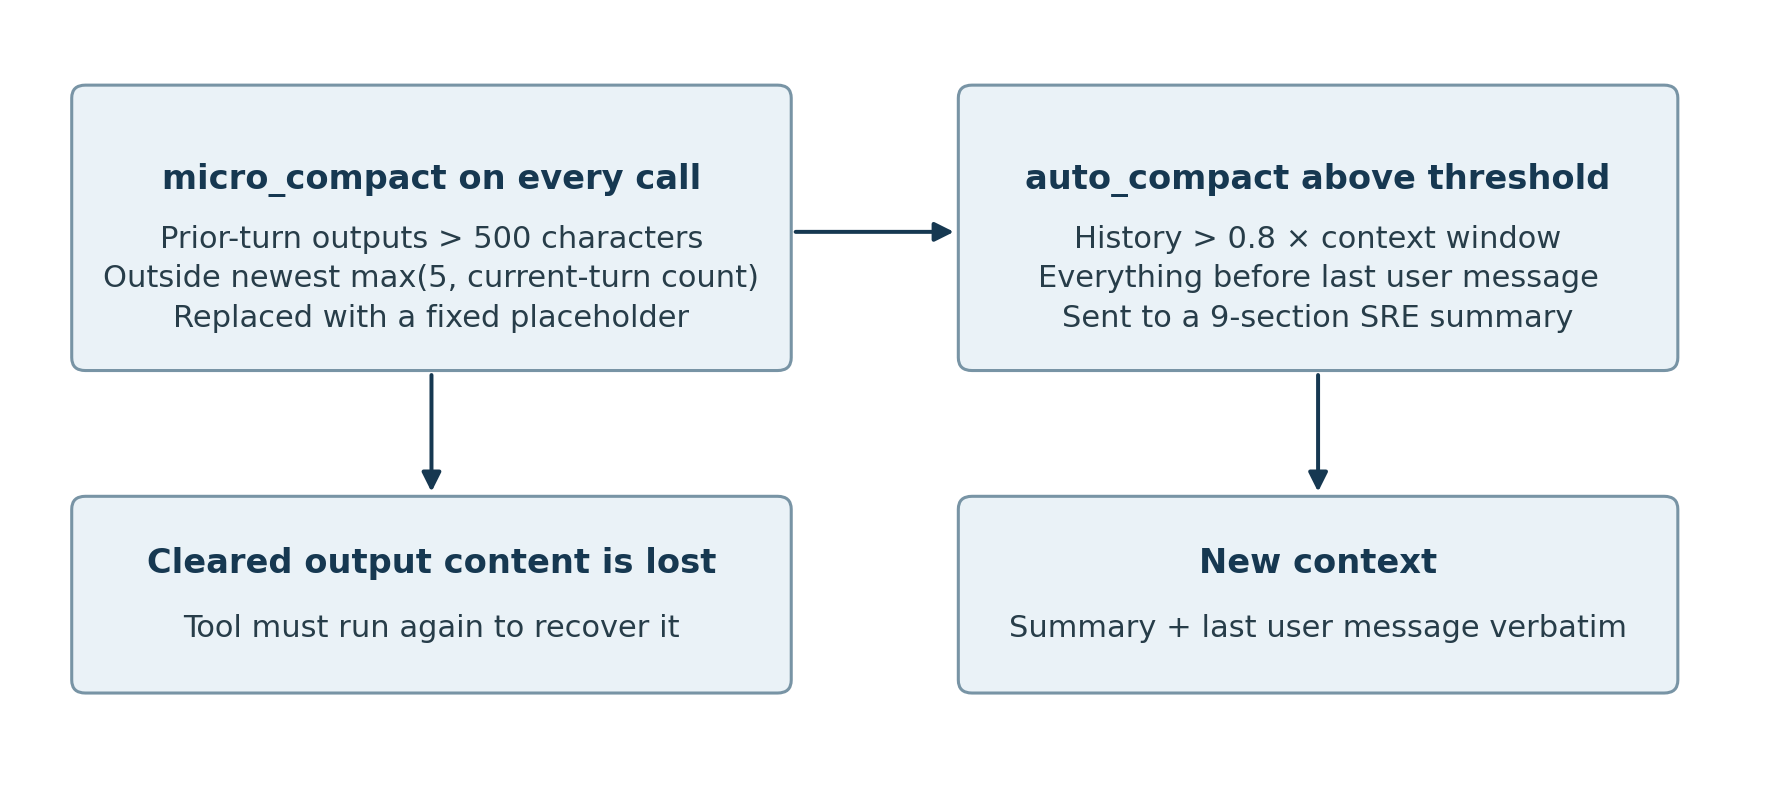
Hình 3. Các cơ chế compaction trong ví dụ sre-agent.
Điều này khác với N latest: một bản tóm tắt có thể mang theo thông tin từ phần rất sớm của hội thoại. Độ bao phủ và độ chính xác của nó vẫn phụ thuộc vào những gì summarizer giữ lại. Báo cáo chỉ ra ba điểm yếu trong thiết lập đang triển khai: chỉ có message cuối cùng của user được đảm bảo giữ nguyên văn sau auto compaction, các tool output đã bị xóa cần một lần chạy công cụ khác để khôi phục, và prompt tóm tắt bao gồm các tài nguyên và công cụ đặc thù cho một dòng sản phẩm.
3.3 Các cải tiến đề xuất cho cơ chế compaction
Benchmark bổ sung các cơ chế tùy chọn để giữ lại phần công việc gần đây và khôi phục bằng chứng chính xác. Đây là các công tắc (switch) thử nghiệm trong benchmark, không phải tính năng đã được xác nhận triển khai trong sre-agent. Chúng nằm trong compaction/config.yml để có thể kiểm thử tác động của từng cái một cách riêng biệt.
Một "retained tail" giữ nguyên văn một phần gần đây của lịch sử thay vì chỉ giữ message cuối của user. Một "step-aware cut" tôn trọng ranh giới của lượt và của trao đổi công cụ. "Offloading" lưu các tool output lớn hoặc đã bị xóa và để lại các handle mà agent có thể mở bằng read_tool_output. Khi đó bản tóm tắt đóng vai trò hướng dẫn tới bằng chứng, chứ không còn là biểu diễn duy nhất còn sót lại của bằng chứng đó.
| Switch | Mục đích |
|---|---|
retain_ratio | Giữ nguyên văn một phần gần đây của lịch sử. |
cut: step | Cắt tại ranh giới nguyên lượt và nguyên bước, đo bằng token; giữ lời gọi đi kèm với kết quả. |
prune_retried_failures | Bỏ các lời gọi thất bại mà một lần retry sau đó đã khắc phục. |
collapse_settled_retries | Rút gọn chuỗi retry đã hoàn tất về bước cuối cùng kèm một ghi chú ngắn; giữ nguyên các chuỗi còn mở. |
offload_tool_outputs | Lưu các output đã bị xóa hoặc đã tóm tắt và giữ lại các handle cho read_tool_output. |
handle_guide: verify | Hướng dẫn agent đối chiếu các giá trị chính xác với output đã lưu và xác định nguồn. |
prompt_paths | Chọn prompt dùng để tóm tắt lịch sử cũ hơn. |
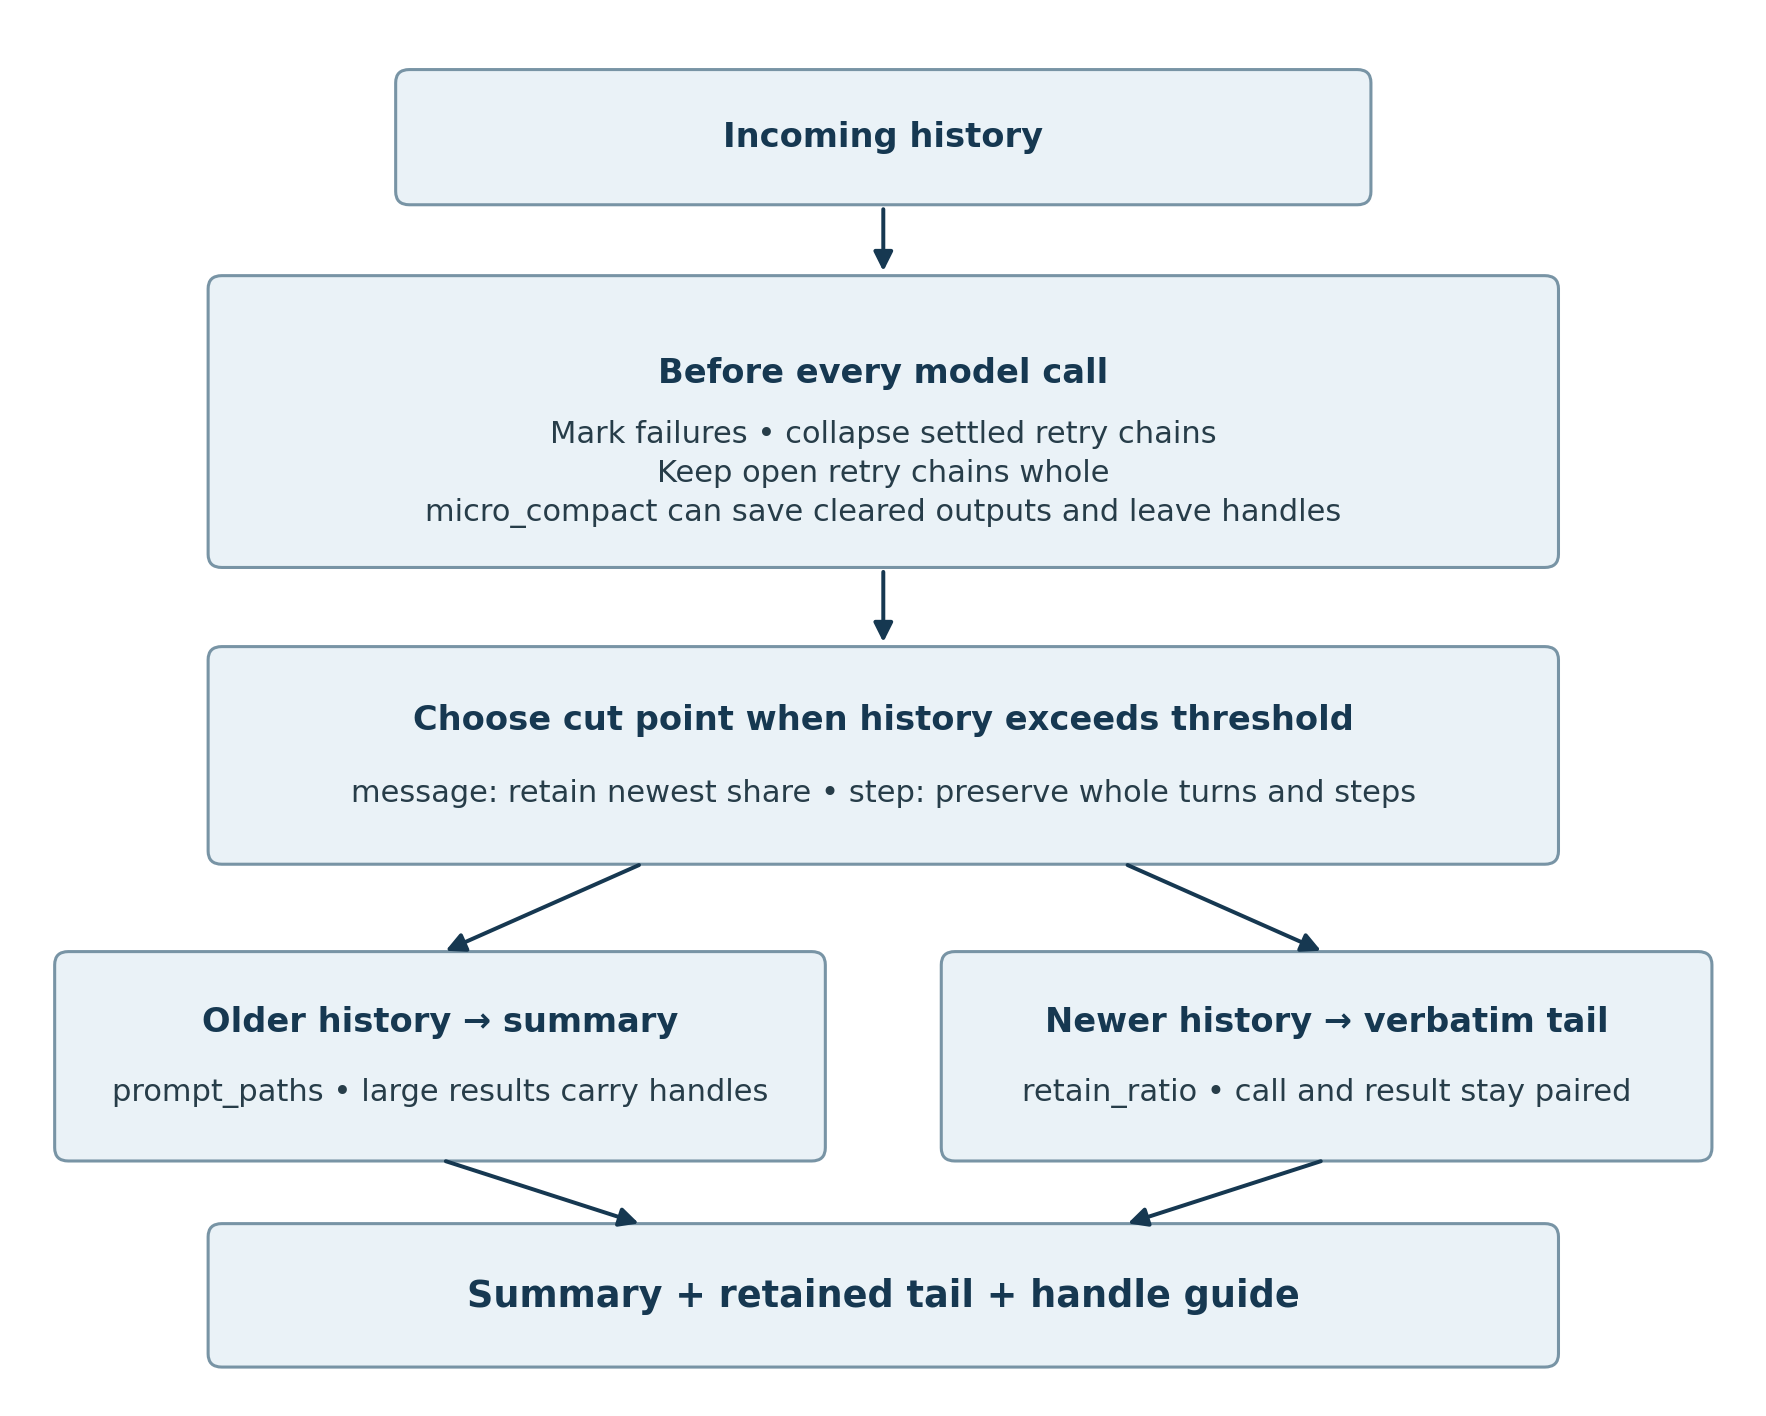
Hình 4. Mô hình compaction với xử lý retry, offloading output, một retained tail và các handle bằng chứng.
Ví dụ dưới đây áp dụng quy trình này cho một hội thoại sửa lỗi. S1 là cây thư mục repository, S2 là output tái hiện lỗi, S3 là lần chạy test đầy đủ đầu tiên, và S4 là phần xem mã nguồn. S5–S7 là các lỗi công cụ; S8 chạy test và báo một assertion thất bại. "Collapse" giữ lại kết quả cuối đó cùng một ghi chú retry. Ở lượt 2, lần cắt giữ nguyên S10 và U2 như những bước trọn vẹn.
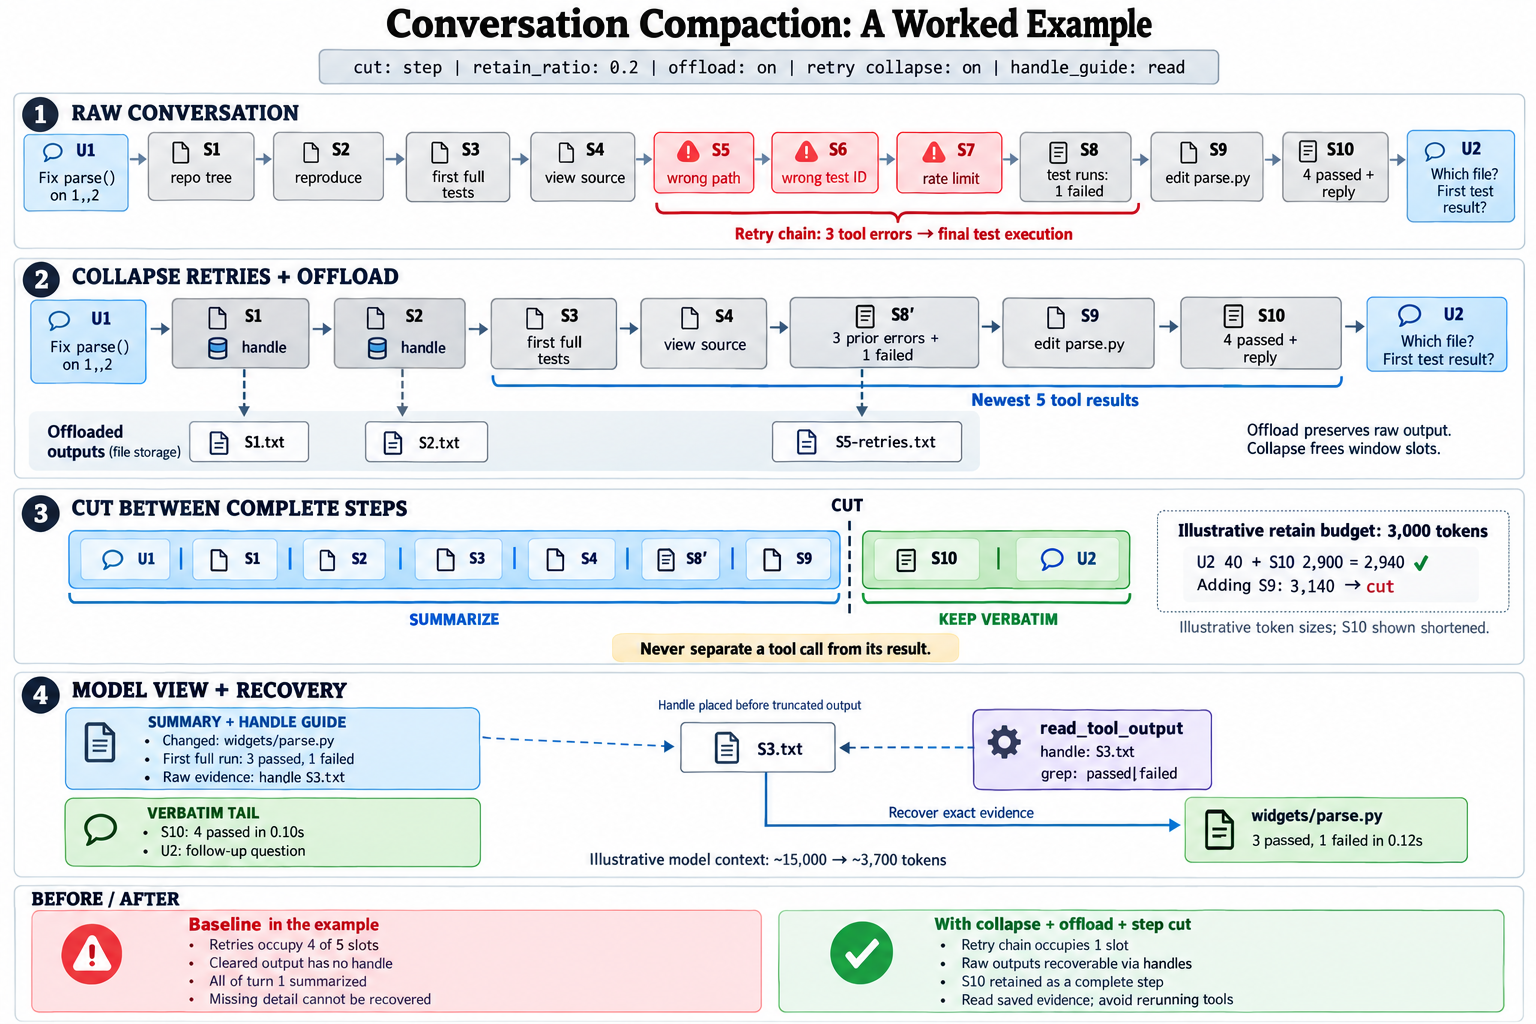
Hình 5. Một ví dụ thực hiện về compaction hội thoại, gồm collapse retry, offloading output, cắt theo bước và khôi phục bằng chứng.
Trong minh họa này, ngân sách retained-tail là 3.000 token và giả định S10 đã được rút ngắn trước đó về 2.900 token. Các kích thước chỉ mang tính minh họa. Output đã lưu vẫn truy cập được qua read_tool_output; một chuỗi retry đang hoạt động được giữ nguyên vẹn.
Các chuỗi retry đã "ngã ngũ" có thể được collapse trong một lượt để các lần thử lặp lại không chiếm chỗ của những kết quả hữu ích trong cửa sổ micro-compaction. Một chuỗi còn đang hoạt động phải được giữ nguyên vẹn. Tương tự, một handle chỉ hữu ích khi output đã được lưu, handle còn tồn tại, và agent thực sự đọc nó.
3.4 Thiết kế prompt
Các thay đổi prompt phải giữ được trạng thái hữu ích mà không cài sẵn các quy tắc nhắm vào những câu hỏi benchmark cụ thể. Báo cáo xem xét bốn họ prompt.
| Prompt | Thông tin mà nó yêu cầu bản tóm tắt giữ lại |
|---|---|
| sre-agent runbook prompt | Chín phần với ví dụ và định danh từ một dòng sản phẩm cloud cụ thể và múi giờ GMT+7. |
| generic | Chín phần không giả định về sản phẩm, công cụ, múi giờ hay tác vụ; giữ các giá trị gắn với chủ thể của chúng, phân biệt các lần chạy lặp lại, và nêu rõ phần chưa biết. |
| hybrid | Các quy tắc giữ/bỏ được tổng quát hóa, định danh và khái niệm then chốt, hướng dẫn tóm tắt một bản tóm tắt đã có, và một phần "Done" tách khỏi công việc hiện tại và các bước tiếp theo. |
| hybrid_v2 | Cấu trúc hybrid cộng thêm phần "Changes Made", ghi lại các thay đổi bên ngoài, đối tượng tác động, thời điểm hành động, và cách hoàn tác thay đổi. |
Một mức cải thiện trên một benchmark coding là chưa đủ để khẳng định một prompt có tính tổng quát. Một thay đổi prompt cần được kiểm chứng trên một nguồn độc lập khác trước khi đưa ra khẳng định đó.
3.5 Các đánh đổi dự kiến trước khi chạy so sánh
| Cách tiếp cận | Model nhận được gì | Đánh đổi chính |
|---|---|---|
| Full history | Lịch sử gốc và câu hỏi hiện tại. | Điều kiện tham chiếu khi toàn bộ input vừa đủ chứa. |
| N latest | Phần đuôi lịch sử gần đây và câu hỏi hiện tại. | Chọn lọc đơn giản; bằng chứng cũ bị bỏ, và số message không cố định được kích thước token. |
| sre-agent compaction | Lịch sử đã micro-compact, rồi một bản tóm tắt và message cuối của user sau auto compaction. | Thông tin sớm có thể còn trong bản tóm tắt, nhưng nội dung tool chính xác có thể bị mất. |
| Compaction variants | Bản tóm tắt, retained tail gần đây, và các handle của output đã lưu khi được bật. | Nhiều cơ chế và bước truy xuất hơn; mức bảo toàn vẫn cần được đo lường. |
Đây là các đánh đổi về thiết kế, không phải một bảng xếp hạng từ các thí nghiệm đã hoàn tất. Phần tiếp theo giới thiệu dataset và cách đánh giá cần thiết để so sánh chúng.
4. So sánh và đánh giá
4.1 Dataset và lý do sử dụng
Báo cáo sử dụng nebius/SWE-rebench-openhands-trajectories trên Hugging Face: các lần chạy của coding-agent OpenHands trên các GitHub issue thực tế trong các repository Python. Các trajectory này chứa tool call có cấu trúc, tool output, patch cuối cùng và kết quả task-test. Nhờ đó có thể dựng các đáp án tham chiếu trực tiếp từ công việc đã được ghi lại, thay vì nhờ một model khác bịa ra.
Revision nguồn được ghim ở 35455389ab51bf5e2306bfd436ef72d0f98bf882. Báo cáo liệt kê 67.074 trajectory và giấy phép CC-BY-4.0. Tên các công cụ gồm execute_bash, str_replace_editor, think, task_tracker và finish. Các trường được dùng là instance_id, repo, resolved, exit_status, model_patch, tools và trajectory.
Các case SRE tổng hợp viết tay bị loại vì đáp án của chúng không thể kiểm chứng với một nguồn độc lập. Báo cáo cũng cân nhắc nebius/SWE-agent-trajectories, nhưng không chọn vì tool call của nó được nhúng dưới dạng văn bản thuần, các lần chạy ngắn hơn, và độ phủ model hẹp hơn.
4.2 Chọn case
compaction.swe.download kiểm tra revision đã ghim, đọc các dòng theo từng trang, và chọn những dòng đầu tiên thỏa các bộ lọc đã cấu hình. Tập con được chọn gồm 20 case từ 20 repository, lấy từ dòng 12 đến 117 của nguồn.
| Bộ lọc | Giá trị | Lý do |
|---|---|---|
| Task đã giải quyết | resolved_only: true | Dùng các lần chạy có patch cuối vượt qua task test. |
| Kích thước lịch sử | 100.000 đến 200.000 ký tự của văn bản và call arguments | Chọn các lịch sử đủ lớn nhưng vẫn vừa trong điều kiện tham chiếu full-history. |
| Số câu hỏi mỗi case | Ít nhất 3 | Đảm bảo mỗi case hỗ trợ nhiều kiểm tra recall. |
| Độ phủ repository | Một trajectory mỗi repository | Tránh đo nhiều biến thể của cùng một dự án. |
| Số case | 20 | Tập con đánh giá cố định. |
Trên toàn tập con, tool call gồm 537 lần execute_bash, 377 lần str_replace_editor, 46 lần think và 12 lần task_tracker. Các repository gồm sunpy, universe, sqlglot, time-machine, structlog, senza, pyserde, dnry-config, autopep8, pint, nose2, claripy, dvc, httpx, streamlink, jsonargparse, sqlfluff, python-tabulate, sepal_ui và faker.
| Đại lượng | Nhỏ nhất | Trung vị | Lớn nhất | Tổng |
|---|---|---|---|---|
| Token ước tính mỗi case | 20.644 | 29.611 | 39.368 | 601.757 |
| Số message mỗi case | 70 | 97 | 160 | — |
| Số tool result mỗi case | 34 | 47 | 79 | — |
4.3 Dựng một benchmark case
Pipeline chuyển các dòng nguồn thành case và tải lên Langfuse để liên kết các lần chạy thí nghiệm.
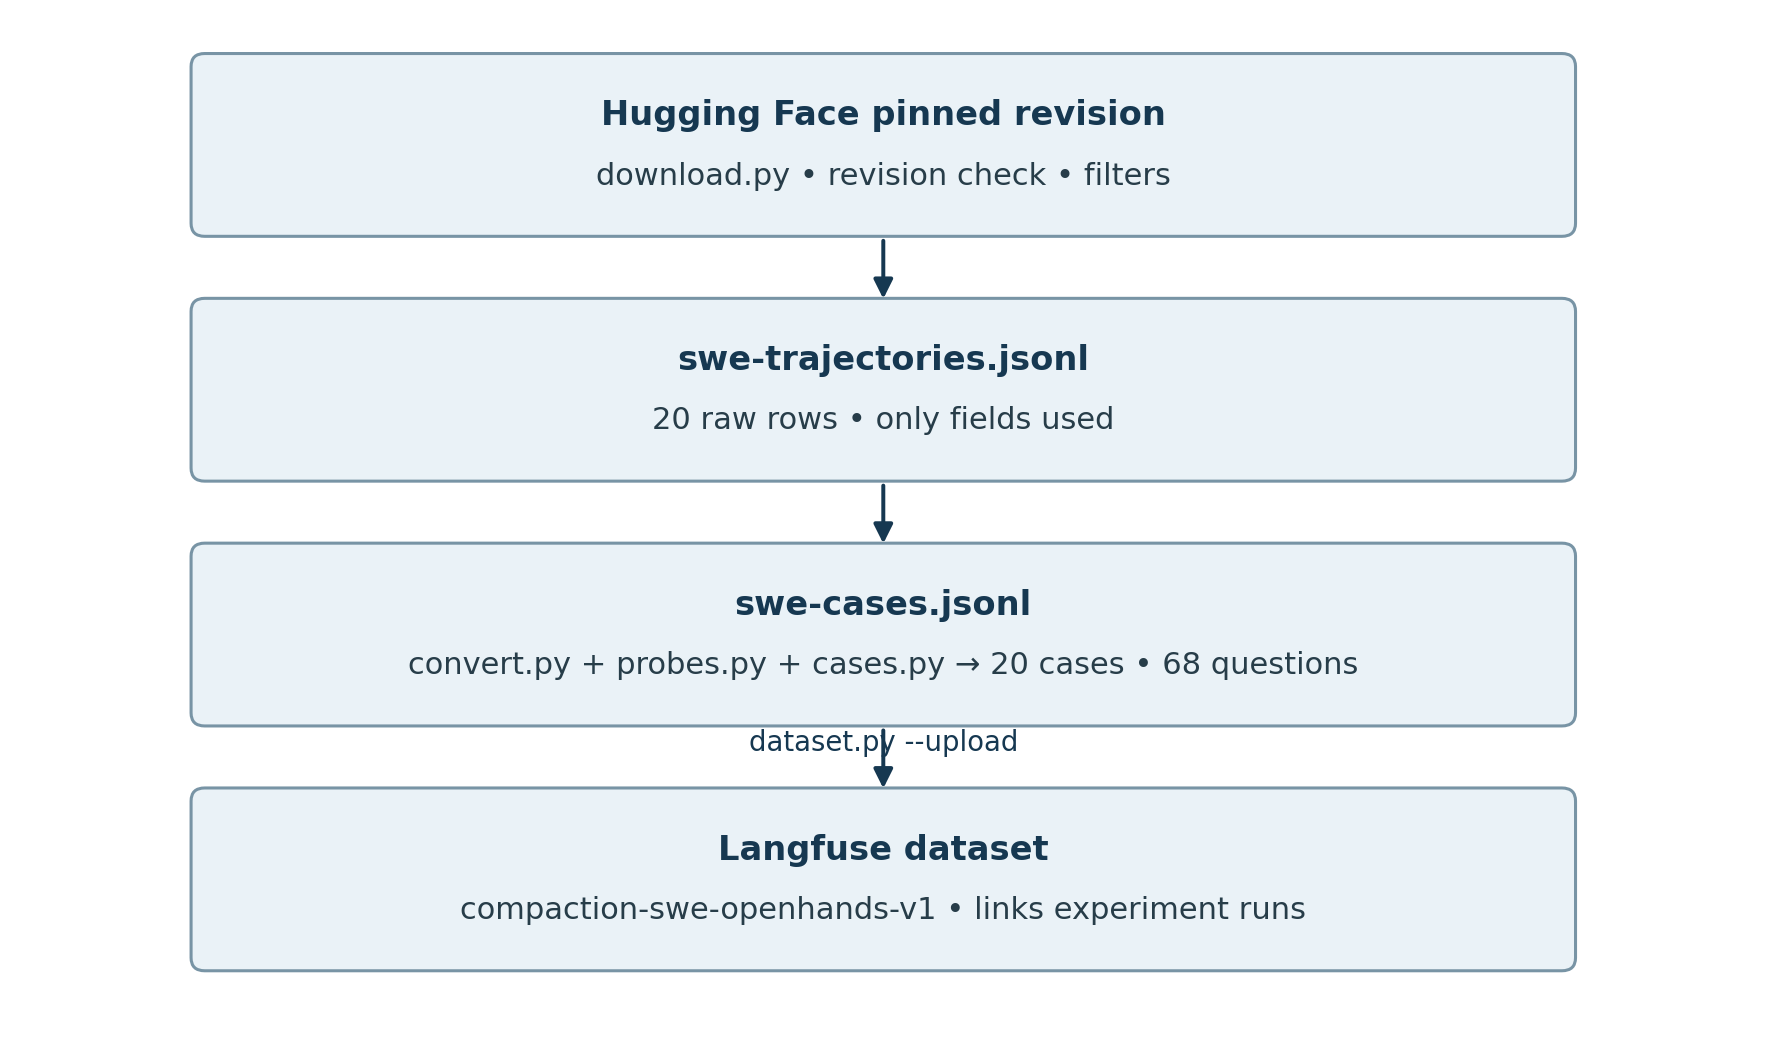
Hình 6. Từ trajectory đã ghi lại đến các benchmark case.
Message hệ thống trở thành Case.system_prompt; message của user trở thành HumanMessage; tool call của assistant trở thành tool call AIMessage với JSON arguments đã được phân tích; phản hồi công cụ trở thành đối tượng ToolMessage kèm tên và tool_call_id. Phần null padding được loại khỏi tool schema để khôi phục các tham số riêng của mỗi công cụ.
Lời gọi finish cuối cùng chưa được trả lời sẽ bị bỏ. Một lời gọi assistant ở cuối mà thiếu kết quả sẽ bị loại cùng với mọi kết quả thuộc các lời gọi khác của nó. Các case vẫn còn lời gọi và kết quả không khớp cặp sẽ bị từ chối.
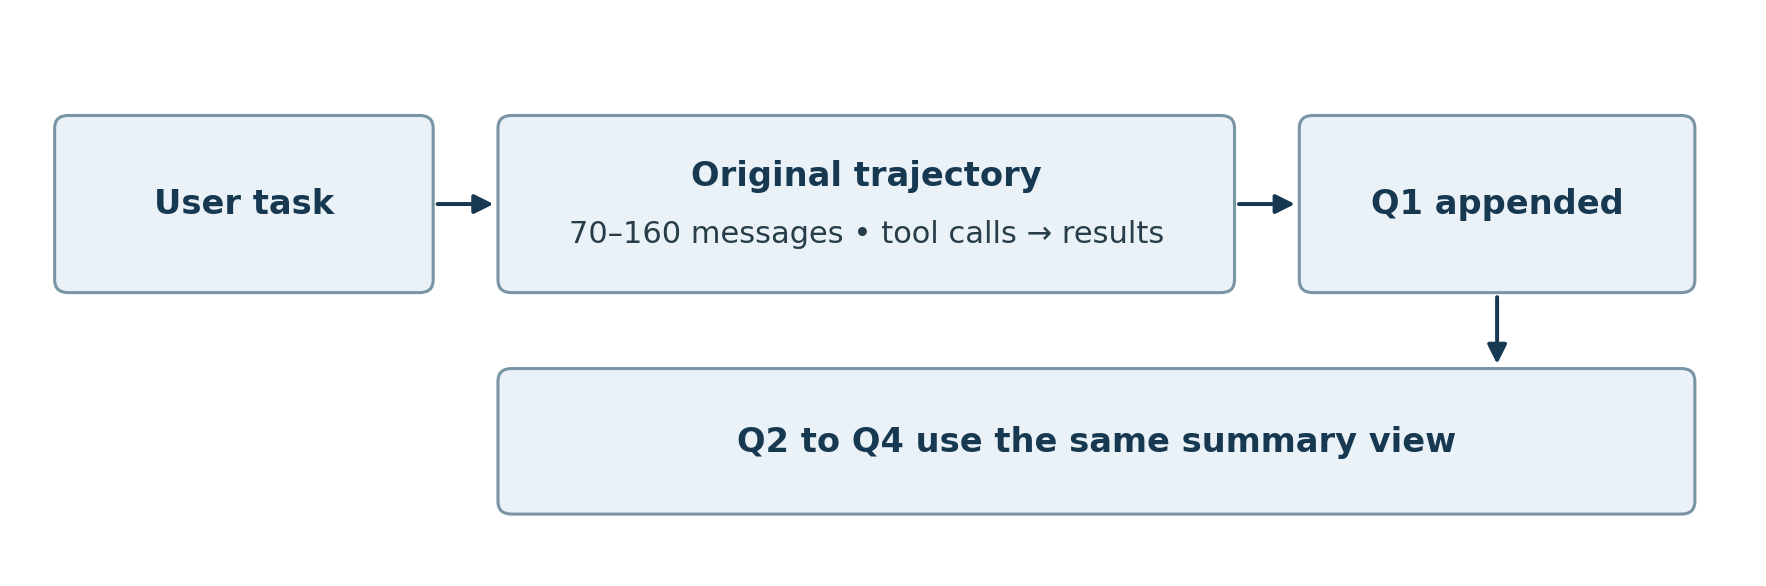
Hình 7. Các câu hỏi dò trên cùng một "history view" đã ghi lại.
Mỗi case nối thêm một câu hỏi vào lần chạy đã ghi. files_changed đóng lại phần lịch sử ban đầu; các câu hỏi sau đó dùng cùng history view đã có sẵn cho câu trả lời đầu tiên. Đáp án của các câu hỏi trước không được trở thành bộ nhớ bổ sung cho các câu hỏi sau.
4.4 Câu hỏi và đáp án tham chiếu
Các case được chọn cung cấp 68 câu hỏi. Đáp án tham chiếu được trích tự động từ trajectory hoặc patch cuối cùng; một LLM không soạn các tham chiếu này. Một model giám khảo (judge) riêng biệt đánh giá các câu trả lời sinh ra so với chúng.
| Loại câu hỏi | Bằng chứng yêu cầu | Nguồn tham chiếu | Số lượng |
|---|---|---|---|
files_changed | Các file hiện có đã bị thay đổi bởi bản fix. | Diff header của model_patch, loại trừ file mới. | 20 |
first_error | Exception in ra bởi một lần chạy lệnh có tên. | Dòng exception cuối của traceback đầu tiên của nó. | 13 |
first_test_summary | Kết quả của một lần chạy test có tên. | Dòng tóm tắt pytest hoặc unittest từ lần chạy đó. | 20 |
first_edit | Đoạn code chính xác được chèn bởi lần sửa đầu tiên của một file đã patch. | new_str từ lời gọi str_replace tương ứng. | 15 |
Các lệnh lặp lại được nhận diện theo số thứ tự lần chạy. Input gửi tới một tiến trình đang chạy, chẳng hạn C-c, không được xem là một lệnh khác. Một lần sửa chỉ được tính nếu nó được áp dụng bên trong repository của tác vụ; nếu không trích dẫn được lần sửa đầu tiên, câu hỏi bị bỏ chứ không thay bằng một lần sửa muộn hơn.
4.5 Các nhánh so sánh và kiểm soát
Benchmark hiện tại so sánh full history với sre-agent compaction và các biến thể có thể cấu hình của nó. Bản chỉnh sửa này bổ sung N latest vào kế hoạch đánh giá. Nó cần được triển khai và chạy mới; báo cáo chưa thiết lập một kết quả N latest nào sẵn có.
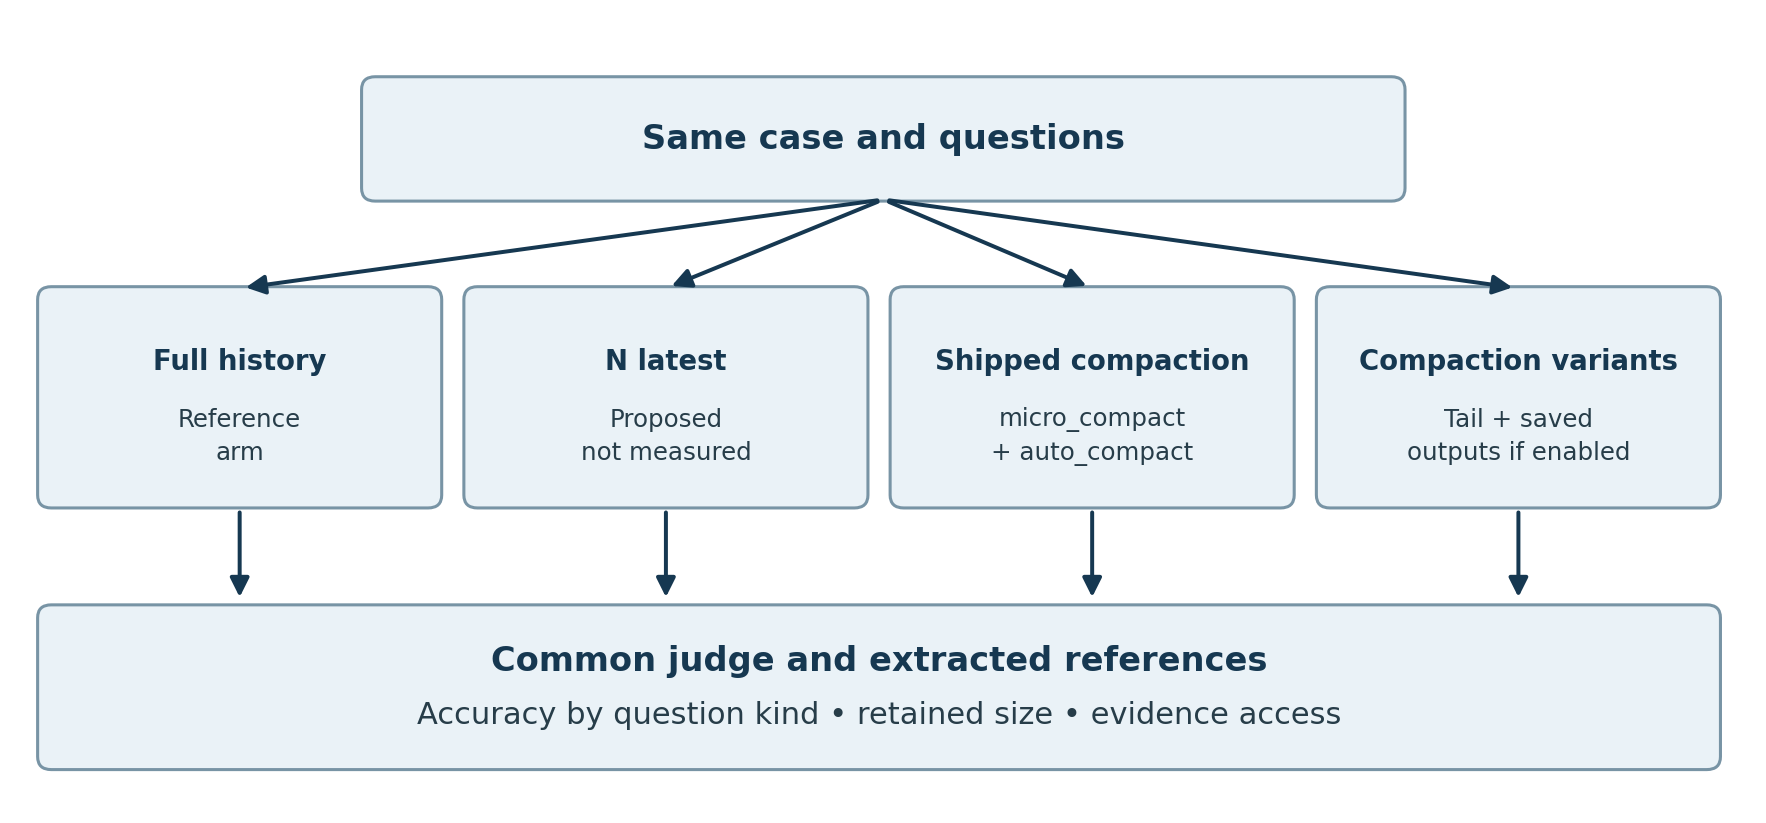
Hình 8. Các nhánh so sánh đề xuất dùng chung case, câu hỏi và tham chiếu.
Với N latest, hãy khai báo trước một dải quét (sweep) chẳng hạn N = 10, 20 và 40 theo định nghĩa đếm-message ở mục 3.1. Đây là các thiết lập đề xuất, không phải cấu hình đã đo. Ghi lại số message và số token thực tế được giữ sau khi cắt theo đúng giao thức. Ngoài dải quét N, hãy so sánh các lần chạy ở các ngân sách token được giữ tương đương, để chất lượng bảo toàn không bị nhầm với việc chỉ đơn giản là giữ nhiều input hơn.
Mỗi nhánh phải nhận cùng case và câu hỏi, dùng cùng model trả lời, và được chấm theo cùng bộ tham chiếu. Với các biến thể offloading, read_tool_output chỉ được truy cập các output đã lưu mà nhánh đó phơi bày. Nhánh N latest không có cơ chế tóm tắt hay truy xuất lịch sử bổ sung nào. Nhánh full-history đóng vai trò điều kiện tham chiếu trong tập con này, không phải một giải pháp production cho các hội thoại dài tùy ý.
Với nhánh đã compact, micro_compact được phát lại từng lời gọi một, đúng như cách lịch sử được giữ bởi checkpointer. Điều này duy trì sự phân biệt giữa việc xóa output trong lúc chạy và việc tóm tắt lịch sử tích lũy sau đó.
Sandbox gốc không khả dụng trong lúc đánh giá. execute_bash, str_replace_editor và task_tracker trả về phản hồi sandbox-shutdown; think xác nhận suy nghĩ; finish cung cấp câu trả lời cuối. Chỉ read_tool_output hoạt động trên bằng chứng đã lưu. Do đó agent trả lời từ history view, bản tóm tắt, retained tail, hoặc các output đã lưu được cho phép, chứ không chạy lại tác vụ gốc.
| Thiết lập theo báo cáo | Giá trị |
|---|---|
| Agent trả lời và summarizer | google/gemma-4-31b-it, temperature 0. |
| Judge | z-ai/glm-5.3, temperature 0; một model khác với agent trả lời. |
| Số lượt model mỗi câu trả lời | Tối đa 25. |
| Ngưỡng compaction lần đầu | 0.8 × kích thước lịch sử ước tính của chính case đó, buộc compaction ở mọi case. |
| Ngưỡng compaction lần sau | 0.8 × 131.072 token. |
| Ước tính token | Số ký tự chia 4, khớp với auto_compact. |
4.6 Chỉ số và cách báo cáo
Kết quả chính là độ đúng của câu trả lời so với nhánh full-history. Một câu hỏi mà nhánh full-history cũng sai không phải là bằng chứng rõ ràng về mất mát do compaction, và cần được xem xét trước khi quy lỗi cho việc thu gọn lịch sử.
| Chỉ số | Diễn giải |
|---|---|
answer_correct | Phán quyết của judge cho một nhánh ngữ cảnh-đã-thu-gọn. |
baseline_answer_correct | Phán quyết của judge cho nhánh tham chiếu full-history. |
answer_gap | Độ đúng full-history trừ độ đúng của nhánh thu gọn; dương nghĩa là độ đúng thấp hơn sau khi thu gọn. |
fact_recall | Tỷ lệ các dữ kiện của case được nêu trong một bản tóm tắt sinh ra. Không áp dụng cho N latest, vốn không sinh bản tóm tắt. |
faithfulness | Liệu một bản tóm tắt có đưa ra các khẳng định không được lịch sử hỗ trợ hay không. Không áp dụng khi không có bản tóm tắt. |
reduction_pct | Phần trăm giảm kích thước ngữ cảnh. |
| Số lần đọc tool và handle | Số lần cố truy xuất lại bằng chứng và mức sử dụng thực tế của các output đã lưu. |
| Kiểm tra cơ chế | compaction_fired, structure_valid và summarizer_calls. N latest cần các kiểm tra riêng về việc cắt và tính hợp lệ của ranh giới. |
Báo cáo độ chính xác tổng thể và độ chính xác theo từng loại câu hỏi. Đặc biệt, first_edit yêu cầu code chính xác và nên được diễn giải tách biệt với recall dữ kiện nói chung. Với N latest, cũng báo cáo xem bằng chứng được yêu cầu có còn tồn tại trong phần đuôi được giữ hay không; điều đó giúp giải thích các thất bại do vị trí.
Các lần chạy được ghi dưới dạng thí nghiệm Langfuse với một trace mỗi case. compaction.rescore chấm lại các câu trả lời đã lưu bằng một judge chung và ghi một dòng kết quả cho mỗi câu hỏi. Các lần chạy tương lai cũng nên ghi lại số token được giữ, số lần gọi summarizer, số lần truy xuất output và độ trễ, để các đánh đổi chất lượng–tài nguyên có thể được xem xét; đây là các bổ sung về báo cáo, không phải kết quả đã có.
4.7 Phép thăm dò ban đầu cho thấy điều gì
Phép thăm dò đã hoàn tất bao gồm hai case, jbradberry__universe-31 và adamchainz__time-machine-433, với tám câu hỏi. Nó dùng cấu hình sre-agent đang triển khai, prompt SRE của nó, và không có output offloading.
| Kết quả | sre-agent compaction | Full history |
|---|---|---|
| Câu trả lời đúng | 4 / 8 | 8 / 8 |
| Số case có compaction kích hoạt | 2 / 2 | Không áp dụng |
| Mức giảm kích thước báo cáo | 97% | Input tham chiếu |
| Loại câu hỏi | Độ chính xác khi compact | Quan sát |
|---|---|---|
files_changed | 2 / 2 | Thông tin file đã thay đổi được giữ lại. |
first_error | 1 / 2 | Một exception biến mất khỏi bản tóm tắt; agent báo là không rõ. |
first_test_summary | 1 / 2 | Một con số biến mất; agent nói 11 test thay vì 49. |
first_edit | 0 / 2 | Code chính xác bị thiếu: một case mất một dòng, case khác chỉ giữ khoảng 2 trong 10 dòng. |
Phép thăm dò cho thấy vì sao chỉ thu gọn thôi là chưa đủ: một mức cắt kích thước 97% được báo cáo lại đi kèm với các câu trả lời bị mất. Tám câu hỏi là quá ít để xếp hạng các phương pháp hay dự đoán hành vi ở production. Không thể suy ra kết quả cho N latest hoặc cấu hình cải tiến đề xuất từ phép thăm dò này.
Một lần chạy lớn hơn tên p-sre-on-swe-1 dừng sau 12/20 case khi tiến trình bị kill. Nó chưa được chấm điểm và không được trình bày như một kết quả đầy đủ.
4.8 Phần so sánh còn phải chạy
| Cấu hình | Độ chính xác trên toàn tập con | Trạng thái bằng chứng hiện tại |
|---|---|---|
| Full history | TBD / 68 | Chỉ mới báo cáo phép thăm dò hai case. |
| N latest với các giá trị N khai báo trước | Chưa đo | Nhánh mới đề xuất; cần triển khai và chạy. |
| sre-agent shipped compaction | TBD / 68 | Chỉ mới có phép thăm dò hai case; lần chạy lớn hơn chưa hoàn tất. |
| Compaction variants | TBD / 68 | Đánh giá từng thay đổi riêng lẻ trước khi chọn một cấu hình. |
Trước hết giữ cố định cơ chế và so sánh các prompt SRE, generic, hybrid và hybrid_v2. Sau đó giữ cố định prompt đã chọn và đánh giá chuỗi cơ chế: hành vi đang triển khai, một retained tail 0.2 với cắt theo message, cắt theo bước, offloading, collapse retry đã ngã ngũ, và hướng dẫn verify. Kế hoạch ablation gốc dùng ba lần chạy cho mỗi cấu hình và báo cáo trung bình cùng khoảng dao động với một judge chung.
Báo cáo ước tính 5 đến 6 triệu input token và 1 đến 1,5 giờ cho mỗi lần chạy 20-case ở mức concurrency 3, bao gồm khoảng 70 lời gọi agent ngữ-cảnh-thu-gọn và 70 lời gọi full-history cùng 20 bản tóm tắt. Mười cấu hình gốc qua ba lần chạy ngụ ý khoảng 30 đến 45 giờ. Thêm một dải quét N latest sẽ tăng ngân sách đó; các lần chạy này không nằm trong ước tính ban đầu. Nhánh full-history giống hệt có thể chạy ba lần và tái sử dụng cho các cấu hình.
4.9 Giới hạn của phép so sánh này
Tập con chứa các lịch sử ước tính khoảng 20k đến 40k token. Chúng thường không chạm đến ngưỡng kích hoạt production đã nêu khoảng 105k token, nên benchmark buộc lần compaction đầu tiên. Nó đo khả năng giữ thông tin dưới điều kiện thu gọn, chứ không phải một hội thoại tự nhiên tăng đến giới hạn.
Tất cả case đều là trajectory coding. Bốn loại câu hỏi kiểm tra recall các chi tiết đã ghi, không phải khả năng agent tiếp tục thành công tác vụ gốc. Cần một nguồn độc lập thứ hai, chẳng hạn trajectory vận hành (operations) hoặc phân tích dữ liệu, để đánh giá khả năng áp dụng rộng hơn.
Thiết lập được báo cáo dùng một model trả lời và một judge, nên các kết luận có thể không chuyển sang các model khác. Các bất đồng của judge nên giữ lại lý do để xem xét. Một chỉ số chuyên biệt cho các câu trả lời sai một cách tự tin chưa được triển khai; ví dụ 11-so-với-49 hiện chỉ thấy được qua kết quả theo từng câu hỏi và lý do của judge.
Hạ tầng cũng giới hạn bằng chứng có được cho đến nay. Langfuse yêu cầu truy cập VPN trong môi trường được báo cáo, và việc export span bị timeout trong lúc chạy. Hãy xác minh cả 20 trace tồn tại trước khi chấm điểm một lần chạy đầy đủ, và chạy lại các case chưa hoàn chỉnh.
5. Góc nhìn khép lại
Giữ một hội thoại dài ở trạng thái dùng được đòi hỏi một chính sách cho cả trạng thái gần đây lẫn bằng chứng cũ. N latest là một điểm khởi đầu đơn giản nhưng loại bỏ hẳn các message cũ. Ví dụ sre-agent cho thấy các bản tóm tắt có thể mang ngữ cảnh sớm tiến về phía trước, đồng thời cũng cho thấy các chi tiết chính xác có thể biến mất. Một retained tail và các output có thể khôi phục mang lại thêm những cơ chế để kiểm thử.
Bằng chứng hiện tại ủng hộ một bước tiếp theo có trọng tâm: hoàn tất phép so sánh có kiểm soát và đo lường phần câu trả lời được giữ song song với mức thu gọn ngữ cảnh. Nó chưa xác định được một cấu hình thắng cuộc hay thiết lập được việc quản lý ngữ cảnh không mất mát.
Phụ lục. Tái hiện benchmark hiện có
Từ agent-compaction-benchmark/, đặt dataset.source: swe và chạy pipeline hiện có bên dưới. Các lệnh này tái hiện quy trình benchmark của báo cáo; chúng không triển khai nhánh N latest mới đề xuất.
uv run python -m compaction.swe.download
uv run python -m compaction.dataset --upload
uv run python -m compaction.run --run-name <name>
uv run python -m compaction.rescore --run <name-prefix> --output results/<file>.json
uv run python -m pytest tests
Báo cáo nguồn ghi nhận 357 test offline. Bản chỉnh sửa bài viết này thay đổi cách trình bày và đề xuất đánh giá; nó không tuyên bố đã chạy lại các test đó hay toàn bộ benchmark.
