
Tháng 6/2026, GreenNode khép lại Q2 với 11 cập nhật trải rộng trên nhiều lớp hạ tầng từ quản lý chi phí, vận hành Kubernetes, kiểm soát truy cập, giám sát cho đến cơ sở dữ liệu. Điểm chung xuyên suốt: giảm thao tác thủ công, mở rộng khả năng quan sát, và cho đội vận hành nhiều quyền kiểm soát hơn trên từng thành phần hệ thống.
Dưới đây là tổng hợp những gì đã ra mắt trong tháng 6.
Billing Cost Explorer: phân tích chi phí đến từng resource
Cost Explorer được nâng cấp đáng kể. Người dùng có thể xem chi tiêu theo bốn mức thời gian: Giờ, Ngày, Tuần, và Tháng; giúp người dùng có thể drill down đến từng Resource ID cụ thể. Ba chế độ xem có sẵn: theo Sản phẩm, theo Loại tài nguyên, và theo Resource ID.
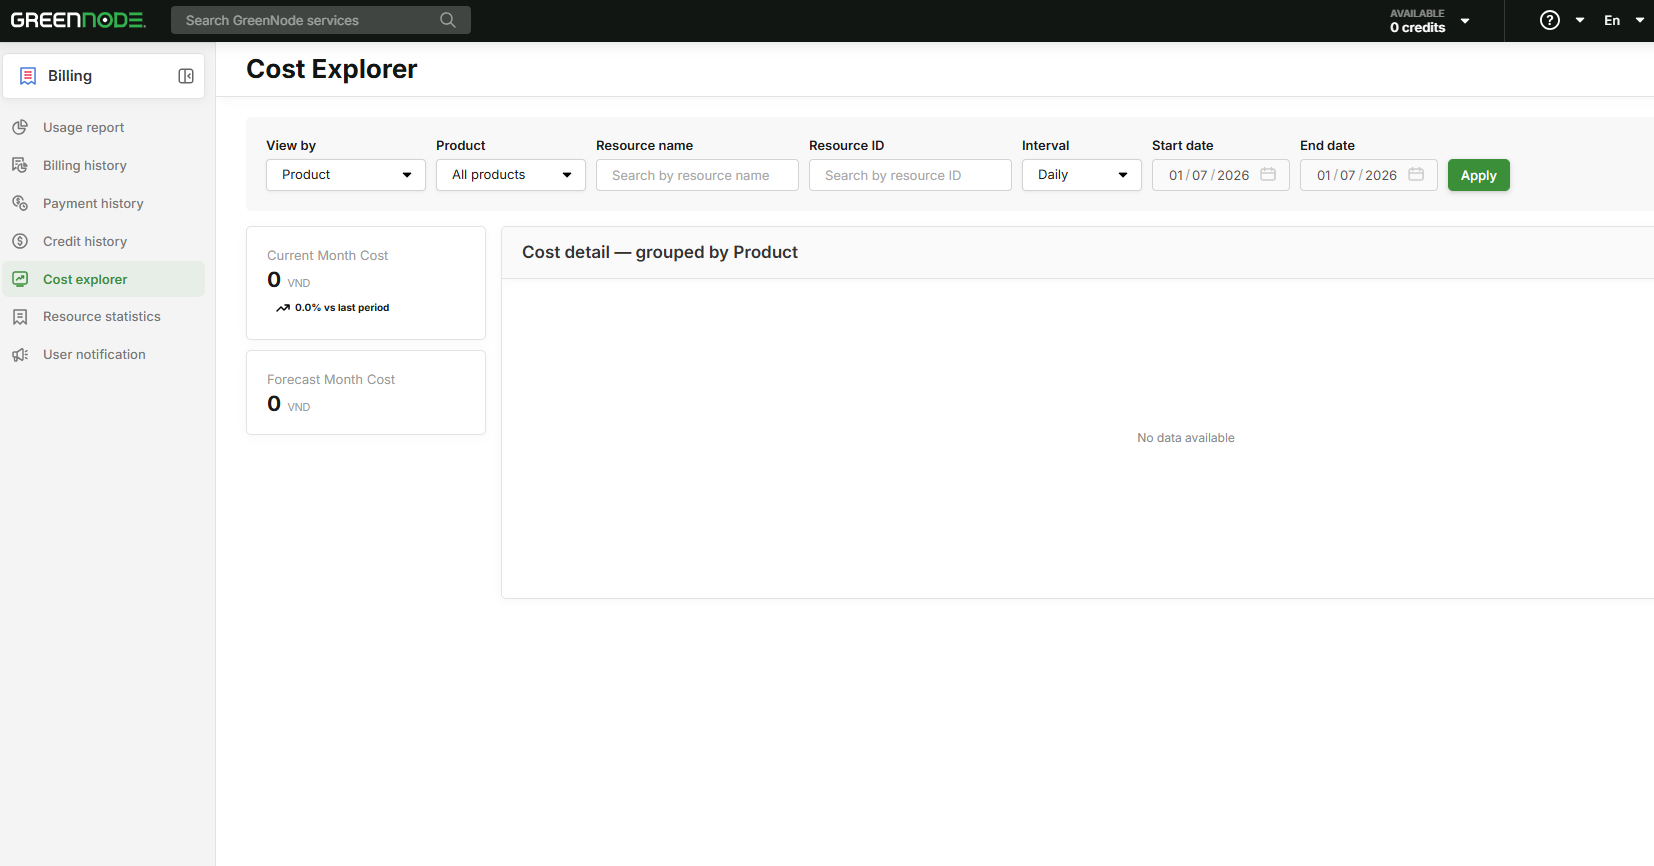
Với các doanh nghiệp vận hành nhiều dịch vụ trên nhiều team, mức độ chi tiết này giúp xác định chính xác resource nào đang phát sinh chi phí và xử lý kịp thời không cần đợi đến cuối tháng mới có báo cáo tổng hợp.
VKS: ba cập nhật giúp cluster Kubernetes tự vận hành tốt hơn
Tháng 6 mang đến ba cải tiến riêng biệt cho VKS, mỗi cái xử lý một lớp khác nhau trong công việc vận hành cluster hằng ngày.
Resource Tag: gắn nhãn server và volume theo Node Group
Người dùng có thể gán nhãn dạng key/value lên toàn bộ Server và Volume thuộc một Node Group. Trong môi trường nhiều cluster, việc gắn nhãn nhất quán giúp phân loại tài nguyên, phân bổ chi phí và thực hiện audit dễ dàng hơn đáng kể.
Auto Healing ở cấp cluster
VKS hiện hỗ trợ cấu hình Auto Healing trực tiếp ở cấp cluster trên Portal. Khi một worker node rơi vào trạng thái unhealthy, hệ thống tự động xóa node đó và tạo node thay thế mà không cần can thiệp thủ công. Trước đây tính năng này phải cấu hình ở cấp Node Pool; cấu hình ở cấp cluster giúp đơn giản hóa setup và đảm bảo hành vi nhất quán trên toàn bộ node group.
Kubeconfig Generator: tùy chỉnh thời hạn certificate và revoke chủ động
Người dùng có thể đặt thời gian hết hạn tùy chỉnh khi tạo file kubeconfig, đồng thời chủ động revoke credential kubeconfig khi cần thu hồi quyền truy cập. Với các team có yêu cầu compliance về vòng đời credential, tính năng này lấp đi khoảng trống trước đây khi thời hạn certificate bị cố định và không thể revoke qua Portal.
Kiểm soát truy cập: chuẩn hóa TLS và whitelist IP cho Portal
Hai cập nhật tháng này siết chặt kiểm soát truy cập ở hai lớp khác nhau: CDN edge và lớp quản trị hệ thống.
vCDN: tùy chọn phiên bản TLS tối thiểu
Khách hàng có thể chọn Minimum TLS Version cho cấu hình CDN trực tiếp trên Portal. Điều này cho phép đội kỹ thuật áp đặt tiêu chuẩn bảo mật kết nối phù hợp với yêu cầu compliance của từng hệ thống dù là PCI-DSS, chính sách nội bộ, hay yêu cầu từ phía client mà không cần thay đổi cấu hình ở origin server.
Bảo mật Portal: whitelist IP đăng nhập
Tổ chức có thể giới hạn danh sách địa chỉ IP được phép đăng nhập vào Portal. Đây là biện pháp kiểm soát đơn giản nhưng thiết thực cho các doanh nghiệp vận hành từ mạng văn phòng cố định hoặc yêu cầu truy cập qua VPN, giảm nguy cơ tấn công dạng credential stuffing mà không tạo thêm ma sát cho người dùng hợp lệ.
Khả dụng từ ngày 01/07/2026.
WAF: báo cáo traffic và request theo khoảng thời gian tùy chọn
WAF hiện hỗ trợ xem và xuất dữ liệu request/traffic theo khoảng thời gian tùy chọn: 7 ngày, 1 tháng, 6 tháng và hơn nữa. Tính năng này hữu ích cho các đợt security audit định kỳ, điều tra sự cố, và phân tích pattern lưu lượng dài hạn khi mức xem theo ngày không đủ chi tiết.
vNetwork NAT Gateway: hỗ trợ High Availability
NAT Gateway nay hỗ trợ High Availability. Cách cấu hình cũng được đơn giản hóa: HA routing được thiết lập ở cấp VPC thay vì trên từng VM riêng lẻ, giúp giảm độ phức tạp khi triển khai và hạn chế nguy cơ cấu hình sai. Luồng traffic ra ngoài không còn là điểm lỗi đơn.
Khả dụng từ ngày 01/07/2026.
vMonitor: mở rộng metric vStorage sang HCM-04 và HAN-02
vMonitor hiện bao phủ vStorage tại hai region mới: HCM-04 và HAN-02. Bộ metric được bổ sung bao gồm traffic, số lượng request, latency và dung lượng lưu trữ theo từng bucket. Với các team vận hành workload trên nhiều region, đây là bước cần thiết để duy trì tính nhất quán trong giám sát trên toàn bộ hệ thống.
vDB: hai cột mốc nổi bật trong một tháng
Tháng 6 mang đến hai cập nhật quan trọng cho vDB: ra mắt kiến trúc HA mới cho Redis và PostgreSQL Cluster chính thức ra mắt người dùng (GA).
Redis Cluster (MemoryStore): High Availability cho Redis production
Redis Cluster trên vDB theo kiến trúc 1 Master / tối đa 9 Replica với đồng bộ liên tục, tự động failover khi master gặp sự cố, và scale Replica không cần downtime. Backup được xử lý qua vBackup với hỗ trợ lịch backup tự động và thủ công, restore thực hiện trực tiếp từ Backup Center. Hỗ trợ Redis 7.x.
Đây là kiến trúc phù hợp cho các workload Redis production khi triển khai single-node không đáp ứng được yêu cầu về tính sẵn sàng.
PostgreSQL Cluster: chính thức GA với hỗ trợ Terraform và migration
PostgreSQL Cluster kết thúc giai đoạn Alpha và chính thức Generally Available. Bản GA bổ sung hỗ trợ Terraform provider và tài liệu cho các use case migration phổ biến nhất: chuyển từ Single sang Cluster, logical replication với minimal downtime, và Change Data Capture sử dụng Debezium.
Với các team đã đánh giá PostgreSQL Cluster trong giai đoạn Alpha hoặc đang lên kế hoạch migration từ single-node, bản GA cung cấp đầy đủ công cụ và tài liệu tham khảo để triển khai.
Cập nhật tài liệu kỹ thuật
- Billing — Cost Explorer
- VKS — Release Notes (Resource Tag, Auto Healing, Kubeconfig Generator)
- vDB — Redis Cluster (MemoryStore)
- vDB — Terraform Provider
- vDB — Migrate Single to Cluster
- vDB — Logical Replication
- vDB — CDC with Debezium
Câu hỏi thường gặp
Nâng cấp Cost Explorer thay đổi gì cho đội tài chính và vận hành?
Thay đổi chính là mức độ chi tiết. Đội vận hành có thể truy vết chi tiêu đến từng Resource ID cụ thể và xem theo giờ, ngày, tuần hoặc tháng, giúp xác định nguyên nhân phát sinh chi phí và xử lý trước khi kết thúc chu kỳ thanh toán.
Auto Healing ở cấp cluster khác gì so với cấu hình ở Node Pool?
Auto Healing cấp cluster áp dụng một cấu hình thống nhất cho toàn bộ cluster, giảm công việc phải cấu hình riêng từng Node Pool. Hành vi vẫn như cũ khiến node unhealthy được tự động thay thế, nhưng setup đơn giản hơn và đảm bảo tính nhất quán trên toàn hệ thống.
Redis Cluster khác gì so với một Redis instance thông thường trên vDB?
Redis instance thông thường chạy trên một node duy nhất, không có automatic failover. Redis Cluster sử dụng kiến trúc master-replica với đồng bộ liên tục, tự động failover và khả năng scale replica không downtime, phù hợp với workload production có yêu cầu cao về tính sẵn sàng.
PostgreSQL Cluster GA hỗ trợ những migration path nào?
Bản GA cung cấp tài liệu cho ba path: chuyển từ Single instance sang Cluster, thiết lập logical replication với minimal downtime, và triển khai Change Data Capture sử dụng Debezium cho các pipeline dữ liệu thời gian thực.
