
Khám phá tầm quan trọng của hệ thống truy xuất tài liệu (document retrieval) trong việc nâng cao hiệu quả của RAG trong mô hình LLM.
Retrieval Augmented Generation (RAG) là một kỹ thuật mạnh mẽ kết hợp thế mạnh của các mô hình ngôn ngữ lớn (LLM) với một cơ sở tri thức bên ngoài để mang lại những phản hồi chính xác và phù hợp với ngữ cảnh. Yếu tố cốt lõi tạo nên hiệu quả của một hệ thống RAG chính là hệ thống truy xuất tài liệu, nơi duy trì một cơ sở dữ liệu thông tin khổng lồ mà LLM có thể truy vấn để trả lời các câu hỏi cụ thể.
Hệ thống truy xuất tài liệu là một phần quan trọng của hệ thống RAG, duy trì một cơ sở dữ liệu thông tin mà LLM có thể truy vấn để trả lời một câu hỏi cụ thể. Nhưng một hệ thống truy xuất tài liệu được tạo ra như thế nào, và một tài liệu được thu nạp vào hệ thống RAG ra sao?
Sau khi đọc xong bài viết này, chúng tôi hy vọng bạn có thể hiểu rõ hơn về RAG và hệ thống truy xuất tài liệu của GreenNode một cách chi tiết.
Retrieval-Augmented Generation (RAG) là gì?
Định nghĩa và kiến trúc
Hãy tưởng tượng bạn đang nói cho một Mô hình Ngôn ngữ Lớn (LLM) mạnh mẽ biết điều bạn cần, đồng thời cung cấp cho nó những sự thật liên quan mà nó chưa từng thấy trước đây. Đó chính là ý tưởng cốt lõi đằng sau RAG: thay vì để mô hình chỉ dựa vào kiến thức được huấn luyện trước (vốn có thể đã lỗi thời hoặc chưa đầy đủ), bạn truy xuất (retrieve) dữ liệu hiện hành, chuyên biệt theo lĩnh vực, và bổ sung (augment) vào prompt của mô hình trước khi nó tạo sinh (generate) câu trả lời.
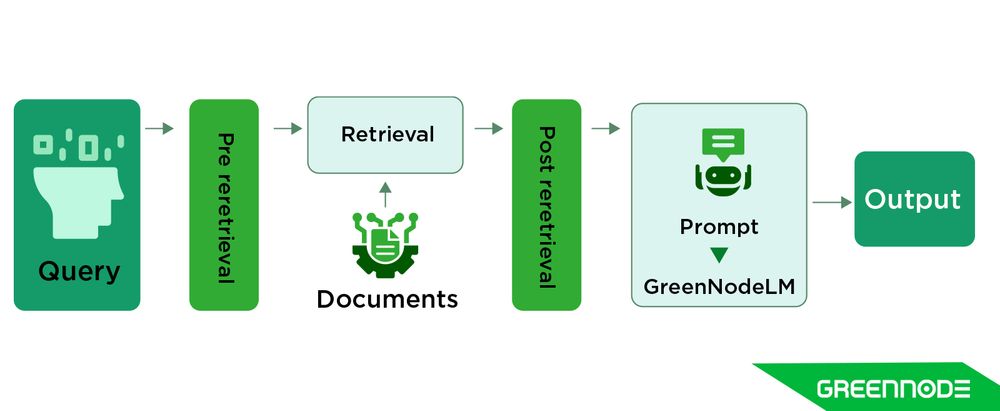
Trong thực tế, một quy trình RAG điển hình diễn ra như sau:
- Retriever (Bộ truy xuất): Dựa trên câu truy vấn của bạn, hệ thống tìm kiếm trong một cơ sở tri thức (tài liệu, vector embedding, dữ liệu doanh nghiệp) và lấy ra ngữ cảnh liên quan.
- Augmentation (Bổ sung): Dữ liệu đã truy xuất được được gắn thêm vào prompt của mô hình hoặc đưa vào theo một cấu trúc nhất định (ví dụ: "Đây là câu hỏi của người dùng + những dữ kiện hỗ trợ sau").
- Generator (Bộ tạo sinh): LLM sử dụng cả kiến thức nội tại của nó lẫn ngữ cảnh mới để tạo ra một phản hồi chính xác hơn, có nhận thức về lĩnh vực, và cập nhật hơn.
Kiến trúc hai phần này (truy xuất + tạo sinh) cho phép bạn giảm thiểu tình trạng "giới hạn kiến thức" (knowledge cutoff) của các LLM tiêu chuẩn và neo giữ các phản hồi vào dữ liệu đáng tin cậy. Đó là lý do vì sao nhiều doanh nghiệp hiện nay coi RAG là mẫu hình lựa chọn hàng đầu cho AI trong môi trường sản xuất.
Lợi ích của RAG đối với AI doanh nghiệp
RAG mang lại nhiều lợi thế đáng kể cho các tổ chức muốn triển khai AI trong môi trường thực tế:
- Cải thiện tính liên quan và độ chính xác: Bằng cách tích hợp thông tin mới và chuyên biệt theo lĩnh vực, RAG giúp giảm hiện tượng ảo giác (hallucination, tức là những câu trả lời bịa đặt hoặc sai lệch) và làm cho các phản hồi có căn cứ vững chắc hơn.
- Kiến thức luôn cập nhật mà không cần huấn luyện lại toàn bộ: Thay vì huấn luyện lại toàn bộ mô hình mỗi khi có dữ liệu mới xuất hiện, bạn chỉ cần cập nhật cơ sở dữ liệu truy xuất để tiết kiệm thời gian, chi phí, và tính toán.
- Khả năng kiểm soát và truy vết cho doanh nghiệp: Vì các tài liệu được truy xuất có thể được trích dẫn hoặc truy vết, doanh nghiệp có được khả năng kiểm toán và kiểm soát tốt hơn, điều quan trọng đối với các lĩnh vực chịu sự quản lý chặt chẽ (tài chính, y tế, pháp lý).
- Tùy chỉnh cho các lĩnh vực cụ thể: RAG cho phép LLM "cắm" tài liệu nội bộ, sổ tay hướng dẫn, hoặc tri thức độc quyền của bạn vào, nghĩa là nó nhanh chóng được điều chỉnh phù hợp với bối cảnh kinh doanh của bạn.
- Nâng cấp hiệu quả về chi phí: Thay vì mở rộng quy mô lên những LLM ngày càng lớn hơn, RAG cho phép bạn tận dụng một mô hình nhỏ hơn kết hợp với một thành phần truy xuất mạnh mẽ, thường mang lại ROI tốt hơn.
Nói ngắn gọn, khi bạn triển khai RAG tốt, bạn biến mô hình tổng quát của mình thành một trợ lý có nhận thức về lĩnh vực với tốc độ, tính liên quan, và độ tin cậy.
Vai trò then chốt của Document Retrieval trong hiệu suất RAG là gì?
Document Retrieval là gì?
Document retrieval (truy xuất tài liệu) là quá trình tìm kiếm và xếp hạng những phần thông tin liên quan nhất (tài liệu, đoạn văn bản, hoặc bản ghi) từ một bộ sưu tập lớn để phản hồi câu truy vấn của người dùng.
Trong các hệ thống Retrieval-Augmented Generation (RAG), document retrieval đóng vai trò cực kỳ quan trọng. Đây chính là phần "retriever" (bộ truy xuất) trong kiến trúc retriever-generator, lấy ra ngữ cảnh hỗ trợ từ một cơ sở tri thức trước khi mô hình ngôn ngữ lớn (LLM) tạo ra câu trả lời.
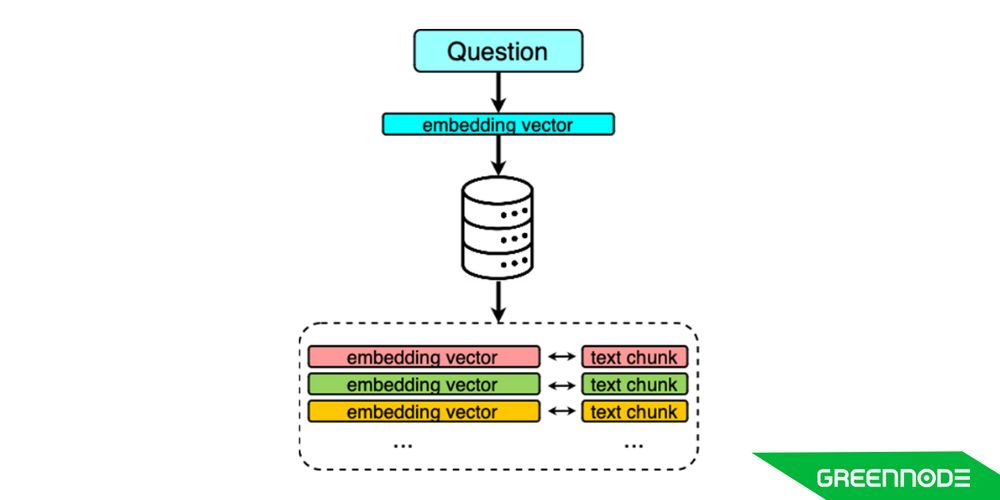
Để truy xuất câu trả lời cho một câu hỏi cụ thể, ở bước đầu tiên, chúng ta phải mã hóa hoặc embedding câu hỏi đó thành các vector embedding. Sau khi có câu hỏi, chúng ta truy xuất những "hàng xóm gần nhất" (nearest neighbors) để đại diện cho vector của câu hỏi. Lợi thế ở đây là chúng ta không thực sự cần truy vấn các từ ngữ hay khái niệm cụ thể, mà chỉ cần ý tưởng chung và truy xuất các vector tương đồng về mặt ngữ nghĩa.
Vì sao document retrieval lại quan trọng?
"RAG là một mô hình lai kết hợp những điều tốt nhất của cả hai thế giới: sự hiểu biết sâu sắc về ngôn ngữ từ LLM và kho tri thức khổng lồ được mã hóa trong các nguồn dữ liệu bên ngoài. Bằng cách tích hợp hai yếu tố này, các chatbot được vận hành bởi RAG có thể mang lại những phản hồi chính xác, liên quan, và có nhận thức về ngữ cảnh cho người dùng."
Cách mạng hóa hội thoại AI với công nghệ RAG tiên tiến của GreenNode
Mọi mô hình LLM nền tảng đều có một khoảng trống kiến thức bị giới hạn bởi dữ liệu huấn luyện của nó. Khi yêu cầu LLM viết về xu hướng mới nhất hoặc thông tin gần đây, LLM sẽ không biết bạn đang nói về điều gì, và phản hồi sẽ được tạo ra từ những ảo giác của mô hình, ở dạng tệ nhất của nó. Vấn đề của LLM xuất phát từ nhiều nguyên nhân then chốt:
- Dữ liệu huấn luyện đã lỗi thời.
- Mô hình có xu hướng suy diễn khi không có đủ dữ kiện (gọi là hiện tượng hallucination).
- Việc huấn luyện LLM rất tốn kém. Theo thống kê từ Hackernoon, GPT-3 của OpenAI với hơn 175 tỷ tham số tiêu tốn hơn 4,6 triệu USD, trong khi BloombergGPT của Bloomberg với 50 tỷ tham số tiêu tốn 2,7 triệu USD.
Nhưng LLM lại rất mạnh mẽ khi tạo ra câu trả lời từ ngữ cảnh mà nó đã có kiến thức (gọi là Zero Shot Learning). Và với các mô hình embedding để tạo ra các cơ sở dữ liệu embedding, chúng ta có thể tận dụng tính linh hoạt của embedding ngữ nghĩa, truy xuất kiến thức liên quan hoặc tùy chỉnh mà chúng ta muốn LLM trả lời. Chi phí để xây dựng một cơ sở dữ liệu embedding tài liệu thấp hơn nhiều so với chi phí để fine-tune một LLM.
Vai trò then chốt của Document Retrieval trong hiệu suất RAG
Nếu Mô hình Ngôn ngữ Lớn (LLM) là bộ não của một hệ thống RAG, thì document retrieval chính là dòng máu của nó, liên tục cung cấp thông tin mới, liên quan để nó "suy nghĩ" cùng. Chất lượng của lớp truy xuất này quyết định trực tiếp liệu mô hình của bạn có tạo ra những câu trả lời chính xác, sâu sắc, đáng tin cậy, hay chỉ là những câu trả lời chung chung và gây hiểu lầm.
Về bản chất, document retrieval đảm nhận ba vai trò then chốt trong việc định hình hiệu suất RAG:
Cung cấp ngữ cảnh liên quan vào đúng thời điểm: Hệ thống truy xuất đảm bảo chỉ những tài liệu liên quan nhất mới được hiển thị cho một câu truy vấn nhất định. Tính liên quan này không chỉ được đo bằng việc khớp từ khóa mà còn bằng sự tương đồng ngữ nghĩa, xác định các đoạn văn bản phù hợp về mặt khái niệm với điều người dùng đang hỏi. Khi được thực hiện tốt, việc truy xuất sẽ giảm tỷ lệ hallucination và giúp đầu ra của mô hình có căn cứ trên kiến thức đã được xác thực.
Đóng vai trò cầu nối tri thức năng động: Khác với một LLM tĩnh, một retriever liên tục lấy dữ liệu từ một cơ sở tri thức đang hoạt động hoặc được cập nhật, chẳng hạn như tài liệu doanh nghiệp, sổ tay kỹ thuật, hoặc tập dữ liệu độc quyền. Điều này có nghĩa là mô hình của bạn có thể luôn cập nhật mà không cần huấn luyện lại. Lớp truy xuất về cơ bản mở rộng bộ nhớ của LLM, giúp nó tiếp cận trí tuệ tập thể của tổ chức bạn theo thời gian thực.
Cân bằng giữa Recall và Precision để đạt độ chính xác: Recall (độ bao phủ) cao đảm bảo bộ truy xuất tìm thấy tất cả các tài liệu có khả năng liên quan; Precision (độ chính xác) cao đảm bảo nó chỉ trả về những gì thực sự quan trọng. Một bộ truy xuất được tối ưu hóa tốt sẽ cân bằng cả hai; quá nhiều recall sẽ khiến mô hình bị ngập trong nhiễu, trong khi quá nhiều precision lại có nguy cơ bỏ sót những dữ kiện quan trọng. Việc tinh chỉnh sự đánh đổi này chính là điều phân biệt một hệ thống RAG cấp sản xuất với một bản mẫu thử nghiệm.
Khi việc truy xuất gặp trục trặc, ngay cả LLM tốt nhất cũng sẽ vấp ngã. Những tài liệu không liên quan hoặc chất lượng thấp sẽ làm mô hình bối rối, làm tăng chi phí token, và làm giảm độ chính xác. Nhưng khi việc truy xuất được thiết kế tốt, tận dụng các mô hình embedding, cơ sở dữ liệu vector, và các thuật toán re-ranking, nó trở thành sức mạnh ẩn giấu nâng tầm RAG từ "công cụ tự động hoàn thành thông minh" lên thành hệ thống suy luận có nhận thức về lĩnh vực.
Các phương pháp Document Retrieval tiên tiến
Hiệu suất của bất kỳ hệ thống RAG nào đều phụ thuộc vào việc nó truy xuất và xếp hạng thông tin liên quan nhất hiệu quả đến đâu để mô hình suy luận. Các phương pháp truyền thống dựa trên từ khóa có tốc độ nhanh nhưng hạn chế trong việc hiểu ngữ cảnh, trong khi các phương pháp dense retrieval mới hơn nắm bắt ý nghĩa sâu sắc hơn, dù thường đòi hỏi chi phí tính toán cao hơn.
Để dung hòa những đánh đổi này, các pipeline RAG hiện đại sử dụng các kiến trúc truy xuất tiên tiến, kết hợp độ chính xác ngôn ngữ với trí tuệ ngữ nghĩa. Hãy cùng phân tích những phương pháp phổ biến và hiệu quả nhất đang vận hành các hệ thống tốt nhất hiện nay.
Dense Retrieval với Embeddings
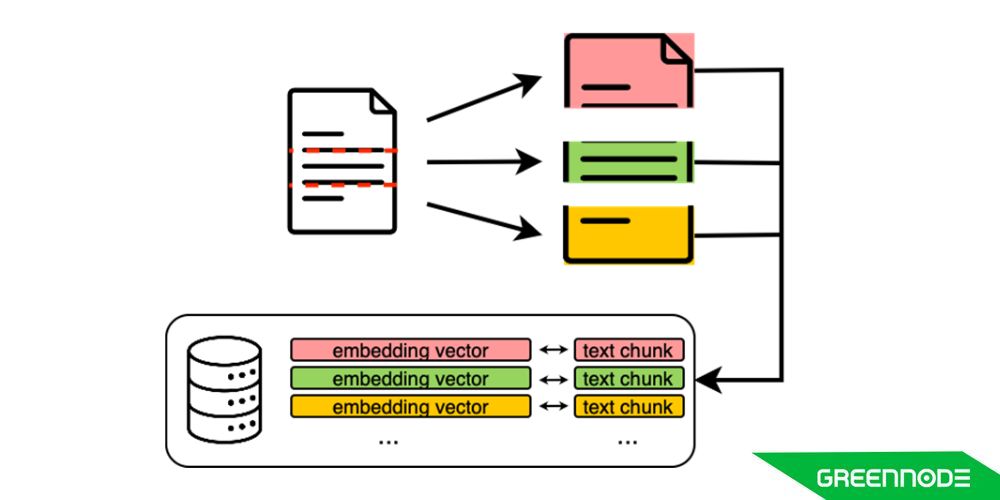
Trong hệ thống RAG của GreenNode, các tài liệu được chia thành các chunk, hay chúng ta có thể coi như các đoạn văn. Sau đó, các chunk sẽ được chuyển đổi thành các vector đa chiều. Trong bài viết này, chúng ta có thể coi mô hình embedding như một hộp đen AI và tập trung vào khái niệm chính của hệ thống document retrieval.
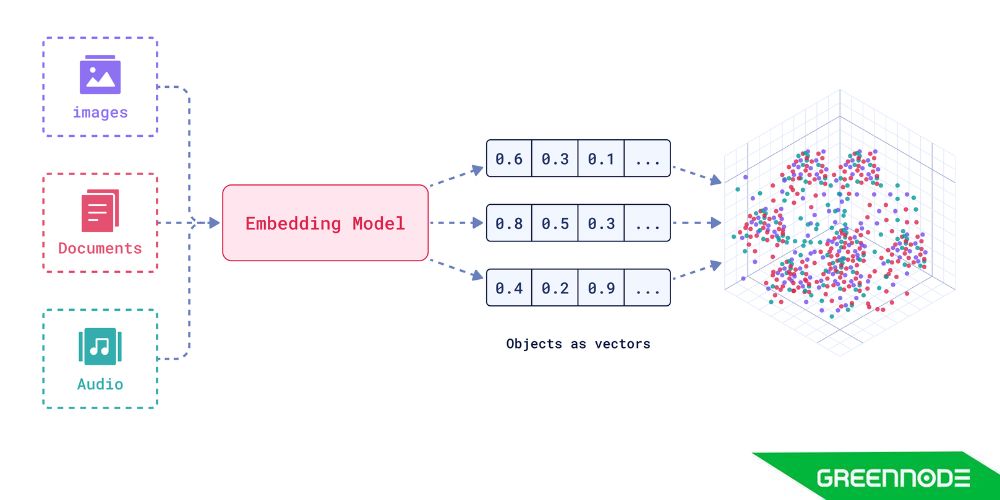
Các vector đa chiều là một cách biểu diễn khác của tài liệu từ góc nhìn ngữ nghĩa. Nhưng tại sao lại như vậy? Trong xử lý ngôn ngữ tự nhiên, sentence embedding đề cập đến việc biểu diễn số học của một câu dưới dạng một vector các số thực, mã hóa thông tin ngữ nghĩa có ý nghĩa.
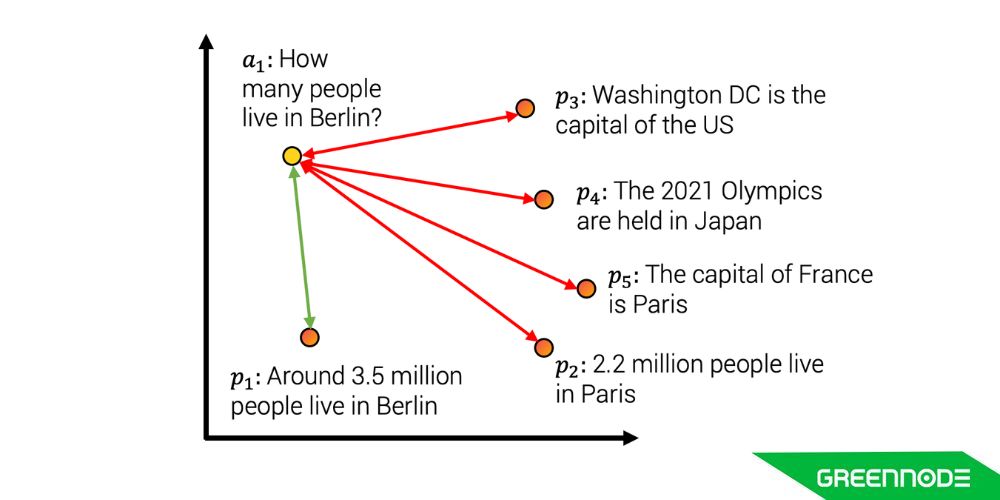
Hình ảnh phía trên biểu diễn một khái niệm ngữ nghĩa trong embedding: a1 là một vector đại diện cho câu hỏi về dân số của Berlin, p1, p2, p3, v.v. là các vector đại diện cho cơ sở dữ liệu thông tin. Một hệ thống embedding tài liệu phải đảm bảo khoảng cách giữa vector câu truy vấn và các vector thông tin liên quan phải gần hơn so với thông tin không liên quan. Trong hình trên, khoảng cách giữa câu hỏi a và đoạn văn p1 nhỏ hơn so với các đoạn khác.
Máy tính không hiểu được ý nghĩa của văn bản, mọi thông tin trong máy tính đều được biểu diễn dưới dạng bit và byte, tín hiệu và số liệu. Trong hệ thống RAG của GreenNode, tài liệu sau khi được chia thành các chunk sẽ được xử lý thành các vector embedding.
Sparse Retrieval (BM25, TF-IDF)
Các phương pháp sparse retrieval như TF-IDF (Term Frequency–Inverse Document Frequency) và BM25 tạo nên nền tảng của tìm kiếm cổ điển. Chúng biểu diễn tài liệu dưới dạng tập hợp các từ rời rạc và xếp hạng kết quả dựa trên tần suất từ khóa và mức độ liên quan của tài liệu.
Dù đơn giản và hiệu quả về mặt tính toán, sparse retrieval tỏa sáng khi xử lý văn bản có cấu trúc hoặc chuyên biệt theo lĩnh vực như tài liệu pháp lý, tóm tắt nghiên cứu, hoặc mã nguồn. Lợi thế chính của nó nằm ở độ chính xác và khả năng giải thích: bạn có thể dễ dàng truy vết lý do vì sao một tài liệu được truy xuất, dựa trên sự trùng khớp từ khóa và điểm số.
Tuy nhiên, sparse retrieval gặp khó khăn khi người dùng diễn đạt câu truy vấn khác với cách dùng từ trong tài liệu, đây là một vấn đề phổ biến trong tìm kiếm bằng ngôn ngữ tự nhiên. Đây chính là lúc các phương pháp dense và hybrid phát huy vai trò.
Các phương pháp Hybrid Retrieval
Hybrid retrieval kết hợp chiều sâu ngữ nghĩa của dense embedding với độ chính xác từ vựng của các phương pháp sparse truyền thống. Trong cách thiết lập này:
- Dense retrieval sử dụng các mô hình embedding (như text-embedding-3-large của OpenAI hoặc GreenMind Embeddings) để biểu diễn văn bản dưới dạng các vector nhiều chiều nắm bắt ý nghĩa ngữ nghĩa.
- Sparse retrieval cung cấp căn cứ dựa trên từ khóa, đảm bảo những sự trùng khớp chính xác quan trọng không bị bỏ sót.
Bằng cách hợp nhất kết quả từ cả hai hệ thống, thường thông qua việc kết hợp điểm số hoặc xếp hạng có trọng số, hybrid retrieval đạt được những điều tốt nhất của cả hai:
- Recall cao từ tìm kiếm ngữ nghĩa, đảm bảo không bỏ sót điều gì quan trọng.
- Precision cao từ việc khớp từ khóa, lọc bỏ nhiễu không liên quan.
Trong các hệ thống RAG cấp sản xuất, hybrid retrieval hiện đã trở thành một thực hành tốt nhất. Nó cân bằng giữa độ chính xác và hiệu quả chi phí, đặc biệt khi xử lý các tập dữ liệu quy mô doanh nghiệp chứa cả bản ghi có cấu trúc lẫn văn bản phi cấu trúc.
Multi-Stage Retrieval
Ngay cả những bộ truy xuất tiên tiến nhất cũng thường trả về một hỗn hợp các tài liệu liên quan và chỉ liên quan một phần. Đây chính là lúc multi-stage retrieval (truy xuất đa giai đoạn) phát huy vai trò.
Trong kiến trúc này, một bộ truy xuất ban đầu (dense hoặc hybrid) trước tiên sẽ lấy ra một tập hợp rộng các tài liệu ứng viên, thường là top 50–100 kết quả khớp nhất. Sau đó, những tài liệu này sẽ được xếp hạng lại (re-ranked) bởi một mô hình cross-encoder mạnh mẽ hơn, đánh giá cặp câu truy vấn-tài liệu một cách đồng thời để chấm điểm mức độ liên quan ngữ nghĩa với độ chính xác cao hơn.
Các cross-encoder, như MiniLM hoặc E5-Large-V2, thực hiện suy luận sâu hơn bằng cách xem xét đồng thời cả token của câu truy vấn lẫn tài liệu. Dù nặng hơn về mặt tính toán, bước xử lý thứ hai này đảm bảo chỉ những tài liệu liên quan nhất mới được đưa đến giai đoạn tạo sinh, dẫn đến:
- Giảm hiện tượng hallucination và các đầu ra không liên quan.
- Giảm mức tiêu thụ token khi prompt LLM.
- Những phản hồi mang tính thực tế và có căn cứ ngữ cảnh hơn.
Kết luận
Document retrieval đóng vai trò then chốt trong hệ thống RAG của GreenNode vì nó duy trì dữ liệu và kiến thức ngữ cảnh để LLM có thể hiểu và trả về câu trả lời một cách chính xác.
Document retrieval trong giải pháp RAG tiên tiến của GreenNode đại diện cho một bước tiến đáng kể trong lĩnh vực AI đàm thoại. Bằng cách ưu tiên độ chính xác, nhận thức về ngữ cảnh, và sự tương tác của người dùng, chúng tôi không chỉ đang tạo ra các chatbot; chúng tôi đang tạo ra những "người trò chuyện" kỹ thuật số, am hiểu, hiệu quả, và trực quan cao. Hãy cùng chúng tôi trên hành trình thú vị này khi chúng tôi tiếp tục định nghĩa lại giới hạn của giao tiếp AI.
