Nếu được hỏi: "Toàn bộ dữ liệu khách hàng đang đi qua bao nhiêu hệ thống AI, và ai đang giữ log của từng hệ thống đó?" bạn có trả lời được trong 5 phút không?
Với hầu hết tổ chức đã triển khai AI theo từng dự án một chatbot tra cứu tài liệu quý trước, một công cụ chấm điểm hồ sơ tháng này, một trợ lý tóm tắt cuộc gọi tuần sau câu trả lời thường là không. Không phải vì thiếu cẩn trọng. Mỗi dự án khi triển khai đều đã được hỏi đúng câu: "dữ liệu có lưu tại Việt Nam không", "nhà cung cấp có uy tín không". Và câu trả lời mỗi lần đều là có.
Nhưng "mỗi công cụ đều ổn" không đồng nghĩa với "toàn bộ hệ thống đều được kiểm soát". Đó là hai câu hỏi khác nhau và khoảng cách giữa chúng chính là nơi rủi ro âm thầm tích lũy: dữ liệu vector từ công cụ này, log truy vấn từ công cụ khác, bản sao lưu của một mô hình đã tinh chỉnh từ công cụ thứ ba tất cả nằm rải rác, không ai có bức tranh đầy đủ, cho đến khi có một cuộc audit, một yêu cầu từ khách hàng lớn, hoặc một sự cố buộc phải trả lời chính xác dữ liệu đang ở đâu.
Đây chính là lý do chủ quyền dữ liệu trong vận hành AI không thể đánh giá ở cấp độ từng công cụ. Nó là thuộc tính của kiến trúc tổng thể cách các lớp hạ tầng, dữ liệu, mô hình và ứng dụng được thiết kế để cùng vận hành với một cơ chế kiểm soát nhất quán, không phải cộng dồn nhiều quyết định "có vẻ ổn" riêng lẻ.
Bài viết này chia sẻ góc nhìn kiến trúc: các lớp cấu thành một nền tảng AI, ai chịu trách nhiệm ở từng lớp, và những câu hỏi cấp quản lý hạ tầng nên đặt ra để có được bức tranh đầy đủ đó trước khi phải trả lời nó trong một tình huống gấp gáp hơn nhiều.
1. Kiến trúc yếu tố quyết định chủ quyền dữ liệu
Quay lại tình huống ở trên: nếu phải trả lời ngay bây giờ "dữ liệu khách hàng đang nằm ở đâu trong toàn bộ hệ thống AI của chúng tôi", nhiều tổ chức sẽ nhận ra câu trả lời không đơn giản như khi đánh giá từng công cụ riêng lẻ. Đó là vì một hệ thống AI vận hành qua nhiều lớp hạ tầng compute, nền tảng dữ liệu, lớp phục vụ mô hình, lớp ứng dụng và mỗi lớp có thể được vận hành bởi các bên khác nhau, ở các phạm vi tài phán khác nhau, kể cả khi phần hạ tầng chính đặt trong nước.
Một điểm hay bị bỏ sót: dù dữ liệu (data plane) đặt trong nước, nhưng nếu lớp điều khiển và giám sát console quản trị, dashboard vận hành, hệ thống metadata lại do một bên ở nước ngoài vận hành, thì khả năng kiểm soát thực tế của tổ chức vẫn bị giới hạn. Đây là lý do vì sao đánh giá chủ quyền dữ liệu cần nhìn vào toàn bộ kiến trúc từng lớp, từng thành phần thay vì chỉ hỏi một câu về vị trí.
Nói cách khác: kiến trúc tốt tạo ra chủ quyền thực chất; vị trí đặt hạ tầng chỉ là một biến số trong kiến trúc đó. Đây cũng là lý do các phần tiếp theo của bài viết đi sâu vào từng lớp cấu thành một nền tảng AI, để cấp quản lý hạ tầng có một bản đồ đầy đủ hơn khi đánh giá hệ thống hiện tại hoặc thiết kế hệ thống mới.
2. Các lớp cấu thành một nền tảng AI
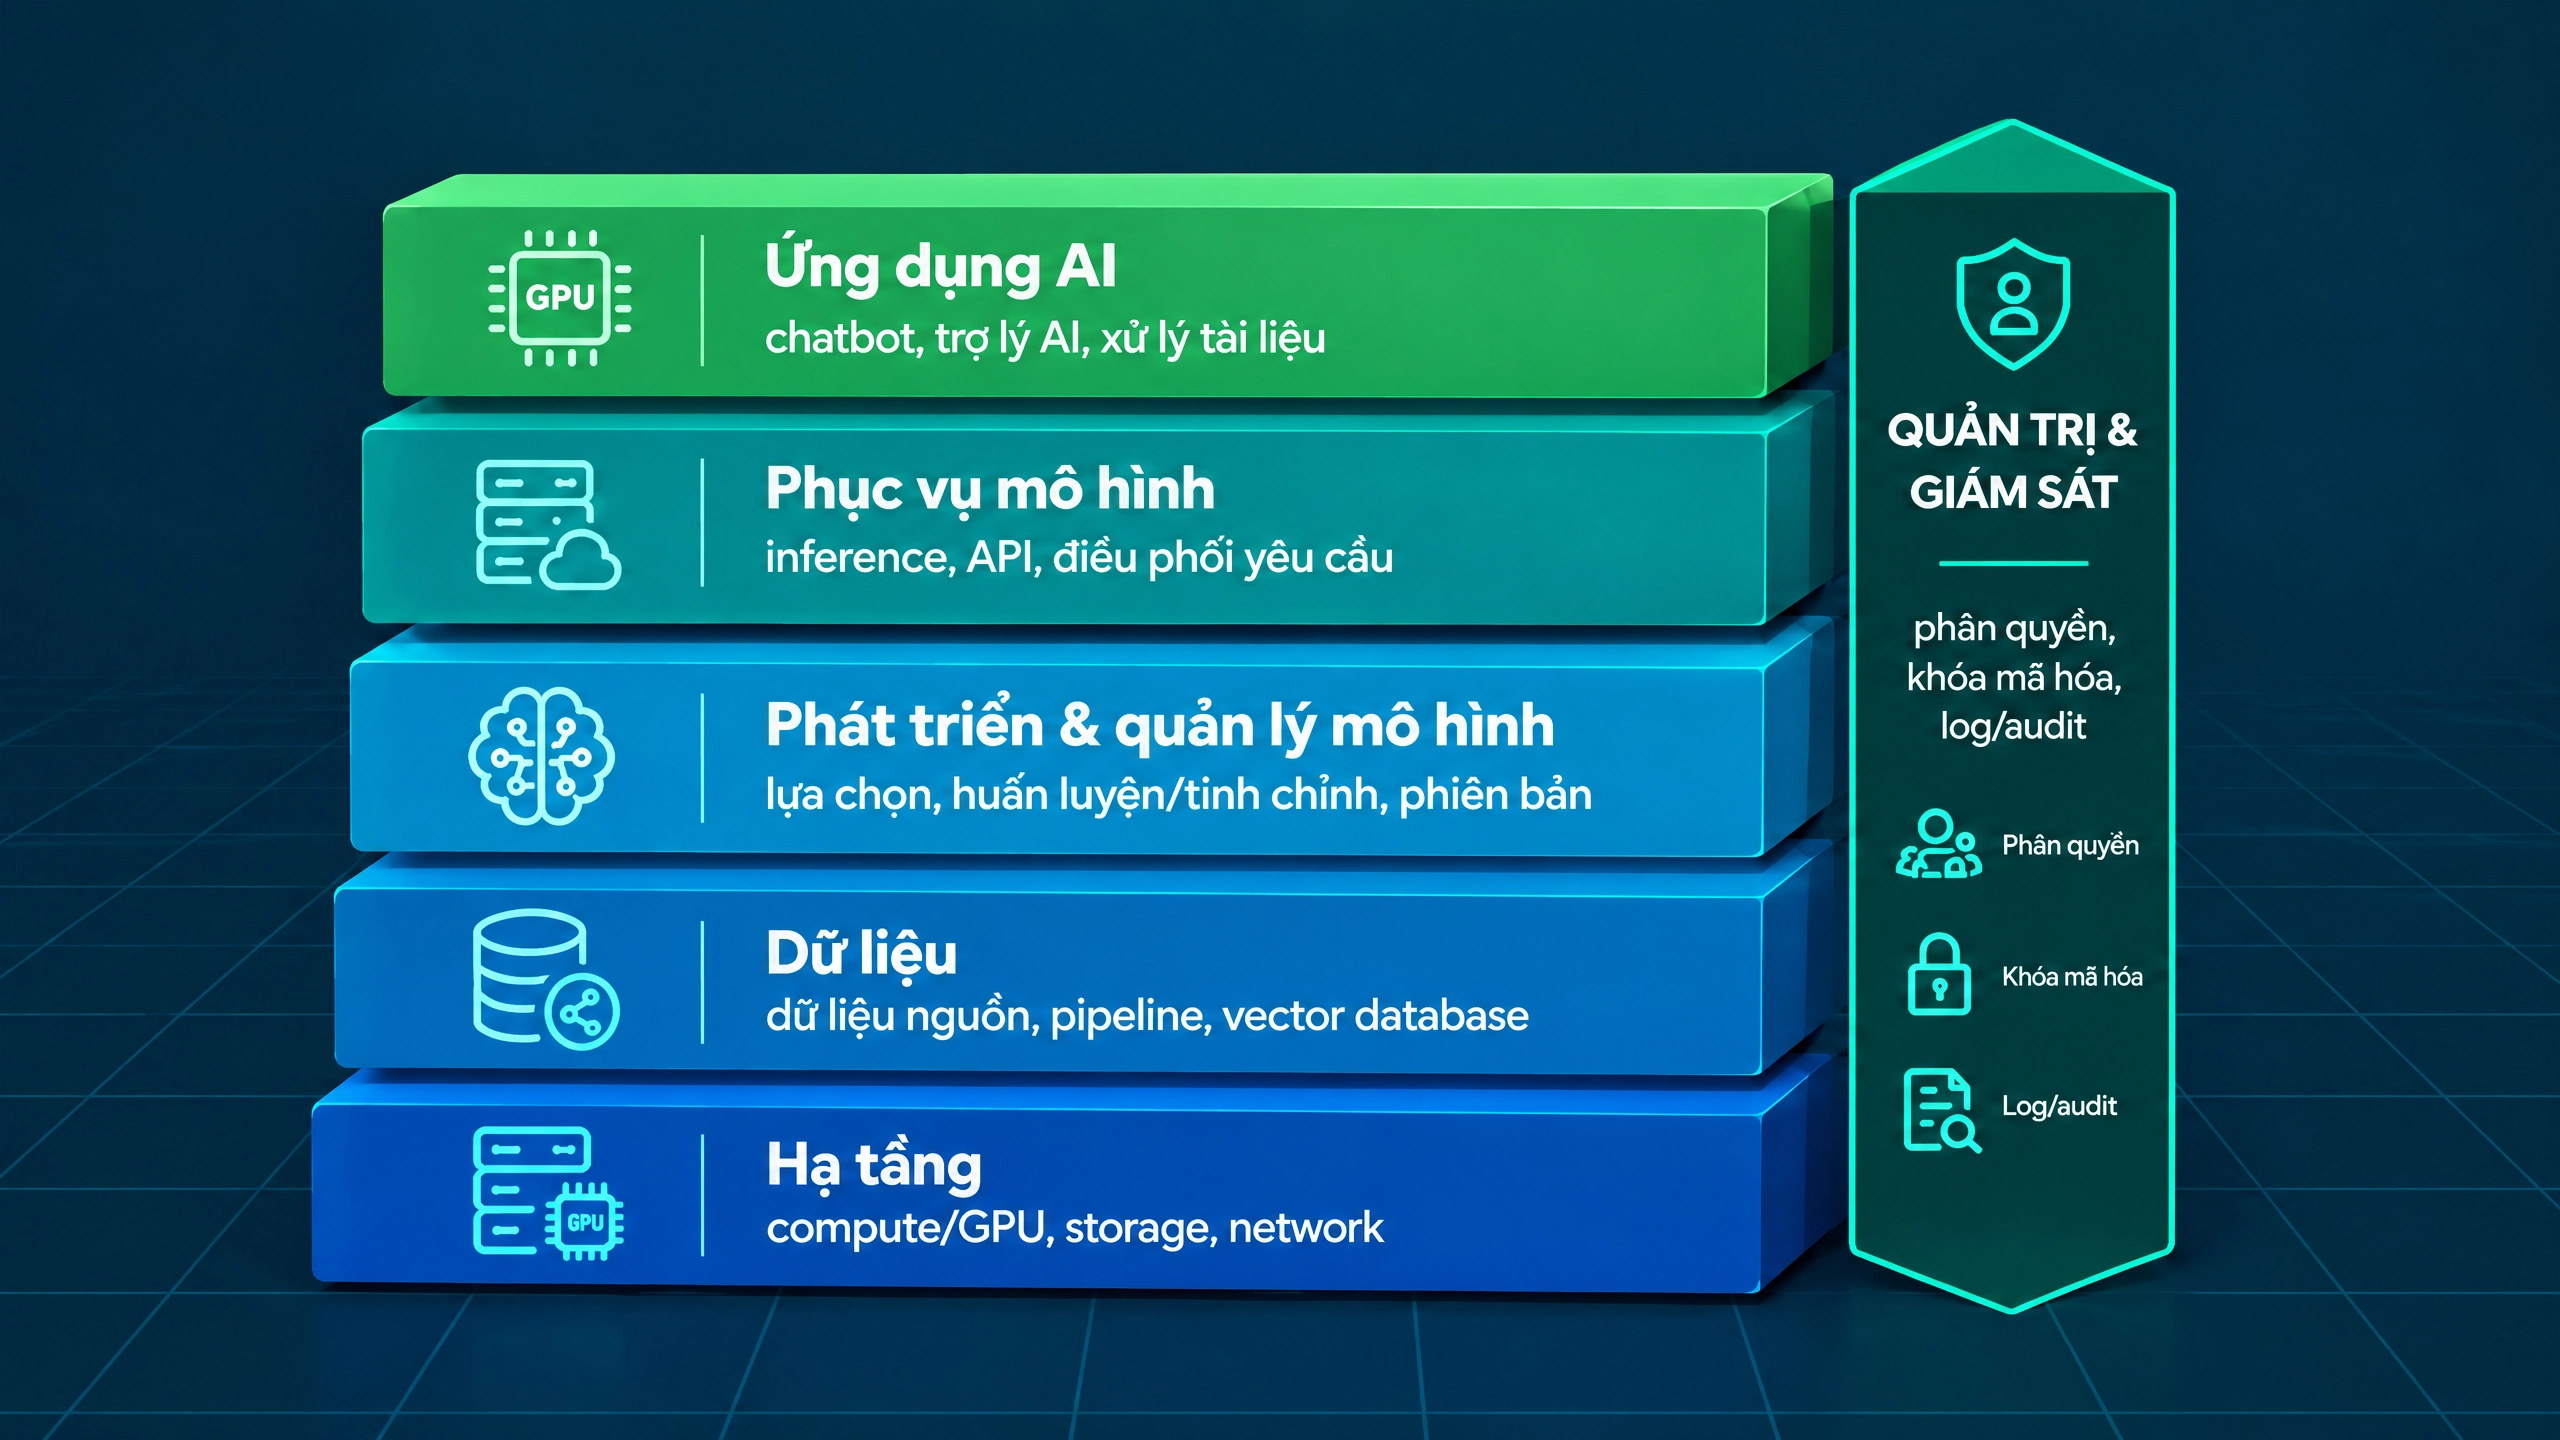
Theo cách phân lớp phổ biến trong ngành hạ tầng AI, một nền tảng AI vận hành đầy đủ gồm năm lớp kỹ thuật xếp từ dưới lên, cộng thêm một lớp giám sát quản trị chạy xuyên suốt cả năm lớp đó:
- Lớp hạ tầng (Infrastructure layer) compute (GPU/CPU), storage vật lý, network. Đây là nền tảng cung cấp năng lực xử lý và lưu trữ cho mọi thứ phía trên, quyết định hiệu năng, khả năng mở rộng và vị trí đặt tài nguyên.
- Lớp dữ liệu (Data layer) nơi dữ liệu được thu thập, lưu trữ (database, data lake), làm sạch và chuẩn hóa trước khi đưa vào mô hình. Với các hệ thống AI có retrieval, đây cũng là nơi dữ liệu vector được lưu trữ.
- Lớp phát triển mô hình (Model development layer) nơi mô hình được lựa chọn, huấn luyện hoặc tinh chỉnh (finetuning) trên dữ liệu của tổ chức. Đây là lớp quyết định ai thực sự đang kiểm soát mô hình: tổ chức có quyền truy cập vào trọng số (weights), quy trình huấn luyện và dữ liệu dùng để tinh chỉnh hay không, hay toàn bộ phần này thuộc về một nhà cung cấp mô hình bên ngoài.
- Lớp triển khai mô hình (Model deployment layer) nơi mô hình đã hoàn thiện được đóng gói và phục vụ các yêu cầu inference thực tế, thường qua API hoặc microservice.
- Lớp ứng dụng (Application layer) nơi mô hình được tích hợp vào hệ thống nghiệp vụ thực tế: chatbot, công cụ chấm điểm tín dụng, trợ lý xử lý hồ sơ đây là lớp người dùng cuối tiếp xúc trực tiếp.
Điểm quan trọng cần lưu ý: lớp phát triển mô hình và lớp triển khai mô hình là hai câu hỏi khác nhau, dù thường bị gộp chung khi đánh giá hạ tầng. Một tổ chức có thể tự host việc phục vụ mô hình (inference) hoàn toàn trong nước đạt yêu cầu về vị trí xử lý ở lớp triển khai nhưng nếu mô hình đang dùng là sản phẩm của một nhà cung cấp nước ngoài mà tổ chức không có quyền truy cập vào trọng số hay quy trình tinh chỉnh, thì phần năng lực "nhận thức" cốt lõi của hệ thống AI vẫn đang phụ thuộc hoàn toàn bên ngoài ở lớp phát triển mô hình. Đây là một dạng chủ quyền bị rò rỉ dễ bị bỏ sót vì nó không nằm ở câu hỏi "dữ liệu ở đâu" mà ở câu hỏi "mô hình thuộc về ai".
3. Lớp quản trị duy nhất: Cơ chế kiểm soát xuyên suốt 5 lớp kỹ thuật
Khác với năm lớp kỹ thuật trên, có một lớp không nằm "trong" kiến trúc mà chạy xuyên suốt toàn bộ hệ thống: lớp giám sát và quản trị (observability & governance layer). Ba thành phần cốt lõi của lớp này, xét từ góc độ chủ quyền dữ liệu, là:
Định danh và phân quyền: ai được truy cập vào tài nguyên nào, ở mức nào, và quyền đó được cấp/thu hồi ra sao.
Quản lý khóa mã hóa: ai giữ khóa mã hóa dữ liệu, và liệu quyền quản lý khóa có được tách biệt khỏi quyền truy cập dữ liệu hay không.
Nhật ký và giám sát: mọi hành động truy cập, thay đổi cấu hình, hoặc xử lý dữ liệu có được ghi nhận đầy đủ và có thể truy xuất lại khi cần không.
Khi lớp quản trị này được thiết kế tốt và áp dụng đồng nhất trên cả năm lớp kỹ thuật, tổ chức có được một hệ thống vừa dễ vận hành vì mọi quyền hạn và hoạt động đều rõ ràng, có thể theo dõi vừa sẵn sàng trả lời bất cứ lúc nào có câu hỏi về việc dữ liệu đang được xử lý ra sao. Đây là nền tảng giúp việc mở rộng quy mô AI diễn ra thuận lợi hơn, vì đội vận hành không phải xây lại cơ chế kiểm soát mỗi khi triển khai một ứng dụng AI mới.
4. Những thành phần lưu giữ dữ liệu lâu nhất nhưng ít được đưa vào phạm vi đánh giá
Khi đánh giá một hệ thống AI, phần được chú ý nhiều nhất thường là dữ liệu đầu vào và mô hình chính. Nhưng có bốn thành phần khác cũng lưu giữ dữ liệu đôi khi trong thời gian dài hơn mà lại dễ bị bỏ ngoài phạm vi đánh giá:
- Nhật ký (logs): log truy vấn, log hệ thống thường được lưu trữ mặc định trong nhiều tháng hoặc nhiều năm để phục vụ vận hành, nhưng ít khi được rà soát về nội dung nhạy cảm có thể xuất hiện trong đó.
- Bản sao lưu (backups): dữ liệu trong backup thường tồn tại lâu hơn dữ liệu gốc và có thể nằm ở một vị trí lưu trữ khác, dễ bị bỏ qua khi rà soát vị trí dữ liệu.
- Cơ sở dữ liệu vector (vector database): dữ liệu đã được chuyển thành embedding phục vụ cho các tác vụ retrieval (ví dụ chatbot tra cứu tài liệu nội bộ) vẫn có thể chứa thông tin có thể suy ra được từ nội dung gốc.
- Mô hình đã tinh chỉnh (finetuned models): nếu mô hình được huấn luyện thêm trên dữ liệu riêng của tổ chức, mô hình đó bản thân nó cũng trở thành một dạng lưu trữ dữ liệu, dù không hiển thị trực quan như một tệp dữ liệu thông thường.
Đưa cả bốn thành phần này vào phạm vi đánh giá hạ tầng cùng với dữ liệu gốc và mô hình chính giúp tổ chức có một bức tranh đầy đủ hơn về việc dữ liệu thực sự đang "sống" ở đâu trong toàn bộ hệ thống, từ đó thiết kế được cơ chế kiểm soát và vòng đời lưu trữ (retention) phù hợp cho từng thành phần.
5. Phân định trách nhiệm giữa doanh nghiệp và nhà cung cấp
Theo khung pháp lý mới về Bảo vệ Dữ liệu Cá nhân (Luật số 91/2025/QH15 và Nghị định 356/2025/NĐ-CP có hiệu lực từ 01/01/2026), ranh giới trách nhiệm pháp lý giữa Bên Kiểm soát Dữ liệu (Data Controller) và Bên Xử lý Dữ liệu (Data Processor) được phân định rõ ràng theo từng mô hình dịch vụ kỹ thuật
| STT | Mô hình dịch vụ sử dụng | Vai trò GreenNode | Vai trò doanh nghiệp |
| 1 | Doanh nghiệp tự triển khai và vận hành ứng dụng trên hạ tầng GreenNode (vServer, vStorage, vDB, VKS) | Data Processor - cung cấp hạ tầng kỹ thuật cho lưu trữ, truyền dẫn và vận hành dữ liệu theo cấu hình doanh nghiệp thiết lập; không quyết định mục đích xử lý. | Data Controller - quyết định mục đích, phạm vi, loại dữ liệu, thời hạn lưu trữ; cấu hình dịch vụ và ban hành chỉ thị xử lý. |
| 2 | Doanh nghiệp gọi API mô hình có sẵn qua MaaS, làn chủ quyền | Data Processor với phần xử lý qua mô hình, thực hiện suy luận trên dữ liệu gửi vào theo chỉ dẫn và mục đích doanh nghiệp xác định. | Data Controller - chịu trách nhiệm dùng dữ liệu nào cho mục đích gì, và cách kết quả mô hình được dùng trong quyết định kinh doanh. |
| 3 | Doanh nghiệp gọi mô hình quốc tế qua MaaS, làn gateway | Data Processor với phần truyền dẫn, định tuyến, log và kiểm soát; nhà cung cấp mô hình là một sub-processor được công bố. | Data Controller - quyết định dữ liệu nào được phép đi qua làn này, và ghi nhận luồng chuyển dữ liệu xuyên biên giới theo quy định. |
| 4 | Doanh nghiệp huấn luyện hoặc tinh chỉnh mô hình riêng trên AI Platform | Data Processor - cung cấp compute, lưu trữ dataset và công cụ theo dõi vòng đời mô hình trong tenant của doanh nghiệp; không truy cập dataset ngoài phạm vi vận hành kỹ thuật. | Data Controller - chịu trách nhiệm cơ sở pháp lý và sự đồng ý cho dữ liệu đưa vào huấn luyện, cùng cơ chế thu hồi đồng ý. |
| 5 | Doanh nghiệp dùng AgentBase nối agent vào hệ thống nội bộ | Data Processor - cung cấp runtime, identity, memory, gateway và policy; ranh giới truy cập do doanh nghiệp khai báo trong Policy Group. | Data Controller - quyết định agent nào được chạm hệ thống và dữ liệu nào, ngưỡng nào cần con người phúc tra. |
| 6 | GreenNode làm nhà thầu phụ cho đối tác | Sub-processor - chỉ xử lý theo uỷ quyền hợp lệ từ Processor chính, không nhận chỉ thị trực tiếp từ khách hàng cuối. | Tuỳ theo hợp đồng giữa doanh nghiệp và Processor chính. |
Việc xác định đúng mình đang ở mô hình nào và trách nhiệm được phân chia ra sao trong mô hình đó giúp đội hạ tầng tránh được tình trạng phổ biến: cho rằng nhà cung cấp "chịu trách nhiệm toàn bộ" trong khi thực tế một phần quan trọng (ví dụ mục đích sử dụng dữ liệu, cấu hình truy cập ở tầng ứng dụng) vẫn thuộc về doanh nghiệp.
6. Cách GreenNode xây dựng kiến trúc này ba mô hình triển khai và năng lực chuyển đổi nhà cung cấp
Trên thực tế, không có một kiến trúc "chuẩn" duy nhất phù hợp cho mọi doanh nghiệp mà cần chọn mô hình triển khai phù hợp với hiện trạng hợp đồng, quy mô dữ liệu và mức độ sẵn sàng chuyển đổi. GreenNode hiện hỗ trợ ba mô hình hợp tác, khác nhau ở nơi đặt hạ tầng và pháp nhân chịu trách nhiệm vận hành:
Mô hình 1 Dữ liệu lưu trữ và xử lý hoàn toàn tại Việt Nam, không chuyển dữ liệu ra nước ngoài.
Mô hình 2 Dữ liệu được xử lý tại một pháp nhân khu vực, đi kèm các bước đánh giá tác động chuyển dữ liệu xuyên biên giới phù hợp trước khi triển khai.
Mô hình 3 Mô hình nhiều lớp, trong đó một đối tác trong nước là đầu mối chính, GreenNode tham gia với vai trò hỗ trợ kỹ thuật theo ủy quyền.
Điểm chung của cả ba mô hình là năng lực chuyển đổi nhà cung cấp (exit & portability) được thiết kế sẵn ngay từ đầu doanh nghiệp có thể xuất dữ liệu, di chuyển workload, hoặc thay đổi mô hình hợp tác khi nhu cầu thay đổi, mà không phải xây lại toàn bộ cơ chế quản trị từ con số 0. Đây là một trong những giá trị thực tế nhất của việc thiết kế kiến trúc sovereign ngay từ đầu: tổ chức luôn giữ được quyền lựa chọn, thay vì bị ràng buộc bởi một nhà cung cấp duy nhất.
7. Bộ 9 tiêu chí đánh giá Sovereign AI Cloud và checklist cho cấp quản lý hạ tầng
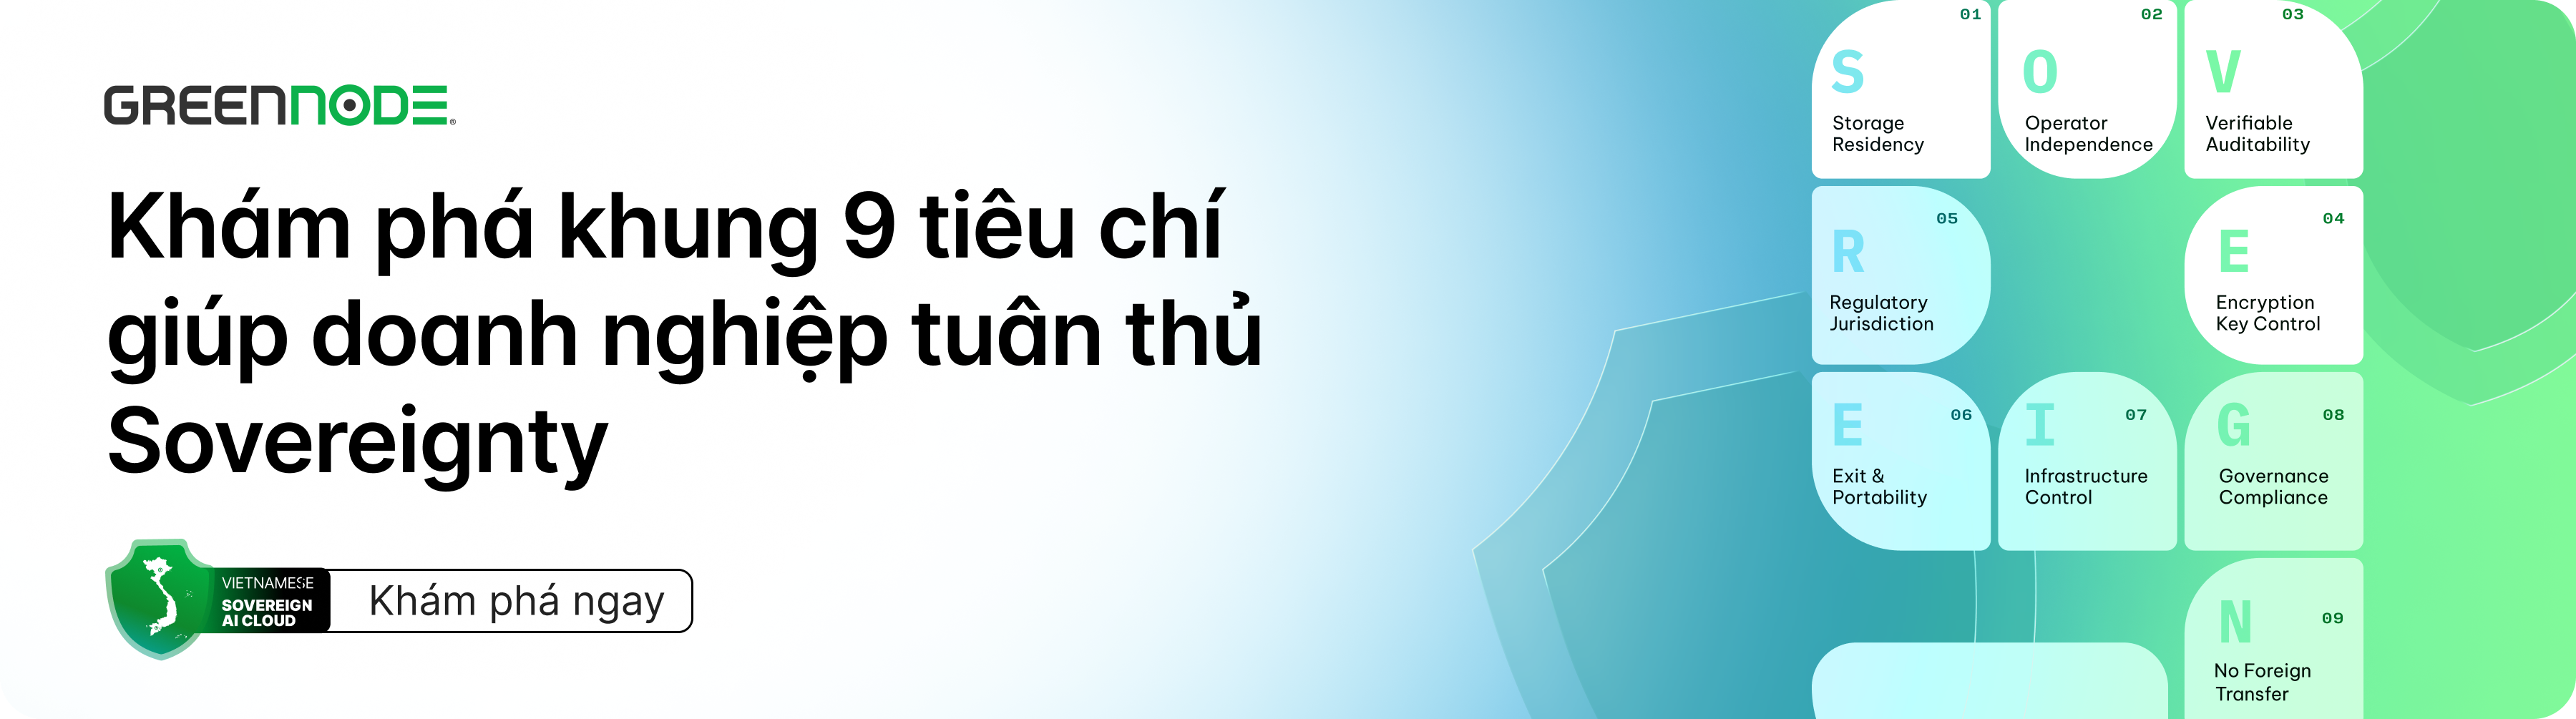
Để giúp cấp quản lý hạ tầng CNTT và Giám đốc An toàn Thông tin (CISO) có cơ sở thẩm định năng lực thực chất của các nhà cung cấp Cloud/AI, dưới đây là bộ tiêu chí kiểm soát Sovereign AI Cloud bao gồm 9 chỉ số cốt lõi:
- Storage Residency (Lưu trữ Nội địa): Dữ liệu gốc, dữ liệu sao lưu và metadata được lưu trữ và xử lý chính xác tại phạm vi địa lý đã cam kết .
- Operator Independence (Tự chủ Vận hành): Doanh nghiệp toàn quyền vận hành workload trên platform; nhà cung cấp không có quyền can thiệp vào dữ liệu nghiệp vụ ngoài phạm vi thỏa thuận .
- Encryption Key Control (Kiểm soát Khóa Mã hóa): Khách hàng giữ và quản lý khóa mã hóa (KMS); tách biệt hoàn toàn giữa quyền truy cập dữ liệu và quyền giữ khóa .
- Infrastructure Control (Kiểm soát Hạ tầng): Minh bạch vị trí Trung tâm Dữ liệu; chỉ có nhân sự được ủy quyền hợp lệ tại Việt Nam mới có quyền vận hành hệ thống .
- Regulatory Jurisdiction (Tài phán Pháp lý): Dữ liệu và hạ tầng tuân thủ hoàn toàn theo hệ thống pháp luật Việt Nam, không bị can thiệp bởi luật tài phán nước ngoài .
- Verifiable Auditability (Khả năng Kiểm toán Minh bạch): Hệ thống lưu vết chi tiết (ai truy cập, lúc nào, từ đâu) sẵn sàng xuất bản báo cáo kiểm toán tuân thủ .
- Exit & Portability (Khả năng Di chuyển Dữ liệu): Cung cấp công cụ chuẩn hóa để trích xuất dữ liệu, mô hình và cơ chế xóa dữ liệu an toàn khi chấm dứt dịch vụ .
- Governance Compliance (Tuân thủ Tiêu chuẩn): Đáp ứng các chứng nhận an toàn thông tin quốc tế và quy định ngành đặc thù (ISO 27001, SOC 2, Thông tư 09/12 NHNN) .
- No Foreign Transfer (Khóa Chuyển Dữ liệu Tự động): Không tự động truyền tải hay lưu trữ dữ liệu sang vùng hạ tầng ngoài Việt Nam nếu chưa có phê duyệt chính thức bằng văn bản .
Checklist 3 câu hỏi cấp quản lý hạ tầng cần làm rõ trước khi ký kết hợp đồng
- Kiểm tra lớp Control Plane: "Lớp quản trị (console, metadata, logging) của dịch vụ được đặt tại đâu và do pháp nhân nào trực tiếp vận hành?"
- Ranh giới trách nhiệm theo mô hình dịch vụ: "Nhà cung cấp chịu trách nhiệm đến đâu trong việc bảo vệ an toàn mô hình và nhật ký truy xuất đối với các dịch vụ AIaaS / Managed AI?"
- Quy trình di chuyển dữ liệu (Exit Strategy): "Khi cần chấm dứt hợp đồng, quy trình trích xuất toàn bộ vector embedding, dữ liệu log và trọng số mô hình diễn ra như thế nào, và cam kết xóa sạch dữ liệu (Data Wiping) được xác nhận ra sao?"
Kết luận
Chủ quyền dữ liệu trong kỷ nguyên AI không thể đạt được bằng cách tập hợp các quyết định phê duyệt công cụ riêng lẻ. Nó đòi hỏi một quy hoạch kiến trúc chuẩn hóa từ hạ tầng vật lý, lớp xử lý dữ liệu, lớp huấn luyện - phục vụ mô hình cho đến khung quản trị xuyên suốt
Hệ sinh thái GreenNode Sovereign AI Cloud được xây dựng nhằm mang lại cho doanh nghiệp khả năng tăng tốc triển khai AI mà vẫn duy trì quyền kiểm soát thực chất đối với tài sản dữ liệu và tuân thủ hoàn toàn khung pháp lý Việt Nam