
NVIDIA GeForce RTX 5090 và RTX PRO 6000 Blackwell đều được xây dựng trên kiến trúc Blackwell, mang lại hiệu năng tính toán mạnh mẽ cho các tác vụ AI. Tuy nhiên, dù có cùng nền tảng kiến trúc, hai dòng GPU này được thiết kế để đáp ứng những nhu cầu triển khai khác nhau.
RTX 5090 sở hữu 32GB VRAM, phù hợp với các tác vụ phát triển, thử nghiệm và inference model AI quy mô vừa. Trong khi đó, RTX PRO 6000 Blackwell được trang bị 96GB VRAM với bộ nhớ ECC và khả năng phân chia tài nguyên GPU bằng MIG, hướng đến những workload yêu cầu bộ nhớ lớn và vận hành ổn định trong môi trường production.
Vậy giữa RTX 5090 và RTX PRO 6000 Blackwell, đâu là lựa chọn phù hợp với nhu cầu và ngân sách của doanh nghiệp? Bài viết dưới đây sẽ so sánh hai dòng GPU về thông số kỹ thuật, hiệu năng AI, khả năng triển khai LLM và chi phí đầu tư, giúp doanh nghiệp đưa ra quyết định phù hợp với từng workload.
RTX 5090 hay RTX PRO 6000 Blackwell: Đâu là lựa chọn phù hợp?
| Chọn RTX 5090 khi | Chọn RTX PRO 6000 khi |
|---|---|
| Model từ 32B trở xuống (4-bit) hoặc khoảng 13B (FP16) | Model 70B trở lên, hoặc model 30B ở FP16 |
| Phát triển, thử nghiệm, fine-tune LoRA model nhỏ | Fine-tune model lớn hơn, batch lớn |
| Tạo ảnh với SDXL, Flux | Inference nhiều người dùng, context dài |
| Ngân sách là ưu tiên hàng đầu | Cần ECC, chia GPU bằng MIG, chạy 24/7 |
Điểm khác biệt quan trọng nhất giữa hai dòng GPU nằm ở dung lượng VRAM và khả năng đáp ứng các workload AI quy mô lớn. Khi model có thể chạy hoàn toàn trong 32GB VRAM, RTX 5090 có thể mang lại hiệu năng inference tương đương với RTX PRO 6000 trong một số bài đo, với chi phí đầu tư thấp hơn.
Ngược lại, khi doanh nghiệp cần triển khai model lớn, mở rộng số lượng request đồng thời hoặc vận hành hệ thống AI liên tục, RTX PRO 6000 Blackwell mang lại nhiều lợi thế hơn về dung lượng bộ nhớ và tính năng chuyên nghiệp.
Bảng so sánh thông số RTX 5090 và RTX PRO 6000
Cả RTX 5090 và RTX PRO 6000 đều sử dụng kiến trúc NVIDIA Blackwell cùng Tensor Core thế hệ thứ năm. Tuy nhiên, hai dòng GPU có sự khác biệt đáng kể về dung lượng VRAM, tính năng quản lý tài nguyên và định hướng sử dụng.
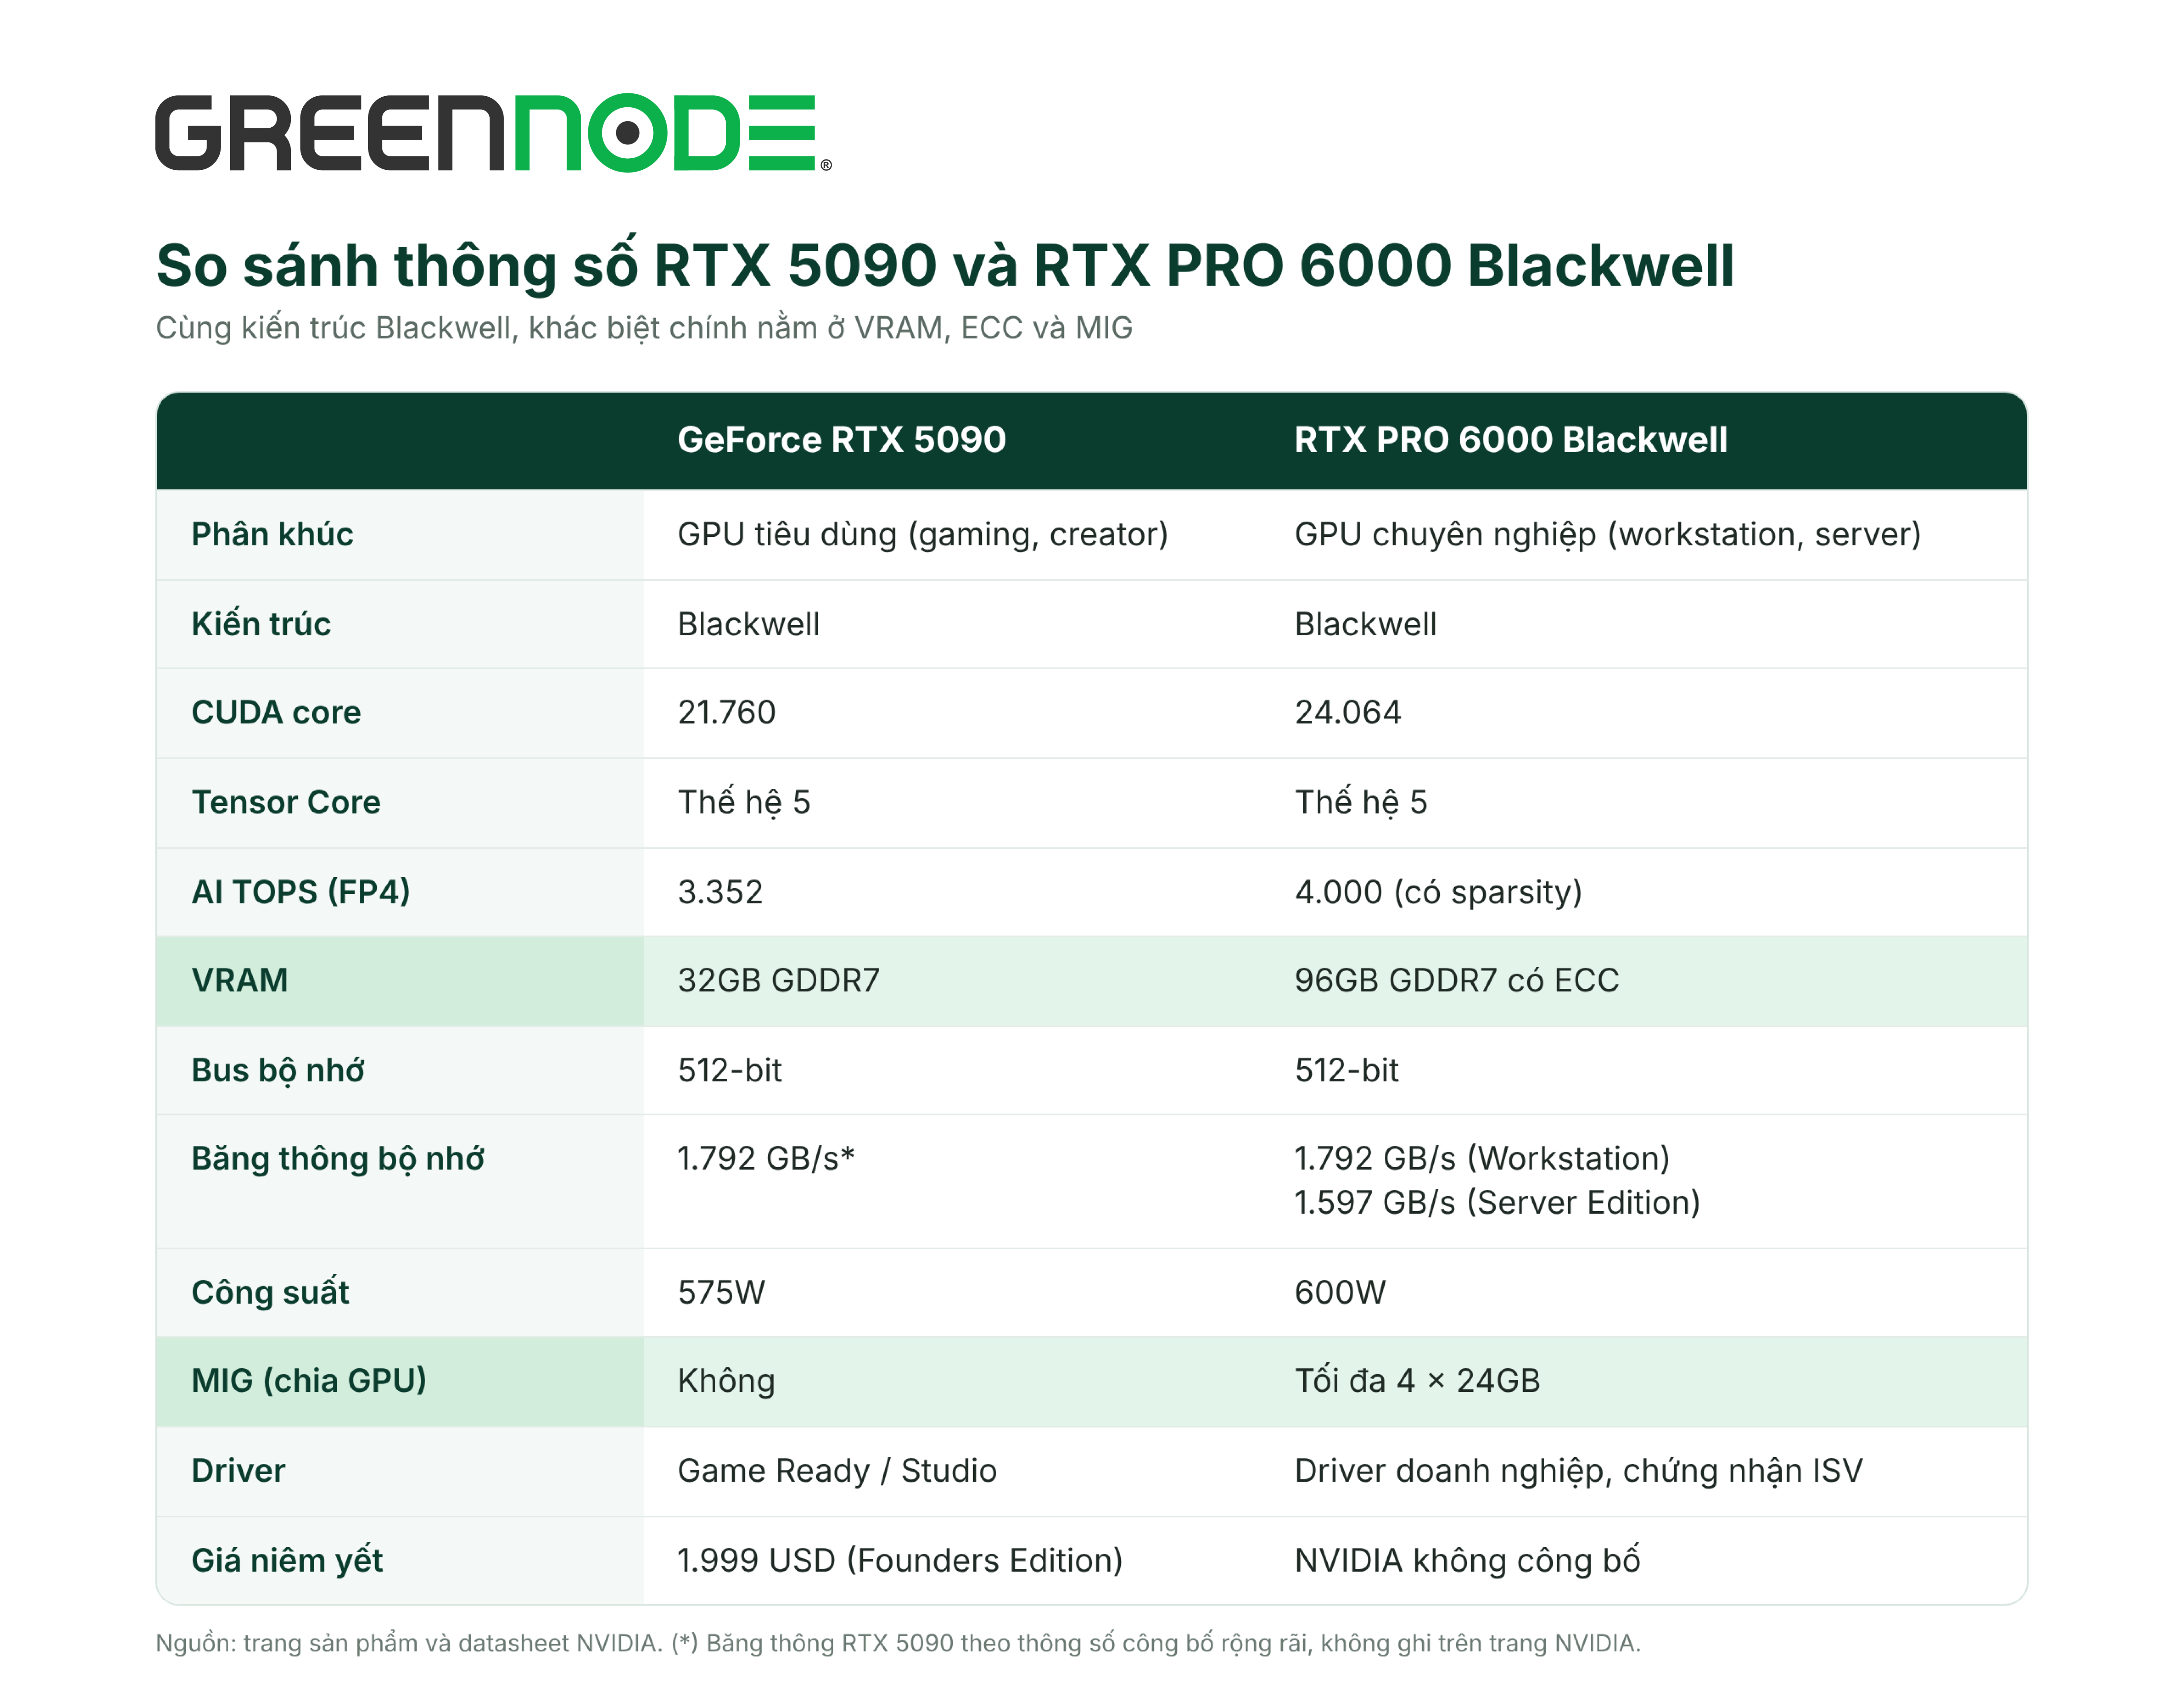
Về sức tính toán, RTX PRO 6000 chỉ nhiều hơn khoảng 10% CUDA core và có cùng băng thông bộ nhớ (bản Workstation). Vì vậy với model vừa trong 32GB, hai card cho tốc độ gần như nhau. Khoảng cách thật sự nằm ở dung lượng VRAM và các tính năng dành cho môi trường doanh nghiệp.
So sánh VRAM 32GB và 96GB: RTX 5090 và RTX PRO 6000 chạy được model AI nào?
Với AI, VRAM quyết định model có nạp được vào GPU hay không. Ngoài trọng số model, GPU còn cần thêm bộ nhớ cho KV cache: context càng dài và càng nhiều người dùng cùng lúc thì KV cache càng lớn.
| Model và độ chính xác | Trọng số (ước tính) | RTX 5090 (32GB) | RTX PRO 6000 (96GB) |
|---|---|---|---|
| 7–8B, FP16 | ~16GB | Chạy tốt | Chạy tốt, nhiều chỗ cho KV cache |
| 13–14B, FP16 | ~28GB | Vừa khít, ít chỗ cho context | Chạy tốt |
| 32B, 4-bit | ~18–20GB | Chạy được | Chạy tốt |
| 32B, FP16 | ~64GB | Không vừa | Chạy được |
| 70B, 4-bit | ~40GB | Không vừa | Chạy tốt |
| 70B, FP8 | ~70GB | Không vừa | Chạy được, context hạn chế |
| 100–120B, 4-bit | ~60–70GB | Không vừa | Chạy được |
Ước tính chỉ tính trọng số (FP16 ≈ 2 byte, FP8 ≈ 1 byte, 4-bit ≈ 0,5 byte mỗi tham số). Nhu cầu thực tế cao hơn do KV cache và overhead của inference engine.
Hai điểm cần lưu ý: RTX 5090 không có NVLink, nên không thể gộp VRAM của hai card thành một vùng nhớ chung; và việc đẩy một phần model sang RAM hệ thống (offload) làm tốc độ giảm mạnh, chỉ nên dùng khi thử nghiệm.
ECC, MIG và khả năng vận hành AI trong môi trường production
Ngoài VRAM, RTX PRO 6000 có hai tính năng mà RTX 5090 không có. Chúng ít quan trọng khi thử nghiệm, nhưng quan trọng khi GPU chạy dịch vụ thật:
- Bộ nhớ ECC: tự phát hiện và sửa lỗi bit trong VRAM. Với job huấn luyện kéo dài nhiều ngày hoặc dịch vụ inference chạy 24/7, ECC giảm nguy cơ kết quả sai hoặc tiến trình dừng giữa chừng mà không rõ lý do.
- Driver và hỗ trợ doanh nghiệp: RTX PRO 6000 dùng driver dành cho workstation và máy chủ, được chứng nhận với nhiều phần mềm chuyên ngành. Bản Server Edition dùng tản nhiệt thụ động, thiết kế để lắp trong máy chủ trung tâm dữ liệu.
RTX 5090 vẫn chạy tốt các framework AI phổ biến như PyTorch, vLLM hay Ollama. Với phát triển, thử nghiệm và workload không yêu cầu chạy liên tục, thiếu ECC và MIG thường không phải vấn đề lớn.
So sánh hiệu năng AI thực tế giữa RTX 5090 và RTX PRO 6000
Theo bài đo được dẫn từ ComputingForGeeks vào tháng 6/2026, khi chạy các model lượng tử hóa 4-bit bằng Ollama với một luồng sinh token, RTX 5090 và RTX PRO 6000 cho kết quả khá tương đồng ở các model có thể nạp hoàn toàn vào 32GB VRAM.
Hiệu năng inference LLM: Token/giây có chênh lệch nhiều không?
Bài đo của ComputingForGeeks (Ollama, model 4-bit, tốc độ sinh token một luồng) cho thấy hai card gần như ngang nhau khi model vừa trong 32GB. Khác biệt chỉ xuất hiện khi model vượt quá 32GB:
| Model (4-bit, Ollama) | RTX 5090 | RTX PRO 6000 |
|---|---|---|
| Qwen2.5 7B | 228,2 token/s | 238,6 token/s |
| Qwen2.5 14B | 131,5 token/s | 134,1 token/s |
| Qwen2.5 32B | 67,8 token/s | 68,1 token/s |
| Llama 3.1 70B | Không nạp được | 34,2 token/s |
| Qwen2.5 72B | Không nạp được | 31,0 token/s |
Nguồn: ComputingForGeeks, đo tháng 6/2026. Kết quả khác đi khi dùng inference engine, độ chính xác hoặc batch size khác.
Với dịch vụ phục vụ nhiều người dùng cùng lúc (ví dụ dùng vLLM), VRAM lớn của RTX PRO 6000 cho phép giữ KV cache của nhiều request hơn, nên thường phục vụ được nhiều người dùng hơn hoặc context dài hơn trên cùng một model.
Hiệu năng tạo ảnh AI với SDXL và FLUX
Các model tạo ảnh phổ biến như SDXL và Flux.1 vừa trong 32GB, nên tốc độ tạo ảnh trên hai card tương đương nhau. RTX 5090 là lựa chọn hợp lý về chi phí; RTX PRO 6000 chỉ có lợi thế khi chạy đồng thời nhiều model hoặc tạo video, ảnh độ phân giải rất cao.
Hiệu năng fine-tuning model AI
RTX 5090 có thể đáp ứng các tác vụ fine-tuning bằng LoRA hoặc QLoRA đối với model 7B–13B, tùy thuộc vào cấu hình huấn luyện, sequence length và batch size.
Tuy nhiên, khi quy mô model tăng, nhu cầu bộ nhớ cho trọng số, gradient và optimizer cũng tăng đáng kể.
Với 96GB VRAM, RTX PRO 6000 mang lại nhiều không gian bộ nhớ hơn để fine-tune model lớn, tăng batch size hoặc thử nghiệm những phương pháp huấn luyện đòi hỏi nhiều tài nguyên.
So sánh chi phí RTX 5090 và RTX PRO 6000: Nên mua GPU hay thuê GPU Cloud?
Khi đầu tư hạ tầng AI, doanh nghiệp cần đánh giá tổng chi phí sở hữu và vận hành (Total Cost of Ownership – TCO), thay vì chỉ so sánh giá mua GPU ban đầu.
Ngoài phần cứng, việc triển khai GPU tại chỗ còn phát sinh chi phí máy chủ, điện năng, làm mát, không gian trung tâm dữ liệu, bảo trì và nhân sự vận hành.
Trong khi đó, thuê GPU Cloud cho phép doanh nghiệp tiếp cận tài nguyên tính toán mà không cần đầu tư toàn bộ hạ tầng ngay từ đầu.
Kết luận: với phần lớn doanh nghiệp, thuê GPU cloud là lựa chọn hợp lý hơn mua card, trừ khi GPU chạy gần như liên tục trong nhiều năm và đã có sẵn trung tâm dữ liệu. Lý do:
- Không tốn chi phí ban đầu: mua card phải trả trước cho card, máy chủ, hạ tầng điện và làm mát; thuê chỉ trả theo thời gian sử dụng.
- Có GPU nhanh hơn: mua card phụ thuộc nguồn hàng, còn GPU cloud khởi tạo được trong thời gian ngắn.
- Dễ đổi cấu hình: khi workload thay đổi, có thể chuyển giữa RTX 5090, RTX PRO 6000 hoặc H100 thay vì mua thêm card.
- Không phải tự vận hành phần cứng: nhà cung cấp lo hạ tầng, điện và xử lý sự cố.
- Phù hợp để thử trước: doanh nghiệp có thể chạy workload thật trên GPU thuê, đo bộ nhớ và hiệu năng, rồi mới quyết định có đầu tư phần cứng hay không.
Tham khảo giá thuê công khai trên GreenNode GPU Instances (tháng 11/2026): RTX 5090 từ 769 USD/30 ngày, RTX 4090 từ 610 USD/30 ngày, H100 từ 2.803 USD/30 ngày. RTX PRO 6000 báo giá theo cấu hình.
Cách so sánh hợp lý nhất là tính chi phí trên kết quả, ví dụ chi phí cho mỗi triệu token sinh ra: đo throughput thực tế của model trên từng GPU, rồi chia chi phí thuê cho số token xử lý được. Một card đắt hơn nhưng phục vụ được nhiều request hơn có thể cho chi phí mỗi token thấp hơn.
Nên chọn RTX 5090 hay RTX PRO 6000 cho từng workload AI?
Không có một dòng GPU tối ưu cho mọi bài toán AI. Lựa chọn phù hợp cần dựa trên quy mô model, yêu cầu bộ nhớ, mức độ đồng thời và mục tiêu vận hành của doanh nghiệp.
| Workload | Gợi ý | Lý do |
|---|---|---|
| Chatbot, trợ lý nội bộ với model 7B–32B (4-bit) | RTX 5090 | Model vừa 32GB, tốc độ ngang RTX PRO 6000, chi phí thấp hơn |
| Model 70B, model 30B ở FP16 | RTX PRO 6000 | Cần hơn 32GB VRAM |
| Inference nhiều người dùng, context dài | RTX PRO 6000 | Nhiều VRAM hơn cho KV cache |
| Tạo ảnh SDXL, Flux | RTX 5090 | Vừa 32GB, hiệu năng tương đương |
| Fine-tune LoRA model 7B–13B | RTX 5090 | Đủ bộ nhớ, chi phí thấp |
| Fine-tune model lớn, batch lớn | RTX PRO 6000 | Cần bộ nhớ cho gradient và optimizer |
| Nhiều nhóm dùng chung GPU | RTX PRO 6000 | Chia card bằng MIG |
| Dịch vụ chạy 24/7 | RTX PRO 6000 | ECC, driver doanh nghiệp |
| Huấn luyện quy mô lớn, nhiều GPU | Cân nhắc H100 / H200 | Cần NVLink và băng thông HBM |
RTX 5090 phù hợp khi doanh nghiệp ưu tiên hiệu quả chi phí cho các workload AI vừa và nhỏ. RTX PRO 6000 Blackwell là lựa chọn đáng cân nhắc khi nhu cầu triển khai vượt giới hạn 32GB VRAM hoặc đòi hỏi khả năng quản lý tài nguyên và vận hành chuyên nghiệp.
Đối với các bài toán huấn luyện AI quy mô lớn, doanh nghiệp cũng nên đánh giá những dòng GPU chuyên dụng như NVIDIA H100 hoặc H200.
GreenNode GPU Instances
Thuê RTX 5090 và RTX PRO 6000 tại Việt Nam
GPU Blackwell cho inference, fine-tune và tạo ảnh, thuê theo nhu cầu.
GreenNode hiện đã cung cấp hai loại GPU Instances RTX 5090 và RTX PRO 6000 cho doanh nghiệp
Việc lựa chọn GPU phù hợp là bước đầu tiên. Để triển khai AI hiệu quả, doanh nghiệp còn cần một hạ tầng có khả năng cung cấp tài nguyên linh hoạt, đáp ứng nhu cầu mở rộng và giảm gánh nặng vận hành phần cứng.
GreenNode GPU Instances cung cấp nhiều dòng GPU NVIDIA phục vụ các tác vụ AI, bao gồm RTX 5090, RTX PRO 6000 Blackwell, H200, H100, L40S, A40 và RTX 4090.
Với hạ tầng tại Hà Nội, TP.HCM và Bangkok, GreenNode mang đến lựa chọn triển khai GPU trong khu vực cho các doanh nghiệp phục vụ người dùng tại Việt Nam và Đông Nam Á.
Tùy theo workload, doanh nghiệp có thể lựa chọn:
- RTX 5090 (32GB GDDR7): từ 769 USD/30 ngày, phù hợp cho phát triển, inference model tới 32B và tạo ảnh.
- RTX PRO 6000 Blackwell (96GB GDDR7 ECC): cho model 70B, inference nhiều người dùng và fine-tune; liên hệ để nhận báo giá.
Thuê theo nhu cầu, không cam kết dài hạn, nên doanh nghiệp có thể bắt đầu với RTX 5090 để thử nghiệm, rồi chuyển sang RTX PRO 6000 khi model hoặc lưu lượng tăng. Xem thêm: GreenNode bổ sung NVIDIA H200 và RTX PRO 6000 Blackwell.
Câu hỏi thường gặp
RTX PRO 6000 có nhanh hơn RTX 5090 không?
Với model vừa trong 32GB, hai card có tốc độ gần như nhau vì cùng kiến trúc Blackwell và cùng băng thông bộ nhớ. RTX PRO 6000 vượt trội khi model hoặc context cần hơn 32GB VRAM.
RTX 5090 có chạy được model 70B không?
Không trên một card nếu chỉ dùng VRAM. Model 70B ở 4-bit cần khoảng 40GB cho trọng số, vượt quá 32GB. Có thể offload một phần sang RAM nhưng tốc độ giảm mạnh.
Hai card RTX 5090 có thay được một RTX PRO 6000 không?
Không hoàn toàn. RTX 5090 không có NVLink, nên khi chia model qua hai card, dữ liệu phải đi qua PCIe và hiệu năng thấp hơn một card có sẵn 96GB. Hai card cũng tiêu thụ gần gấp đôi điện năng.
Khi nào nên chọn H100 hoặc H200 thay vì RTX PRO 6000?
Khi huấn luyện model lớn trên nhiều GPU, cần NVLink và băng thông bộ nhớ HBM cao, hoặc cần VRAM lớn hơn 96GB trên một GPU (H200 có 141GB).
Nên mua hay thuê RTX PRO 6000?
Mua phù hợp khi GPU chạy gần như liên tục trong nhiều năm và doanh nghiệp có sẵn hạ tầng. Thuê phù hợp khi nhu cầu chưa ổn định, cần bắt đầu ngay hoặc muốn thử workload trước khi đầu tư.
Bắt đầu với GPU Blackwell trên GreenNode
Nếu chưa chắc card nào phù hợp, hãy chạy model của bạn trên RTX 5090 trước và đo bộ nhớ thực tế cần dùng. Khi cần nhiều VRAM hơn, đội ngũ GreenNode hỗ trợ chuyển sang RTX PRO 6000.
