
Một lập trình viên được giao nhiệm vụ xây dựng một AI agent có khả năng tạo task từ biên bản cuộc họp hoặc các buổi brainstorming lộn xộn, rồi đồng bộ chúng với nền tảng quản lý dự án của team. Phiên bản đầu tiên hoàn thành khá nhanh: agent tạo ra các task có cấu trúc rõ ràng, tạo issue tương ứng, và chạy trơn tru trong quá trình kiểm thử.
Nhưng rồi nó được đưa vào production.
Một dự án thực tế chứa đến hàng trăm task đã tồn tại. Để đối soát (reconcile) từng task mới, hệ thống phải gửi một lượng lớn context của dự án ngược lại cho LLM và chờ từng request khớp task hoàn tất. Khi khối lượng công việc tăng lên, độ trễ (latency) cũng tăng theo; các request bắt đầu chạm rate limit, cơ chế retry lại càng làm tăng áp lực, khiến các task mới phải xếp hàng chờ lâu hơn. Một tính năng tưởng chừng đơn giản là sinh task giờ đây âm thầm trở thành một bài toán về khả năng mở rộng (scalability).
Vì sao đồng bộ task khó hơn nhiều so với việc tạo task
Việc tạo ra các task có cấu trúc tương đối đơn giản. Hầu hết các LLM đều có thể nhận diện action item từ bản ghi cuộc họp, ghi chú, hay các buổi brainstorming với độ chính xác khá tốt.
Thử thách thực sự bắt đầu khi những task này cần được đồng bộ với một hệ thống quản lý dự án như Redmine hay Jira. Với mỗi task mới, agent phải quyết định xem nó nên đứng độc lập, khớp với một issue đã có, trở thành subtask, hay đóng vai trò parent của một task khác.
Một giải pháp đơn giản (naive) là gửi toàn bộ các task vừa trích xuất được, cùng với hàng trăm issue đã có trong dự án, vào một LLM duy nhất và yêu cầu nó đối soát tất cả trong một lượt.
Cách tiếp cận này không mở rộng tốt. Khi context càng lớn, quá trình inference càng chậm và tốn kém hơn. Model cũng phải theo dõi quá nhiều task và các mối quan hệ khả dĩ cùng lúc, làm tăng nguy cơ bỏ sót match, dựng sai hierarchy, và ra quyết định thiếu nhất quán.
Cách tiếp cận được trình bày trong bài viết này kết hợp khớp ngữ nghĩa (semantic matching) với xử lý song song (parallel processing). Semantic matching giúp thu hẹp tập ứng viên (candidate) cho mỗi task, còn việc chạy song song cho phép các request khớp task độc lập được xử lý đồng thời. Các đề xuất (proposal) thu được sau đó sẽ được đối soát ở một bước hậu xử lý (post-processing) riêng để đảm bảo các mối quan hệ giữa các task luôn hợp lệ.
Các khái niệm cốt lõi
Trước khi đi vào phần triển khai, sẽ hữu ích nếu chúng ta hiểu rõ các khái niệm chính được dùng trong pipeline này.
Cấu trúc phân cấp task (Task Hierarchy)
Các nền tảng quản lý dự án như Redmine và Jira thường tổ chức công việc theo các mối quan hệ phân cấp (hierarchical).
Một task có thể là:
- Một issue độc lập
- Một parent task đại diện cho một phạm vi công việc lớn hơn
- Một subtask đóng góp vào một task lớn hơn
Ví dụ, một cấu trúc phân cấp task có thể trông như sau:
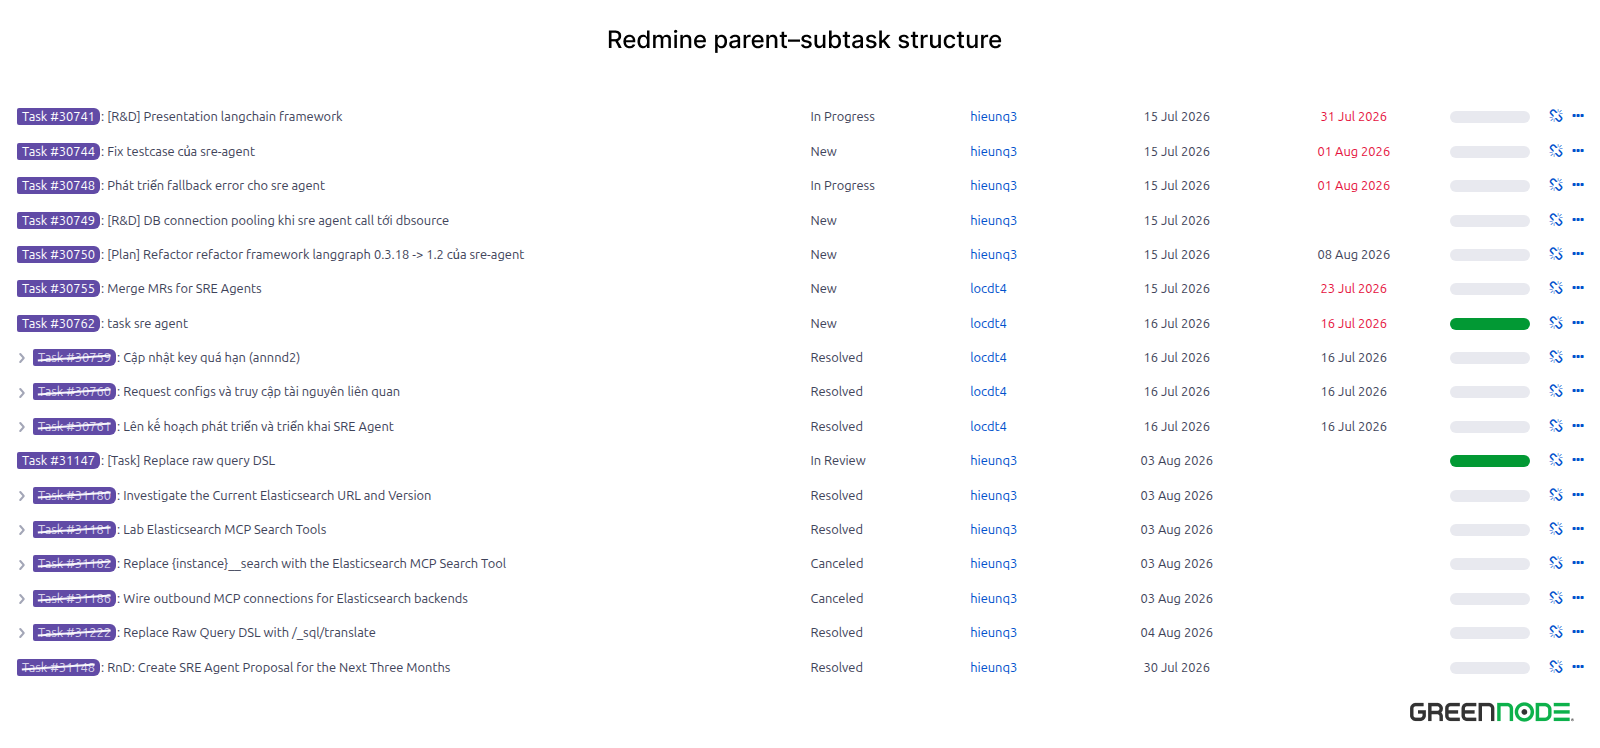
Khi agent tạo ra một task mới, nó phải quyết định vị trí của task đó trong cấu trúc phân cấp hiện có. Một quyết định sai có thể tạo ra bản trùng lặp (duplicate), gắn task vào một parent không liên quan, hoặc tái cấu trúc sai một issue đã tồn tại.
Khớp ngữ nghĩa (Semantic Matching)
Semantic matching so sánh hai câu để xác định xem chúng có cùng nghĩa hoặc nghĩa tương tự hay không.
Ý tưởng ở đây là áp dụng một chút "phép màu" toán học. Mỗi câu được ánh xạ vào một không gian vector tiềm ẩn (latent vector space), nơi nó được biểu diễn dưới dạng một vector số. Nếu hai vector nằm gần nhau, nhiều khả năng hai câu có ý nghĩa tương tự nhau. Nếu chúng nằm xa nhau, các câu đó có thể ít liên quan hơn.
Ví dụ, hai task dưới đây dùng cách diễn đạt khác nhau nhưng mô tả những công việc có liên quan chặt chẽ:
- Triển khai kiểm tra phân quyền cho các API dành cho admin
- Thêm cơ chế phân quyền theo vai trò (role-based authorization) cho các endpoint backend
Semantic matching chuyển các câu này thành vector — một biểu diễn số cho ý nghĩa của chúng. Các câu có nghĩa tương tự nhau sẽ có vector nằm gần nhau hơn.
Từ đó, hệ thống có thể tìm các task đã tồn tại có nghĩa gần nhất, và chọn ra một nhóm nhỏ các ứng viên liên quan từ hàng trăm, thậm chí hàng nghìn issue.
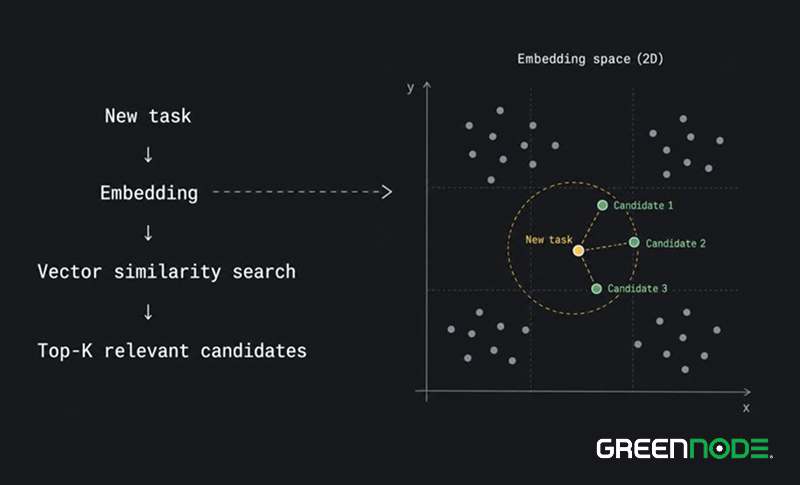
Cách các từ được sắp xếp trong không gian vector
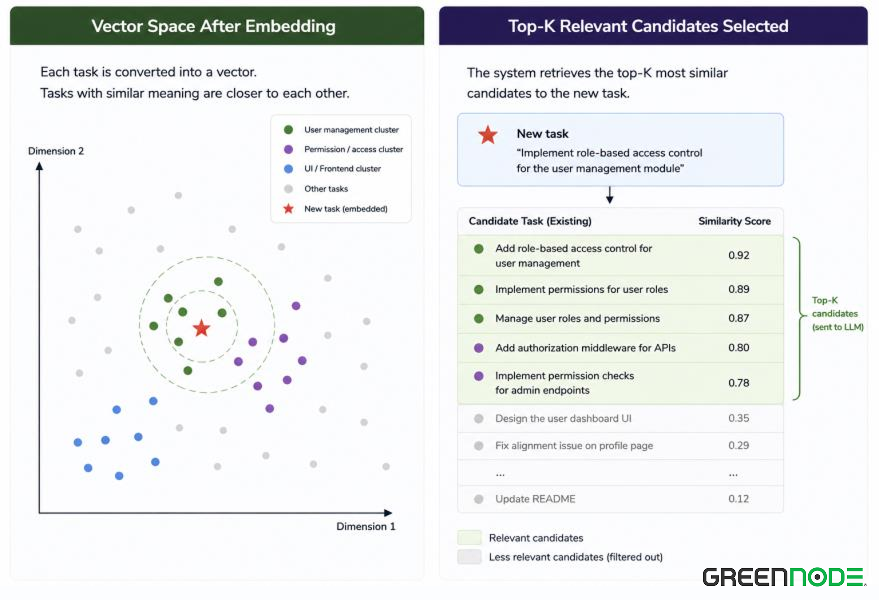
Cách các task ứng viên hiện có được trích xuất từ không gian vector
Xử lý song song (Parallel Processing)
Xử lý song song là một mô hình thực thi trong đó nhiều task được xử lý cùng lúc trong cùng một khoảng thời gian.
Trong một quy trình tuần tự (sequential), task này phải hoàn tất trước khi task tiếp theo bắt đầu:
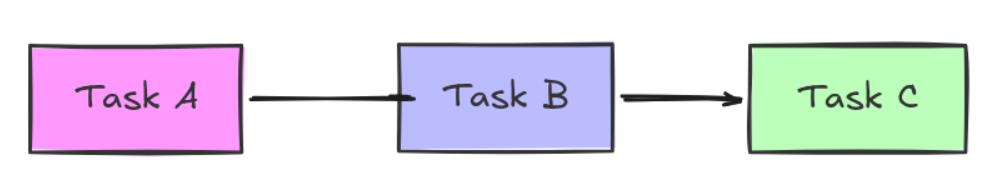
Do đó, tổng thời gian thực thi gần bằng tổng thời gian xử lý của tất cả các task cộng lại.
Trong một quy trình song song, nhiều task có thể được xử lý đồng thời:
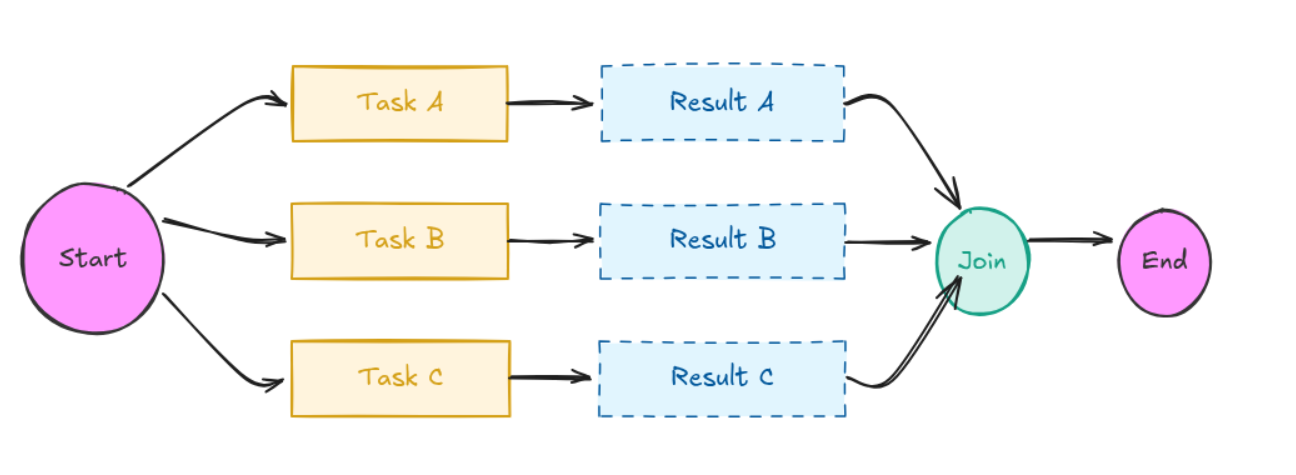
Vì vậy, tổng thời gian thực thi bằng đúng thời gian của task chạy lâu nhất trong số ba task. Điều này đặc biệt hữu ích với các workload bị giới hạn bởi I/O (I/O-bound), nơi phần lớn thời gian chương trình dành để chờ các dịch vụ bên ngoài, phản hồi mạng, hoặc các thao tác với database.
Kịch bản lý tưởng đó giả định mỗi task đều có một worker riêng. Trên thực tế, worker pool luôn bị giới hạn — chỉ có một số lượng worker cố định lấy task từ một hàng đợi (queue) chung.
Khi N task chia sẻ W worker, chúng sẽ xếp hàng theo từng batch thay vì chạy cùng lúc tất cả:
T_parallel ≈ ⌈N / W⌉ × average task time
Ví dụ, với 20 task và 4 worker, ta sẽ có 5 batch chứ không phải một. Thêm worker sẽ giảm số lượng batch, chứ không rút ngắn thời gian xử lý của từng task riêng lẻ.
Đối soát (Reconciliation)
Đối soát (reconciliation) là quá trình gộp nhiều kết quả độc lập thành một trạng thái cuối cùng nhất quán. Kỹ thuật này thường được dùng khi nhiều worker, service, hoặc model tạo ra kết quả đầu ra mà không nắm được đầy đủ quyết định của nhau.
Ví dụ, hai worker có thể cùng chọn một issue nhưng cho hai mối quan hệ khác nhau. Mỗi kết quả riêng lẻ nhìn qua đều hợp lý, nhưng không thể áp dụng cả hai cùng lúc.
Đối soát thường bao gồm ba bước:
- Thu thập kết quả
- Phát hiện xung đột
- Áp dụng quy tắc xử lý xung đột
Kiến trúc được đề xuất
Thay vì yêu cầu một LLM duy nhất đối soát toàn bộ task mới với cả dự án cùng một lúc, kiến trúc được đề xuất chia bài toán này thành các giai đoạn nhỏ hơn, dễ quản lý hơn.
Với mỗi task mới, hệ thống trước tiên truy xuất (retrieve) một tập nhỏ các task đã tồn tại có nghĩa gần nhất. Sau đó, một reranker sẽ tinh chỉnh lại danh sách ứng viên này để LLM chỉ cần đánh giá những mối quan hệ liên quan nhất.
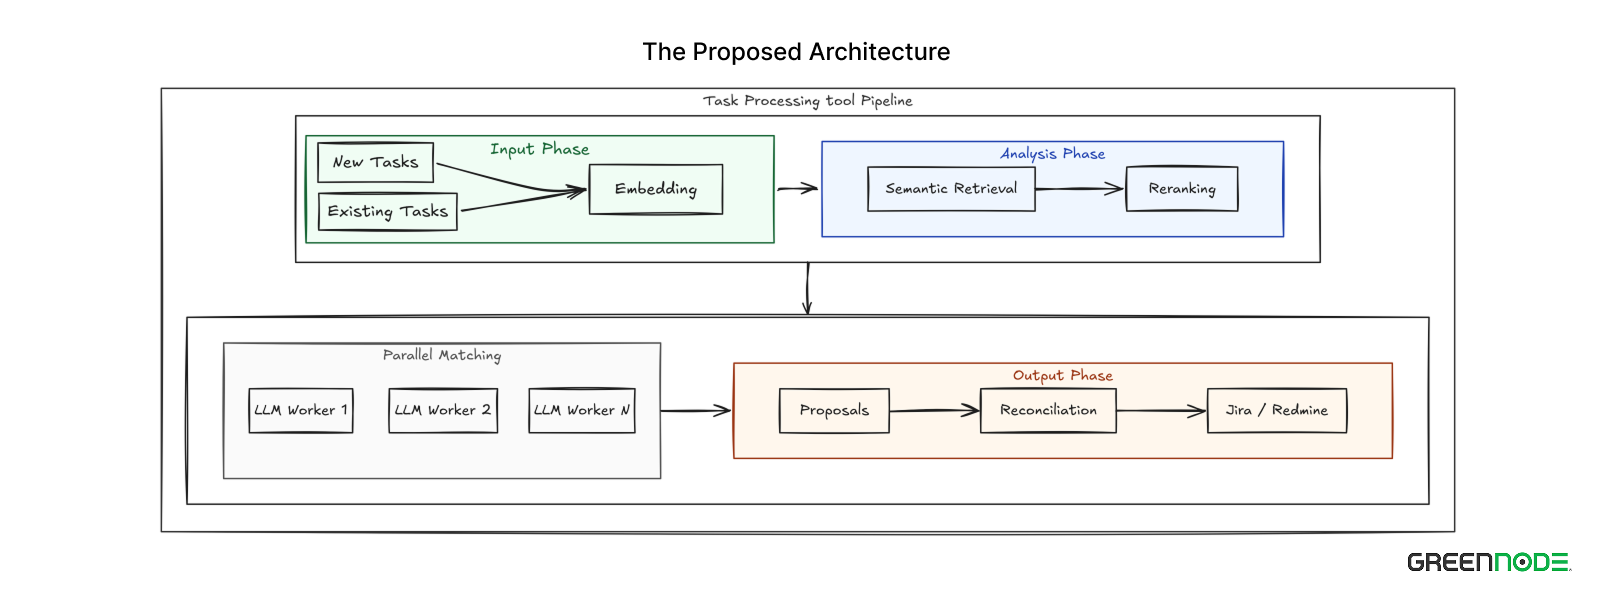
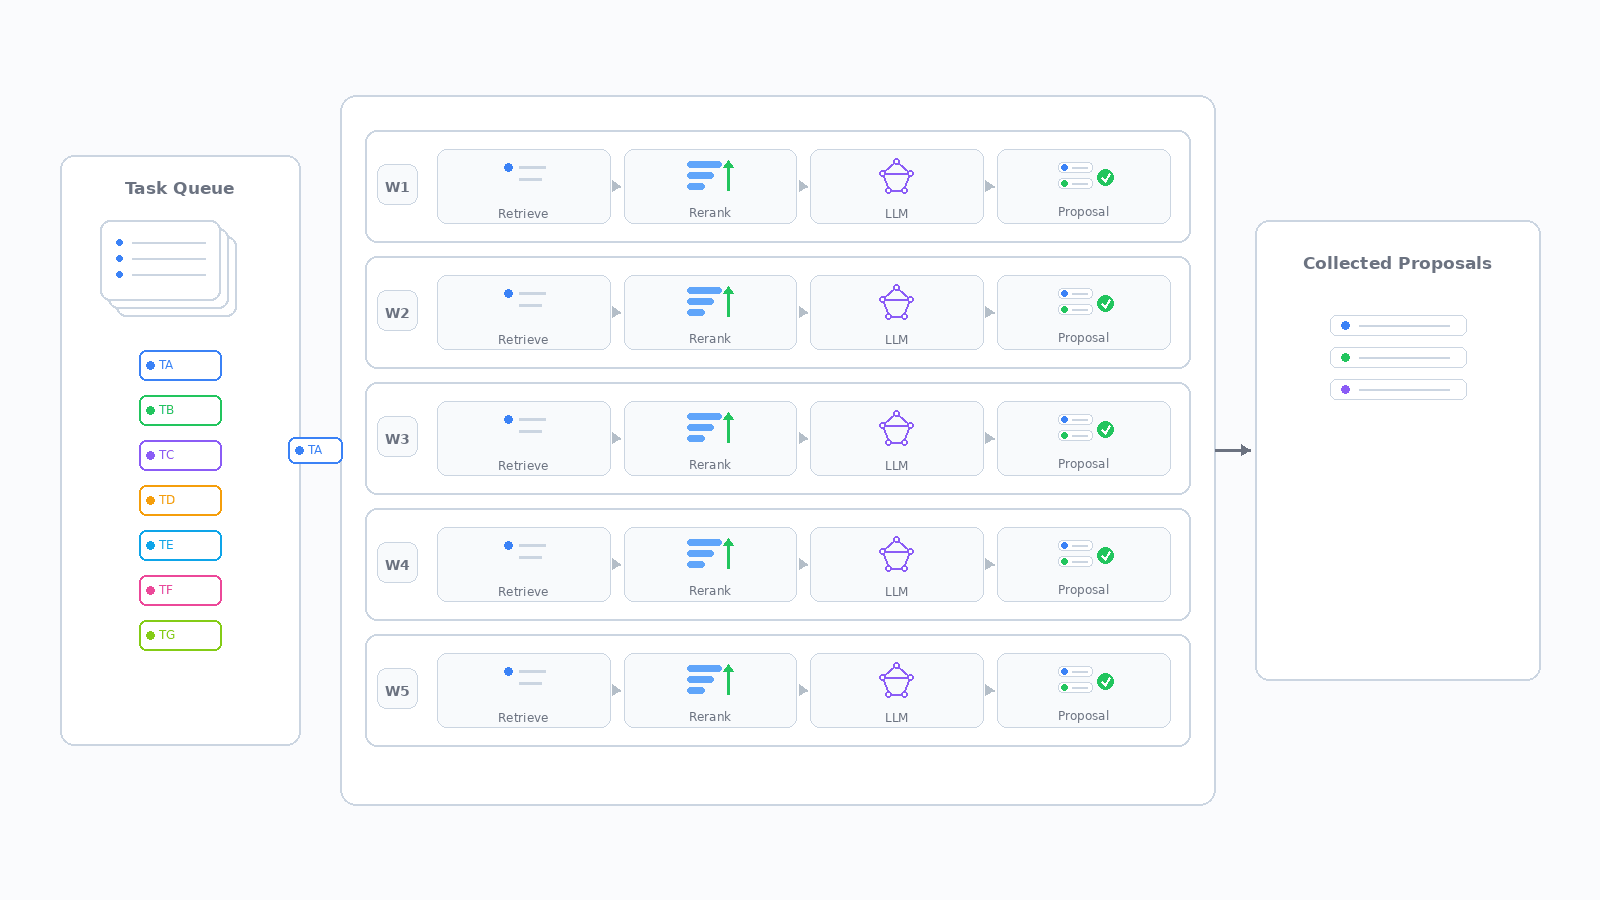
Các request khớp task còn lại được xử lý đồng thời. Mỗi worker đánh giá một task mới và trả về một nhãn đề xuất quan hệ (relationship proposal).
Sau khi tất cả các đề xuất được thu thập đầy đủ, bước đối soát sẽ kiểm tra chúng theo cả một batch hoàn chỉnh. Bước này loại bỏ các quan hệ xung đột, áp dụng các quy tắc xử lý tất định (deterministic), và tạo ra tập cập nhật hợp lệ cuối cùng.
Chỉ sau bước kiểm tra này, các task cùng mối quan hệ của chúng mới được đồng bộ lên Redmine hoặc Jira.
Vì vậy, kiến trúc này tách quy trình làm việc thành ba trách nhiệm chính:
- Truy xuất ngữ nghĩa (semantic retrieval) thu hẹp không gian tìm kiếm
- Khớp song song (parallel matching) giảm thời gian xử lý
- Đối soát (reconciliation) đảm bảo tính nhất quán toàn cục
Cơ chế hoạt động bên trong
Nhìn từ bên ngoài, kiến trúc này có vẻ đơn giản, nhưng mỗi giai đoạn thực chất giải quyết một vấn đề khác nhau. Nói ngắn gọn: truy xuất ngữ nghĩa giữ cho không gian tìm kiếm ở mức dễ quản lý, xử lý song song giảm thời gian chờ, còn đối soát đảm bảo các mối quan hệ cuối cùng luôn nhất quán.
Truy xuất ứng viên theo ngữ nghĩa (Semantic Candidate Retrieval)
Một dự án thực tế có thể chứa hàng trăm, thậm chí hàng nghìn issue đã tồn tại. Nếu gửi toàn bộ số đó cho LLM mỗi khi có task mới, context sẽ trở nên lớn một cách không cần thiết. Thay vào đó, mỗi task mới trước tiên được so sánh với các task hiện có dựa trên độ tương đồng ngữ nghĩa (semantic similarity).
Như đã giải thích ở trên, semantic matching biểu diễn các task dưới dạng vector trong một không gian tiềm ẩn. Các task có nghĩa tương tự thường nằm gần nhau. Điều này giúp chúng ta nhanh chóng thu hẹp một dự án lớn xuống thành một tập ứng viên nhỏ hơn nhiều.
Ví dụ:
- Hơn 100 issue hiện có → Truy xuất ngữ nghĩa → Top 10 ứng viên
Ở giai đoạn này, mục tiêu chưa phải là quyết định mối quan hệ cuối cùng. Do đó, bước truy xuất chỉ trả lời một câu hỏi đơn giản hơn:
- Những task nào đáng để xem xét?
Tập ứng viên sau đó được đưa qua một reranker, đánh giá kỹ hơn từng cặp và đẩy các ứng viên mạnh nhất lên đầu danh sách.
- Top 50 ứng viên → Rerank → Các ứng viên liên quan nhất → LLM đánh giá quan hệ
Nhờ vậy, LLM chỉ cần làm việc với một context nhỏ gọn và rõ ràng hơn, thay vì phải suy luận trên toàn bộ dự án.
Với mỗi ứng viên, LLM có thể đề xuất một trong các mối quan hệ sau:
- PARENT
- CHILD
- UNRELATED
Đến đây, chúng ta đã giảm được khối lượng công việc cần thiết cho một task đơn lẻ. Vấn đề tiếp theo là điều gì sẽ xảy ra khi agent cần đồng bộ nhiều task mới cùng một lúc.
Khớp quan hệ song song (Parallel Relationship Matching)
Giả sử một bản ghi cuộc họp dài được chắt lọc thành 20 task mới.
Nếu xử lý tuần tự, mỗi task phải chờ đến khi task trước đó hoàn tất các lệnh gọi LLM.
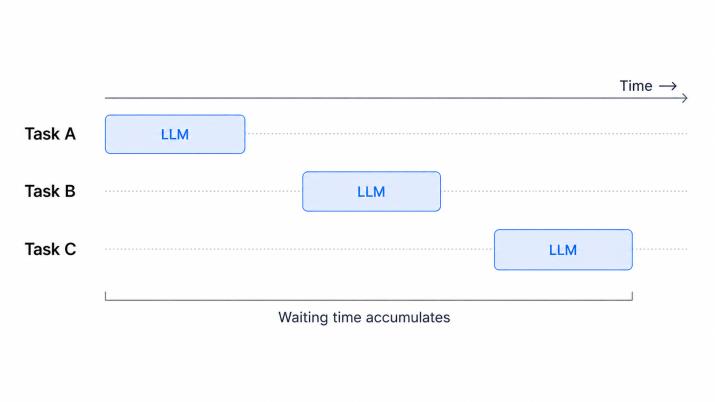
Phần lớn thời gian của một request LLM thực chất là thời gian chờ endpoint bên ngoài trả về kết quả. Nếu xử lý tuần tự, mỗi task mới phải đợi request trước đó hoàn tất. Bằng cách chạy các thao tác khớp task độc lập đồng thời, những khoảng thời gian chờ này có thể chồng lên nhau (overlap), giúp giảm đáng kể tổng thời gian xử lý:
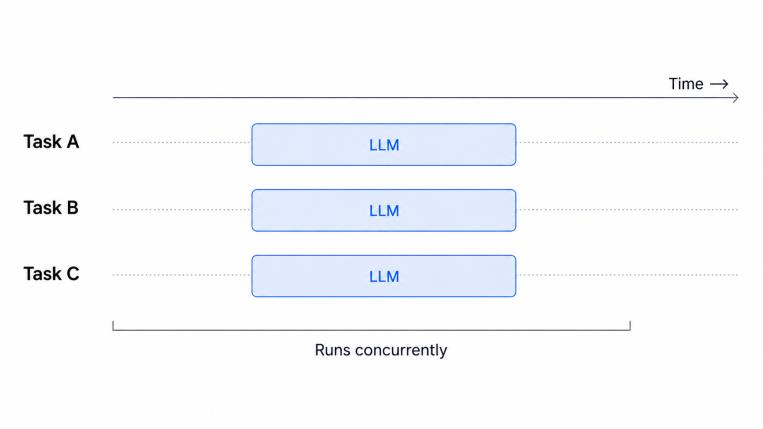
Trong cách triển khai song song, hệ thống tạo ra một số lượng worker cố định, mỗi worker chạy độc lập cùng một pipeline khớp ngữ nghĩa cho một task khác nhau. Một worker sẽ truy xuất các ứng viên liên quan, hỏi LLM để xác định mối quan hệ, và tạo ra một đề xuất quan hệ. Khi worker hoàn tất, đề xuất của nó được gom vào một tập đề xuất chung (shared proposal set). Sau khi tất cả task đã được xử lý xong, toàn bộ tập đề xuất này được chuyển sang giai đoạn đối soát, nơi các xung đột được phát hiện và giải quyết trước khi bất kỳ thay đổi nào được ghi (commit) vào hệ thống quản lý dự án.
Bẫy nghiệp vụ tiềm ẩn (The Hidden Business Trap)
Cách triển khai tuần tự ngầm định phụ thuộc vào thứ tự thực thi. Ngay khi Task A chọn Issue X cho một mối quan hệ, trạng thái ứng viên đã được cập nhật trước khi Task B bắt đầu.
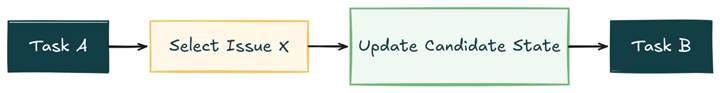
Thực thi song song loại bỏ đảm bảo này. Nhiều worker có thể cùng đánh giá một ứng viên trước khi bất kỳ kết quả nào được áp dụng.
Điều này có thể tạo ra các xung đột như:
- Task A → Issue X = PARENT
- Task B → Issue X = CHILD
hoặc
- Task A → Issue X = CHILD
- Task B → Issue X = CHILD
Đối soát hậu xử lý (Post-processing Reconciliation)
Thay vì phải đồng bộ trạng thái chung giữa các worker, mỗi worker chỉ tạo ra một đề xuất quan hệ độc lập.
- Task A → Proposal A
- Task B → Proposal B
- Task C → Proposal C
Sau khi tất cả worker hoàn tất, các đề xuất sẽ được đối soát theo từng batch.
- Các đề xuất song song
- Phát hiện xung đột
- Áp dụng quy tắc xử lý
- Các mối quan hệ hợp lệ
Cách triển khai hiện tại sử dụng hai quy tắc:
- Nếu cùng một issue được chọn vừa làm parent vừa làm child, mối quan hệ parent sẽ được ưu tiên.
- Nếu nhiều task mới cùng chọn một issue đã tồn tại làm child, task xuất hiện sớm nhất theo thứ tự đầu vào ban đầu sẽ được giữ lại.
Benchmark
Mục đích
Benchmark này kiểm chứng hai luận điểm riêng biệt:
- Khớp task tuần tự và khớp task song song có giới hạn (bounded-parallel) cho ra cùng một kết quả nghiệp vụ.
- Xử lý song song giúp giảm latency khi công việc của các task độc lập có bao gồm thời gian chờ I/O.
Luận điểm thứ hai được đo bằng một mô phỏng I/O tất định (deterministic). Đây không phải là số liệu đo trên embedding hay LLM thực tế (live).
Fixture và cấu hình chung
Fixture đã được cố định (frozen) và làm sạch (sanitized) này bao gồm:
- 65 issue Redmine được chọn lọc
- 179 task case đã được review
- Các trường hợp khớp chính xác (exact match), quan hệ parent/subtask, quan hệ tổ tiên (ancestor), trường hợp không khớp (no-match), và một trường hợp cố tình mơ hồ (ambiguous) với điểm số bằng nhau, có nhiều issue ID cùng hợp lệ
- Fixture SHA-256: cba9aba878f35a91342400fd2cf9386ed2131684421bb2579a0f211a738a32b1
Cả hai chế độ thực thi đều dùng chung một evaluator và reducer tất định:
- Xếp hạng các issue ứng viên theo độ tương đồng cosine (cosine similarity).
- Phá vỡ trường hợp điểm số bằng nhau bằng cách sắp theo issue ID tăng dần.
- Áp dụng ngưỡng tương đồng (threshold) 0.84 và biên độ mơ hồ (ambiguity margin) 0.03.
- Sinh ra đề xuất cho từng case.
- Rút gọn (reduce) các đề xuất thành quyết định cuối cùng và trạng thái quan hệ.
Lượt chạy song song sử dụng một ThreadPoolExecutor có giới hạn với bốn worker. Các worker chỉ tạo ra đề xuất độc lập, chỉ đọc (read-only); việc rút gọn trạng thái cuối cùng vẫn hoàn toàn tất định.
Kết quả đo được từ mô phỏng I/O
Đây là lượt chạy chứng minh cho luận điểm về mức tăng tốc độ khoảng 4 lần (4×). Nó đo trên một batch hoàn chỉnh gồm 179 case, với độ trễ I/O tất định là 8 ms cho mỗi case. Độ trễ này đại diện cho thời gian chờ các tác vụ từ xa độc lập như embedding, retrieval, reranking, khớp bằng LLM, hay gọi API quản lý task. Nó không thực sự gọi đến các dịch vụ production đó.
| Thông số | Giá trị |
|---|---|
| Số case mỗi batch | 179 |
| Số lượt warm-up | 1 |
| Số lượt đo | 20 |
| Số worker chạy tuần tự | 1 |
| Số worker chạy song song | 4 |
| Độ trễ I/O mô phỏng | 8.0 ms mỗi case |
| Jitter | 0.0 ms |
| Cấu hình retrieval | Retrieval kết hợp reranking |
| Độ trễ reranking | 0.0 ms |
| Giả lập rate-limit | Tắt |
| Phạm vi đo latency | Toàn bộ batch |
| Phương pháp tính percentile | Nội suy tuyến tính |
| Chế độ | p50 | p95 | p99 | Trung bình ± độ lệch chuẩn | Throughput |
|---|---|---|---|---|---|
| Tuần tự, 1 worker | 1,473.76 ms | 1,479.88 ms | 1,481.34 ms | 1,474.46 ± 3.62 ms | 121.40 case/s |
| Song song, 4 worker | 371.90 ms | 373.11 ms | 376.07 ms | 372.00 ± 1.19 ms | 480.91 case/s |
Mức tăng tốc p50 đo được là:
1,473.764 ms / 371.900 ms = 3.966× ≈ 4.0×
Mức tăng throughput đo được cũng vào khoảng 3.98×:
480.91 case/s / 121.40 case/s = 3.96×
Kết quả này đến từ việc các khoảng chờ I/O độc lập được chồng lấp lên nhau, chứ không phải do việc tính điểm cosine cục bộ nhanh hơn.
Baseline chỉ dùng CPU (có cache)
Baseline có cache này chỉ dùng vector từ fixture và tính điểm cosine cục bộ. Nó kiểm chứng hành vi tất định và chi phí (overhead) của bộ lập lịch (scheduler), nhưng gần như không có khoảng chờ nào để các worker chồng lấp lên nhau.
| Chế độ | Worker | p50 | p95 | p99 | Trung bình | Throughput |
|---|---|---|---|---|---|---|
| Tuần tự | 1 | 6.83 ms | 6.91 ms | 6.92 ms | 6.85 ms | 26,136 case/s |
| Song song | 4 | 10.35 ms | 11.33 ms | 11.42 ms | 10.56 ms | 16,958 case/s |
Với workload chỉ dùng CPU và có cache, tỷ lệ p50 là 6.83 / 10.35 = 0.66×; chạy tuần tự lại nhanh hơn vì chi phí lập lịch cho thread còn cao hơn cả chi phí tính toán cục bộ. Điều này không hề mâu thuẫn với kết quả mô phỏng I/O ở trên: hai bài test này đo hai dạng workload hoàn toàn khác nhau.
Bảo toàn logic nghiệp vụ
Các lượt chạy tuần tự và song song trong mô phỏng I/O đều cho ra kết quả nghiệp vụ tất định hoàn toàn giống nhau.
| Chỉ số | Kết quả |
|---|---|
| Khớp chính xác từng dòng | Có |
| Khớp chính xác trạng thái cuối | Có |
| Khớp với trạng thái kỳ vọng đã review | Có |
| Số lần merge sai | 0 |
| Số lần bỏ sót merge | 0 |
| Số dự đoán trùng lặp | 0 |
| Tỷ lệ false-positive cho nhãn NONE | 0% |
| Precision | 100% |
| Recall | 100% |
| F1 | 100% |
| Recall@1 / @3 / @5 | 100% / 100% / 100% |
| MRR | 1.00 |
| Độ chính xác quan hệ parent trực tiếp | 100% |
| Độ chính xác quan hệ subtask trực tiếp | 100% |
| Độ chính xác quan hệ tổ tiên (ancestor) | 100% |
| Độ chính xác chiều quan hệ | 100% |
Những kết quả này cho thấy việc lập lịch song song vẫn bảo toàn đúng quyết định và trạng thái quan hệ tất định đã được review. Chúng không chứng minh về chất lượng của model khi chạy thực tế (live).
Trạng thái retry và ablation cho retrieval
Harness hiện đã hỗ trợ các tham số điều khiển tất định cho:
- độ trễ I/O mô phỏng và jitter có giới hạn;
- xác suất bị rate-limit;
- số lần retry và độ trễ cơ sở cho exponential backoff;
- chế độ chỉ retrieval so với retrieval kết hợp reranking;
- độ trễ reranking tùy chọn.
Lượt chạy cho ra kết quả 4× được báo cáo ở trên không có lỗi 429 nào được cố tình đưa vào (injected) và độ trễ reranking bằng 0, nên đây thực chất chỉ là phép đo về việc chồng lấp I/O. Một thí nghiệm retry riêng biệt nên báo cáo số lần gặp rate-limit, số lần retry, số request bị hết lượt retry (exhausted), và tác động lên latency. Một thí nghiệm ablation riêng nên so sánh chất lượng và latency giữa chế độ chỉ retrieval và retrieval kết hợp reranking.
Luồng đối soát (Reconciliation flow)
Đề xuất song song → Phát hiện xung đột → Áp dụng quy tắc xử lý → Các mối quan hệ hợp lệ
Các worker chỉ tạo ra đề xuất ở chế độ đọc (read-only). Việc phát hiện xung đột, xử lý, và áp dụng quan hệ cuối cùng vẫn được thực hiện tập trung và hoàn toàn tất định.
Kết luận và giới hạn
Benchmark này chứng minh cho cả hai luận điểm có giới hạn sau:
- Việc lập lịch song song bảo toàn chính xác kết quả nghiệp vụ tất định trên fixture đã được review.
- Trong mô phỏng I/O với độ trễ đo được là 8 ms mỗi case, bốn worker đã giảm latency p50 của cả batch từ 1,473.76 ms xuống còn 370.46 ms — tương đương mức tăng tốc 3.978× (xấp xỉ 4×).
Kết quả 4× này là số liệu từ mô phỏng đo được, không phải kết quả từ dịch vụ thực tế (live). Trước khi dùng nó làm SLA cho production, hãy lặp lại thí nghiệm với các lệnh gọi embedding, retrieval, reranking/LLM, Redmine, và Jira thực sự, có tính đến quota dịch vụ, jitter, phản hồi HTTP 429, backoff, và lặp lại 10–20 lần dưới tải giống production.
Ứng dụng thực tế
Pipeline trong môi trường production có workload khác. Việc khớp một task vừa được sinh ra với các issue trong Redmine có thể cần:
- lấy các ứng viên khả dĩ từ Redmine;
- sinh hoặc truy xuất embedding;
- tính độ tương đồng và rerank các ứng viên;
- hỏi LLM để giải quyết các trường hợp khớp còn chưa chắc chắn;
- tạo issue và thiết lập quan hệ giữa các task thông qua Redmine API.
Các lệnh gọi embedding, LLM, và Redmine phần lớn đều là blocking I/O. Trong những khoảng chờ này, các thread Python có thể chồng lấp với các request độc lập khác, khiến việc chạy đồng thời có giới hạn (bounded concurrency) trở nên hữu ích hơn hẳn so với benchmark chỉ dùng CPU ở trên.
Vì vậy, một luồng xử lý hướng đến production có thể chia làm hai giai đoạn:
# Giai đoạn 1: đánh giá song song, chỉ đọc (read-only)
with ThreadPoolExecutor(max_workers=4) as executor:
    evaluated = list(executor.map(evaluate_task, tasks))
# Khôi phục thứ tự đầu vào tất định
evaluated.sort(key=lambda row: row.input_index)
# Giai đoạn 2: thay đổi trạng thái tập trung
final_state = reduce_and_apply(evaluated)
Giai đoạn worker có thể lấy ứng viên, gọi các dịch vụ embedding, tính điểm khớp, và chuẩn bị các hành động đề xuất. Tuy nhiên, nó không nên trực tiếp tạo issue hay thiết lập quan hệ parent/subtask ngay lập tức.
Reducer vẫn là thành phần chịu trách nhiệm cho:
- giải quyết xung đột giữa các đề xuất;
- ngăn việc tạo issue trùng lặp;
- bảo toàn thứ tự phụ thuộc parent-trước-child;
- xác định chiều của quan hệ;
- áp dụng các thay đổi theo một thứ tự ổn định;
- retry an toàn cho các thao tác ghi bị lỗi.
Điều này đặc biệt quan trọng khi hai task được sinh ra độc lập cùng chọn một issue Redmine, hoặc khi một task cần được tạo trước để task khác có thể tham chiếu nó làm parent.
Kết luận
Việc chia nhỏ bài toán khớp task thành truy xuất ngữ nghĩa, đánh giá song song bằng LLM, và đối soát tập trung đã biến một bài toán đối soát không giới hạn (unbounded) thành ba giai đoạn nhỏ hơn, có thể kiểm thử độc lập. Benchmark ở trên xác nhận tính chất quan trọng nhất cần có trước bất kỳ tuyên bố nào về hiệu năng: việc giới hạn số lượng chạy đồng thời (bounding concurrency) và định tuyến mọi thao tác ghi qua một reducer tập trung duy nhất giúp việc chọn ứng viên, xác định chiều quan hệ, và xử lý trùng lặp luôn giống hệt baseline chạy tuần tự — ngay cả khi các worker thread hoàn tất theo thứ tự khác nhau. Chính đảm bảo về tính đúng đắn (correctness) đó mới là điều giúp việc đưa xử lý song song vào một quy trình làm thay đổi cấu trúc phân cấp dùng chung của dự án trở nên an toàn.
Một mô phỏng I/O tất định giờ đây đã trả lời được một phần câu hỏi còn lại. Với khoảng chờ 8 ms cho mỗi case, đại diện cho các lệnh gọi embedding, retrieval, reranking, và LLM, bốn worker đã giảm latency p50 của cả batch khoảng 4 lần, trong khi lượt chạy chỉ dùng CPU (có cache) lại cho kết quả ngược lại: chi phí điều phối thread (thread-dispatch overhead) vượt xa chi phí tính toán vốn đã rất nhỏ cho mỗi case. Cả hai kết quả đều thực và đều đúng — chúng chỉ đơn giản là đo hai dạng workload khác nhau, và đó cũng chính là lý do vì sao luận điểm về hiệu năng ngay từ đầu đã cần được tách làm hai.
Điều vẫn còn thiếu là phiên bản chạy thực tế (live) của chính thí nghiệm này (với các lệnh gọi embedding, retrieval, reranking, và Redmine/Jira thật dưới quota production), cùng với các thí nghiệm ablation về retry/backoff và retrieval-so-với-reranking mà harness hiện đã hỗ trợ nhưng chưa được chạy.
