
Khi làm việc với PostgreSQL, chúng ta thường tập trung vào schema, index hay tối ưu câu query cho nhanh. Nhưng có một câu hỏi ít khi được đặt ra - cho đến khi hệ thống có nhiều người dùng truy cập đồng thời: khi hai transaction cùng đọc và ghi một dòng dữ liệu, bạn thực sự đang nhìn thấy phiên bản nào?
Trong bài này, mình sẽ cùng bạn đi vào MVCC (Multi-Version Concurrency Control) - cơ chế đứng sau câu trả lời đó. Mục tiêu không chỉ là biết MVCC là gì, mà là hiểu vì sao PostgreSQL cho bạn thấy đúng phiên bản dữ liệu ấy: qua xmin/xmax, snapshot và isolation level, cùng cái giá phải trả là dead tuple và VACUUM. Tất cả demo trong bài chạy trên vDB PostgreSQL Cluster của GreenNode.
1. Bài toán: nhiều session cùng đọc và ghi một dòng
Giả sử bảng users có một dòng dữ liệu với id = 1, name = 'Bob'. Hai session đang đồng thời thao tác trên dòng dữ liệu này.
Session A cập nhật tên từ Bob thành Alice, nhưng chưa COMMIT transaction:
BEGIN;
UPDATE users SET name = 'Alice' WHERE id = 1;
-- Chưa COMMIT
Session B muốn đọc tên của người dùng này trong cùng thời điểm:
SELECT name FROM users WHERE id = 1;Lúc này, có hai câu hỏi cần được làm rõ:
- Session B có phải chờ Session A hoàn tất transaction hay không?
- Nếu không phải chờ, Session B sẽ đọc được giá trị nào: Bob hay Alice?
1.1. Naive solution: Lock
Một cách tiếp cận đơn giản để kiểm soát xung đột giữa các session là sử dụng lock.
- Session A cập nhật một dòng dữ liệu và giữ lock cho đến khi transaction kết thúc.
- Session B muốn đọc dòng dữ liệu đó thì có thể phải chờ A nhả lock.
Ưu điểm: Lock giúp kiểm soát các thao tác xung đột, bảo vệ tính nhất quán của dữ liệu.
Nhược điểm: Các transaction có thể chặn lẫn nhau. Khi số lượng thao tác đồng thời tăng lên, thời gian chờ lock có thể trở thành nút thắt cổ chai, làm giảm khả năng xử lý của hệ thống.
Vậy có cách nào để Session B vẫn đọc được dữ liệu mà không phải chờ Session A hoàn tất việc cập nhật?
1.2. MVCC
PostgreSQL triển khai cơ chế MVCC (Multi-Version Concurrency Control). Thay vì buộc các thao tác đọc và ghi phải chờ nhau trong mọi trường hợp, MVCC cho phép nhiều phiên bản của cùng một dòng dữ liệu cùng tồn tại.
Ý tưởng chính:
- Một dòng dữ liệu có thể tồn tại dưới nhiều phiên bản.
- Khi UPDATE, PostgreSQL tạo phiên bản mới; phiên bản cũ vẫn được giữ lại cho những ai còn cần đọc nó.
- PostgreSQL dựa vào trạng thái transaction để xác định phiên bản dữ liệu mà mỗi truy vấn nhìn thấy được.
Nghe có vẻ hơi khó hiểu, đúng không? Hãy quay lại ví dụ ban đầu để xem cơ chế này hoạt động như thế nào.
- Session A cập nhật
nametừ Bob thành Alice. Phiên bản mới được tạo ra, nhưng transaction của A chưa COMMIT. - Session B thực hiện SELECT. Vì thay đổi của A chưa được COMMIT nên B không nhìn thấy phiên bản Alice. Thay vào đó, B đọc được phiên bản đã COMMIT trước đó là Bob.
- Session B không phải chờ Session A chỉ để đọc dòng dữ liệu này.
Với các thao tác thông thường trong PostgreSQL, đọc thường không chặn ghi và ghi thường không chặn đọc. MVCC giúp giảm xung đột giữa hai loại thao tác này, trong khi lock vẫn được dùng để kiểm soát các thao tác có xung đột.
2. PostgreSQL chọn phiên bản nào để cho bạn xem?
2.1. Dữ liệu trong thế giới song song
Trước hết cần phân biệt ba khái niệm:
- Row: thứ mà ứng dụng nhìn thấy. Ví dụ, user có
id = 1. Dù được sửa bao nhiêu lần, ứng dụng vẫn coi đó là một dòng dữ liệu. - Tuple: một phiên bản lưu trữ của dòng dữ liệu đó. Mỗi lần UPDATE, PostgreSQL thường tạo một tuple mới để lưu phiên bản mới của dòng.
- Heap: nơi PostgreSQL lưu các tuple của một bảng. Có thể hình dung heap là một cuốn sổ, mỗi tuple là một bản ghi trong sổ.
Vậy một dòng có thể có nhiều tuple:
Dòng id = 1 (ứng dụng chỉ thấy 1 dòng)
│
├── tuple 1: Bob       (phiên bản cũ)
├── tuple 2: Alice     (phiên bản sau lần UPDATE thứ nhất)
└── tuple 3: Charlie   (phiên bản sau lần UPDATE thứ hai)
Các phiên bản cũ và mới của một dòng có thể cùng tồn tại trong heap. PostgreSQL sẽ xác định phiên bản phù hợp để hiển thị cho mỗi lần đọc.
2.2. xmin, xmax
Mỗi tuple có các thông tin hệ thống mà PostgreSQL dùng để quản lý phiên bản dữ liệu. Hai thông tin quan trọng là:
xmin: mã transaction tạo ra phiên bản tuple này.xmax: thông tin về transaction đã xóa hoặc thay thế tuple này.
Ví dụ 1: Cập nhật dữ liệu (UPDATE). Transaction 105 cập nhật Bob thành Alice:
UPDATE users
SET name = 'Alice'
WHERE name = 'Bob';
Trong trường hợp đơn giản, PostgreSQL tạo phiên bản tuple mới và đánh dấu phiên bản cũ:
Tuple cũ                  Tuple mới
xmin = 100                xmin = 105
xmax = 105                xmax = 0
name = Bob name = Alice- Tuple cũ có
xmax = 105: transaction 105 đánh dấu tuple này trong quá trình cập nhật. - Tuple mới có
xmin = 105: transaction 105 tạo ra phiên bản tuple mới. xmax = 0thường cho biết tuple chưa bị đánh dấu xóa hoặc thay thế.
Ví dụ 2: Xóa dữ liệu (DELETE). Transaction 120 xóa dòng có tên Bob:
DELETE FROM users
WHERE name = 'Bob';
Tuple Bob được đánh dấu xmax = 120 nhưng chưa biến mất ngay khỏi heap.
Quan sát các thông tin hệ thống. Bạn có thể tự kiểm chứng bằng các cột hệ thống xmin và xmax.
Bước 1: Chuẩn bị dữ liệu:
CREATE TABLE users (id int PRIMARY KEY, name text);
INSERT INTO users VALUES (1, 'Bob');
Bước 2: Xem tuple ban đầu:
SELECT ctid, xmin, xmax, * FROM users;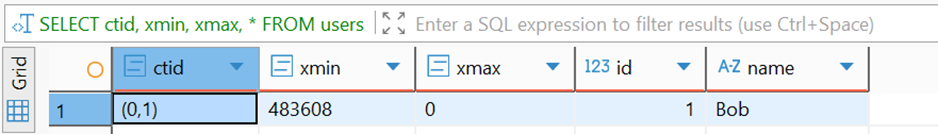
Bước 3: UPDATE rồi xem lại:
UPDATE users SET name = 'Alice' WHERE id = 1;
SELECT ctid, xmin, xmax, * FROM users;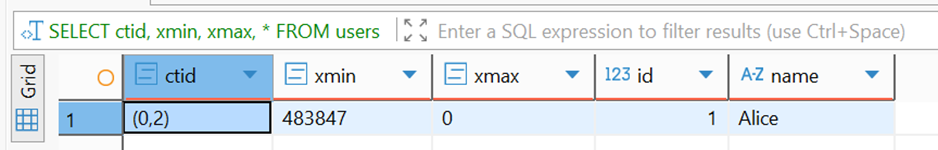
xminđổi từ 483608 sang 483847 vì đây là tuple mới, do một transaction khác tạo ra.ctidlà vị trí của tuple trong heap, đổi từ (0,1) sang (0,2) vì tuple mới được ghi vào chỗ khác.- Câu lệnh chỉ hiện các tuple mà bạn nhìn thấy, không hiện các phiên bản cũ.
2.3. Snapshot
Khi đọc dữ liệu, PostgreSQL dùng một snapshot - có thể hình dung như một tấm ảnh chụp cho biết lúc đó transaction nào đã COMMIT, transaction nào chưa. PostgreSQL so xmin, xmax của từng tuple với snapshot này để quyết định tuple nào được nhìn thấy.
Quy trình đơn giản hóa:
Query
→ Xác định snapshot
→ Xét trạng thái transaction liên quan đến tuple
→ Áp dụng quy tắc visibility
→ Trả về phiên bản có thể nhìn thấy
Áp dụng vào ví dụ ban đầu:
- Phiên bản Alice do transaction A tạo ra chưa được COMMIT, nên Session B chưa thể nhìn thấy phiên bản này.
- Phiên bản Bob chưa bị thay thế bởi một transaction đã COMMIT, nên Session B vẫn có thể nhìn thấy phiên bản này.
Kết quả: B đọc được Bob. Khi A COMMIT, các truy vấn sau đó có thể nhìn thấy Alice, tùy thuộc vào isolation level và thời điểm snapshot được xác định.
2.4. Isolation level
Isolation level quyết định cách một transaction nhìn thấy những thay đổi do transaction khác thực hiện. Trong PostgreSQL, READ COMMITTED và REPEATABLE READ khác nhau chủ yếu ở cách xác định và sử dụng snapshot.
READ COMMITTED (mặc định):
- Mỗi câu lệnh thường sử dụng một snapshot mới.
- Trong cùng một transaction, hai câu SELECT liên tiếp có thể trả về dữ liệu khác nhau nếu transaction khác COMMIT ở giữa.
REPEATABLE READ:
- Các câu lệnh trong cùng transaction sử dụng chung một snapshot, được chụp ở câu lệnh đầu tiên.
- Đọc lại bao nhiêu lần cũng thấy cùng dữ liệu, kể cả khi transaction khác đã COMMIT thay đổi mới.
Ví dụ: ban đầu dòng id = 1 có tên Bob. Session B mở transaction, đọc hai lần, ở giữa Session A đổi tên thành Alice và COMMIT.
| Bước | Session A | Session B | B thấy gì (READ COMMITTED) | B thấy gì (REPEATABLE READ) |
|---|---|---|---|---|
| 1 | BEGIN ISOLATION LEVEL <level>; | |||
| 2 | SELECT name FROM users WHERE id = 1; | Bob | Bob | |
| 3 | UPDATE ... SET name = 'Alice' ...; COMMIT; | |||
| 4 | SELECT name FROM users WHERE id = 1; | Alice | Bob |
- Với READ COMMITTED, câu SELECT ở bước 4 chụp snapshot mới, lúc này A đã COMMIT nên B thấy Alice.
- Với REPEATABLE READ, B vẫn dùng snapshot chụp ở bước 2 nên vẫn thấy Bob.
3. Trade-off: dead tuple và VACUUM
3.1. Phiên bản cũ đi đâu?
UPDATE
↓
Tạo tuple mới  +  Đánh dấu tuple cũ
↓
Tuple cũ không còn cần thiết
↓
VACUUM có thể dọn dẹp- Sau UPDATE hoặc DELETE, tuple cũ không bị loại bỏ ngay. PostgreSQL giữ lại phiên bản này nếu vẫn có transaction cần đọc nó.
- Tuple cũ không còn transaction nào cần gọi là dead tuple. PostgreSQL dọn dẹp chúng bằng VACUUM.
- Trước khi được dọn dẹp, tuple cũ vẫn chiếm không gian trong heap.
Ví dụ: bảng có 1 triệu dòng. Nếu UPDATE cả 1 triệu dòng và mỗi dòng tạo một phiên bản mới, heap có thể chứa khoảng 2 triệu phiên bản tuple trước khi dọn dẹp — 1 triệu phiên bản cũ và 1 triệu phiên bản mới. Bảng to gần gấp đôi dù số dòng không đổi.
3.2. Người dọn dẹp
Dead tuple
↓
VACUUM
↓
Không gian có thể tái sử dụng
VACUUM:
- Dọn dẹp các dead tuple mà PostgreSQL xác định không còn cần thiết cho các transaction đang hoạt động.
- Giải phóng không gian để PostgreSQL có thể tái sử dụng cho dữ liệu mới.
VACUUM thông thường không làm giảm dung lượng file dữ liệu trên ổ đĩa. Nó chủ yếu giúp tái sử dụng không gian trống, hạn chế việc bảng liên tục mở rộng khi dữ liệu được thêm mới hoặc cập nhật.
Autovacuum là VACUUM chạy tự động, bạn không cần chạy thủ công.
VACUUM FULL khác với VACUUM thông thường: nó viết lại bảng để thu hồi không gian trống và giảm dung lượng file dữ liệu trên ổ đĩa. Tuy nhiên, thao tác này cần lock cả bảng - trong lúc chạy không ai đọc hoặc ghi được bảng đó.
Demo: bảng phình to và VACUUM
Bước 0: Chuẩn bị môi trường demo. Các demo trong bài chạy trên vDB PostgreSQL Cluster của GreenNode. Bạn tạo một PostgreSQL Cluster trên portal, vào tab Connectivity & Security để lấy endpoint của Primary (Read/Write), rồi nhập endpoint cùng user name và password của master user vào client (psql hoặc công cụ bạn quen dùng) để kết nối:
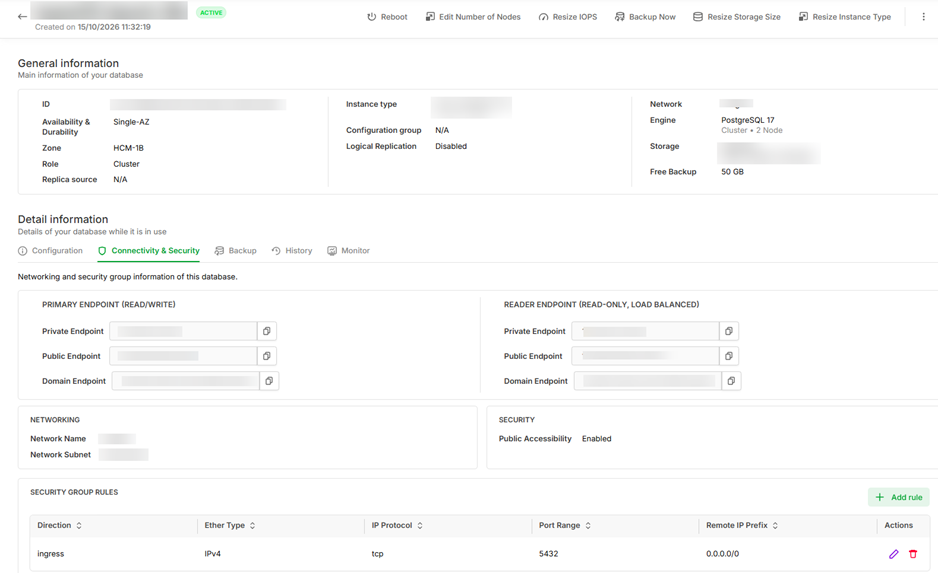
Mỗi loại endpoint có Private, Public và Domain. Client nằm cùng network với cluster thì dùng Private hoặc Domain (nếu VPC của bạn có bật DNS); kết nối từ máy bên ngoài thì dùng Public hoặc Domain.
Bước 1: Chuẩn bị dữ liệu. Tạo bảng 1 triệu dòng, tắt autovacuum trên bảng này để kịp quan sát dead tuple:
CREATE TABLE bloat_demo (id int, val text) WITH (autovacuum_enabled = off);
INSERT INTO bloat_demo SELECT g, 'v' || g FROM generate_series(1, 1000000) g;
Câu truy vấn dưới đây dùng để xem dung lượng bảng và số dead tuple, sẽ chạy lại sau mỗi bước:
SELECT pg_size_pretty(pg_relation_size('bloat_demo')) AS size,
       (SELECT n_dead_tup FROM pg_stat_user_tables WHERE relname = 'bloat_demo') AS dead;
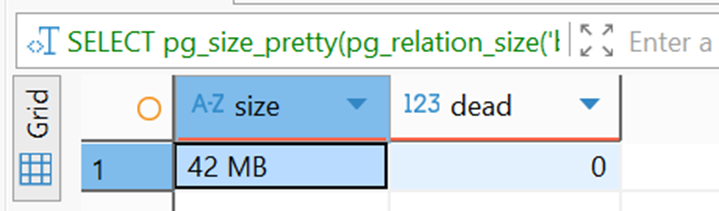
Bước 2: Xem trạng thái ban đầu. Bảng 1 triệu dòng chiếm 42 MB, chưa có dead tuple.
Bước 3: UPDATE toàn bộ bảng:
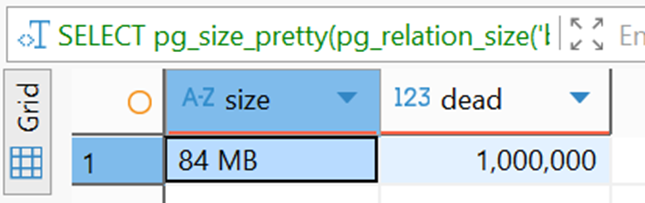
UPDATE bloat_demo SET val = val || '!';Chạy lại câu truy vấn kiểm tra: dung lượng tăng từ 42 MB lên 84 MB và xuất hiện 1.000.000 dead tuple.
Bước 4: VACUUM:
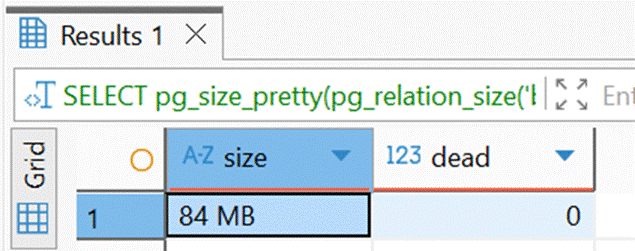
VACUUM bloat_demo;Dead tuple về 0 nhưng dung lượng vẫn là 84 MB — chỗ trống được giữ lại để tái sử dụng.
Bước 5: VACUUM FULL:
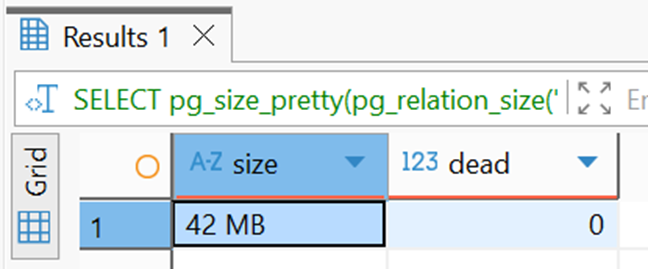
VACUUM FULL bloat_demo;Dung lượng giảm về 42 MB như ban đầu.
3.3. Long running transaction
Theo nguyên tắc, PostgreSQL chỉ có thể dọn một phiên bản tuple khi chắc chắn phiên bản đó không còn cần thiết đối với các snapshot liên quan.
Vì vậy, một transaction chạy quá lâu có thể gây ra vấn đề. Transaction này giữ snapshot cũ, nên PostgreSQL chưa thể dọn những tuple cũ mà snapshot đó có thể cần. Autovacuum vẫn chạy bình thường nhưng không dọn được những tuple này. Dead tuple tích tụ, khiến bảng phình to và truy vấn chậm dần.
Demo: transaction dài chặn VACUUM (dùng lại bảng bloat_demo ở mục 3.2).
Bước 1: Session A mở transaction dài, đọc dữ liệu rồi để đó, không COMMIT:
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) FROM bloat_demo;
Bước 2: Session B tạo dead tuple:
UPDATE bloat_demo SET val = val || '?';Bước 3: Session B chạy VACUUM:
VACUUM VERBOSE bloat_demo;Kết quả VACUUM VERBOSE (đã rút gọn):
vacuuming "database_1.public.bloat_demo"
...
tuples: 0 removed, 2000000 remain, 1000000 are dead but not yet removable
...
0 removed: VACUUM không dọn được tuple nào.1000000 are dead but not yet removable: 1 triệu dead tuple vẫn phải giữ lại vì Session A còn có thể cần đến chúng.
Bước 4: Tìm transaction đang chạy lâu:
SELECT pid, state, now() - xact_start AS duration, query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;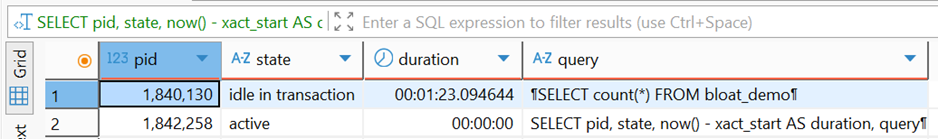
Session A ở trạng thái idle in transaction đã 1 phút 23 giây. Transaction vẫn mở nhưng không làm gì, và chính nó đang giữ snapshot cũ.
Bước 5: Session A COMMIT, Session B chạy lại VACUUM:
-- Session A
COMMIT;

-- Session B
VACUUM VERBOSE bloat_demo;
Kết quả VACUUM VERBOSE (đã rút gọn):
vacuuming "database_1.public.bloat_demo"
...
tuples: 1000000 removed, 1000000 remain, 0 are dead but not yet removable
...
Ngay sau khi Session A COMMIT, VACUUM dọn được toàn bộ 1 triệu dead tuple.
4. Tổng kết
- MVCC cho phép một dòng dữ liệu tồn tại nhiều phiên bản.
- Snapshot,
xminvàxmaxgiúp PostgreSQL xác định phiên bản nào có thể được nhìn thấy. - UPDATE tạo phiên bản mới thay vì ghi đè trực tiếp lên phiên bản cũ.
- Dead tuple là các phiên bản cũ cần được dọn dẹp khi không còn cần thiết.
- VACUUM dọn dead tuple; Autovacuum tự động thực hiện công việc này.
- Transaction kéo dài có thể cản trở VACUUM, khiến dead tuple tích tụ và bảng phình to.
- MVCC không thay thế lock: nhiều transaction cùng sửa một dòng vẫn có thể phải chờ nhau, nhưng MVCC giúp các thao tác đọc thông thường không phải chờ ghi và ngược lại.
