
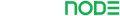
Với phần lớn doanh nghiệp, nền tảng ML được quản lý (managed ML platform) là điểm khởi đầu hợp lý. Đây là dạng nền tảng cung cấp sẵn notebook, training job, model tuning và endpoint inference, để đội ngũ phát triển mô hình mà không phải tự vận hành hạ tầng, ví dụ như GreenNode AI Platform. Chi phí thường tính theo mức sử dụng, phù hợp với giai đoạn thử nghiệm và POC.
Nhưng khi mô hình đi vào vận hành, workload thay đổi. Dữ liệu lớn hơn, job chạy dài hơn, inference chạy liên tục và yêu cầu về bảo mật, tuân thủ chặt hơn. Đến một lúc, câu hỏi không còn là "nền tảng có đáp ứng được không" mà là "có nên kiểm soát trực tiếp hạ tầng GPU hay không".
Bài viết phân tích 6 dấu hiệu doanh nghiệp nên chuyển từ nền tảng ML được quản lý sang GPU instance riêng, những trường hợp chưa cần chuyển đổi, cùng checklist và lộ trình triển khai giúp doanh nghiệp đưa ra quyết định phù hợp.
Nền tảng ML được quản lý và GPU instance khác nhau thế nào?
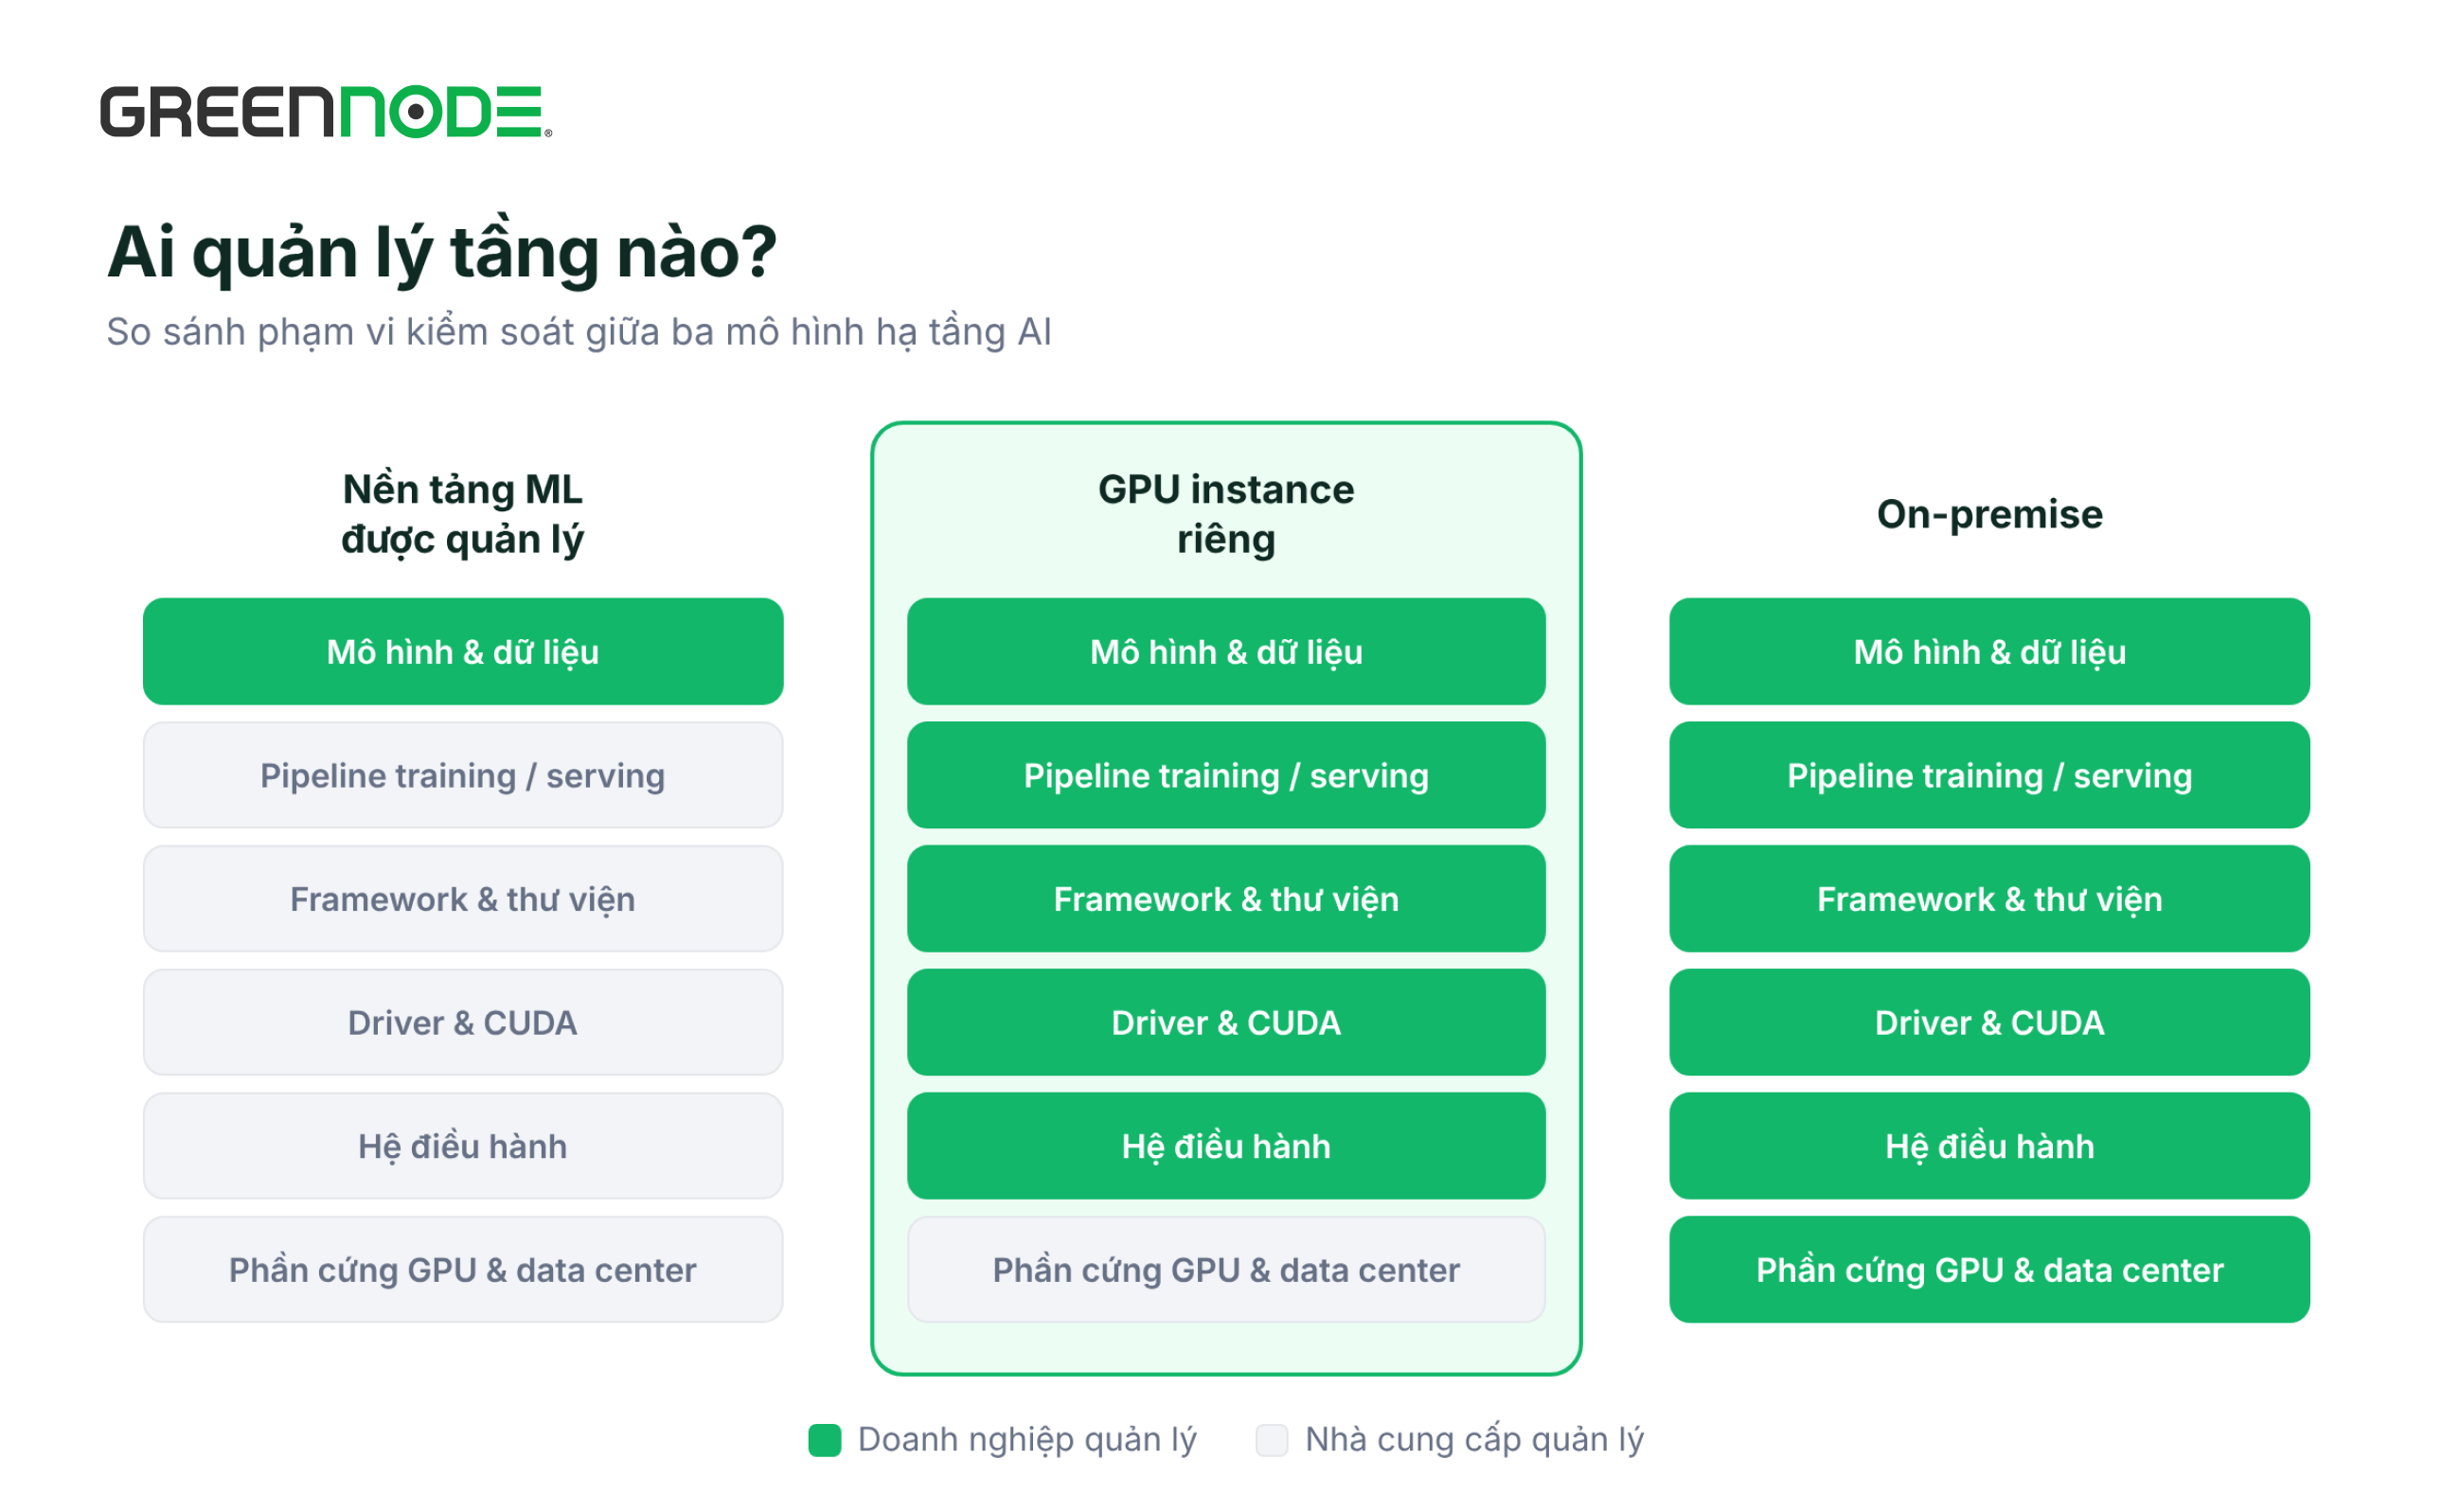
Khác biệt cốt lõi nằm ở mức kiểm soát: nền tảng ML được quản lý vận hành hạ tầng thay bạn, còn GPU instance riêng giao toàn quyền server GPU cho đội ngũ của bạn.
"GPU instance riêng" trong bài này là tài nguyên GPU được dành riêng trên hạ tầng cloud: doanh nghiệp toàn quyền phần mềm, còn phần cứng vẫn do nhà cung cấp vận hành. Đây không phải mô hình on premises, nơi doanh nghiệp tự mua GPU và đặt tại data center của mình.
| Tiêu chí | Nền tảng ML được quản lý | GPU instance riêng |
|---|---|---|
| Mức kiểm soát | Theo các thành phần nền tảng cung cấp (notebook, training job, tuning, registry, endpoint) | Toàn quyền: hệ điều hành, driver, CUDA, framework, scheduler |
| Vận hành | Nền tảng lo hạ tầng | Đội ngũ tự vận hành (hoặc kết hợp Kubernetes) |
| Mô hình chi phí | Pay-as-you-go theo mức sử dụng | Thuê theo tháng, chi phí cố định và dễ dự báo |
| Phù hợp nhất | Thử nghiệm, POC, fine-tune theo đợt, team ML nhỏ | Workload chạy liên tục, training dài ngày, stack tùy biến sâu |
| Công sức ban đầu | Thấp, có thể bắt đầu ngay | Cao hơn, cần người hiểu hạ tầng |
Trên thị trường, GPU instance riêng thường được triển khai dưới hai hình thức: máy chủ ảo gắn GPU chuyên dụng (GPU VM) và máy chủ vật lý dành riêng (GPU bare metal). Cả hai đều cho phép doanh nghiệp truy cập trực tiếp tài nguyên GPU và chủ động cấu hình môi trường triển khai.
Hai lựa chọn không nhất thiết thay thế nhau. Doanh nghiệp có thể dùng song song để đáp ứng nhu cầu của từng workload trong vòng đời phát triển AI.
6 dấu hiệu doanh nghiệp nên chuyển sang GPU instance riêng
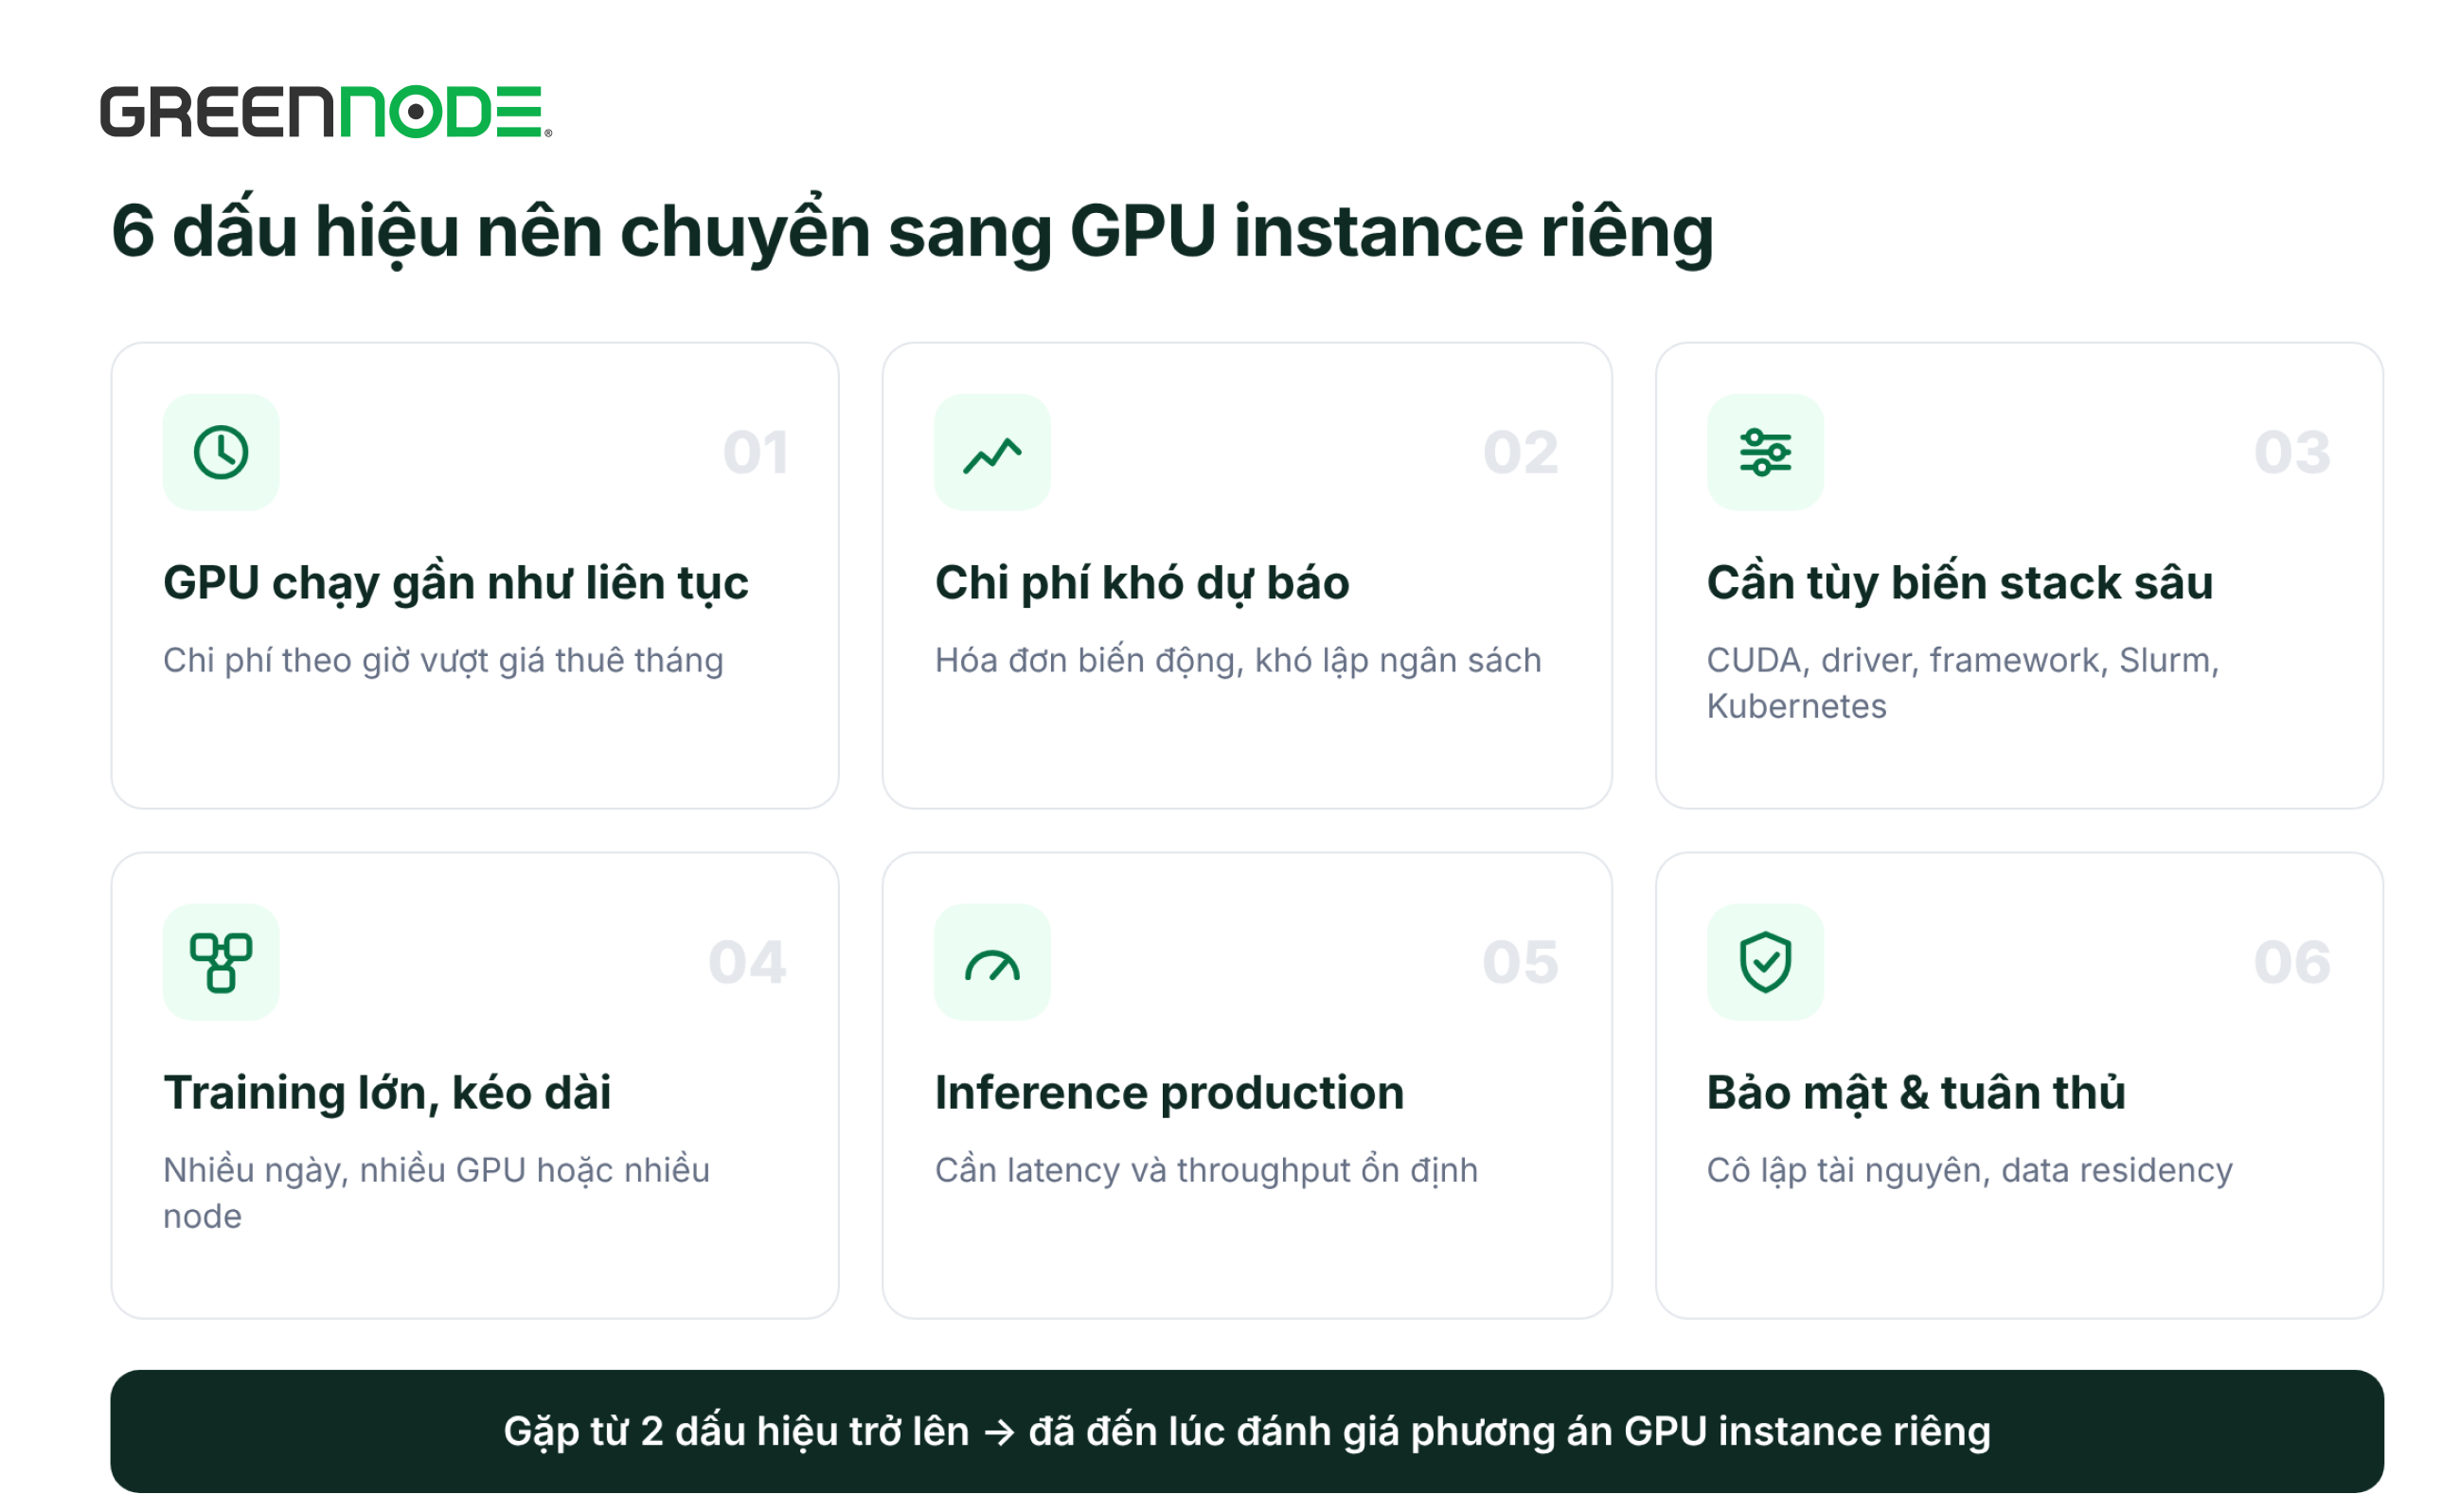
Khi ứng dụng AI mở rộng quy mô, mô hình hạ tầng phù hợp ở giai đoạn thử nghiệm có thể không còn tối ưu về chi phí, hiệu năng hoặc khả năng kiểm soát. Nếu doanh nghiệp gặp từ hai dấu hiệu trở lên dưới đây, đã đến lúc đánh giá nghiêm túc phương án thuê GPU instance riêng.
1. Tần suất sử dụng GPU cao và liên tục
Mô hình pay-as-you-go của nền tảng ML được quản lý mang lại lợi thế khi GPU chỉ được sử dụng theo từng đợt hoặc trong thời gian ngắn.
Tuy nhiên, khi các tác vụ training, fine-tuning hoặc inference chiếm phần lớn thời gian trong tháng, chi phí tính theo mức sử dụng có thể vượt mức giá thuê GPU instance theo tháng.
Doanh nghiệp nên đối chiếu tổng thời gian sử dụng GPU và chi phí thực tế trong 2–3 tháng gần nhất với chi phí thuê GPU instance có cấu hình tương đương, đồng thời tính đến các chi phí vận hành phát sinh.
Nếu nhu cầu sử dụng GPU đã ổn định ở mức cao, GPU instance riêng có thể mang lại hiệu quả chi phí tốt hơn trong dài hạn.
2. Chi phí hạ tầng AI ngày càng khó dự báo
Khi AI trở thành một phần trong hoạt động kinh doanh, khả năng dự báo chi phí hạ tầng đóng vai trò quan trọng trong việc lập ngân sách và kiểm soát hiệu quả đầu tư.
Với nền tảng ML được quản lý, chi phí có thể biến động theo thời gian training, khối lượng inference hoặc mức độ sử dụng tài nguyên. Điều này khiến doanh nghiệp gặp khó khăn trong việc xây dựng ngân sách khi workload ngày càng mở rộng.
GPU instance thuê theo tháng giúp doanh nghiệp ổn định chi phí tài nguyên GPU, chủ động lập kế hoạch ngân sách và dự báo chi phí hạ tầng khi mở rộng các ứng dụng AI.
3. Workload yêu cầu tùy biến môi trường GPU chuyên sâu
Khi ứng dụng AI trở nên phức tạp hơn, đội ngũ kỹ thuật có thể cần những cấu hình vượt ngoài phạm vi môi trường được nền tảng hỗ trợ sẵn, chẳng hạn như:
- Phiên bản CUDA hoặc GPU driver cụ thể.
- Framework và thư viện AI được tùy chỉnh.
- Công cụ tối ưu hiệu năng inference.
- Hệ thống điều phối tài nguyên như Slurm hoặc Kubernetes.
Khi môi trường được quản lý sẵn bắt đầu giới hạn khả năng triển khai và tối ưu mô hình, GPU instance riêng cho phép doanh nghiệp chủ động xây dựng software stack phù hợp với yêu cầu kỹ thuật của từng workload.
4. Training mô hình quy mô lớn và kéo dài
Training mô hình AI quy mô lớn hoặc fine-tuning trên bộ dữ liệu doanh nghiệp có thể kéo dài nhiều ngày, sử dụng đồng thời nhiều GPU hoặc nhiều node.
Những workload này thường yêu cầu tài nguyên tính toán ổn định, kết nối tốc độ cao giữa các GPU và khả năng chủ động quản lý checkpoint, khôi phục training job khi xảy ra gián đoạn.
GPU instance riêng với tài nguyên chuyên dụng và các công nghệ kết nối hiệu năng cao như NVIDIA NVLink và InfiniBand (trên những cấu hình tương thích) giúp doanh nghiệp tối ưu distributed training, đồng thời tăng khả năng kiểm soát quá trình huấn luyện mô hình.
5. Inference production yêu cầu hiệu năng ổn định
Khi mô hình AI được tích hợp vào các ứng dụng phục vụ khách hàng thực tế như chatbot, xử lý tài liệu hay chấm điểm tín dụng, hiệu năng inference ảnh hưởng trực tiếp đến trải nghiệm người dùng và chất lượng dịch vụ.
Doanh nghiệp cần duy trì các chỉ số như độ trễ (latency), thông lượng (throughput) và khả năng đáp ứng trong giờ cao điểm.
GPU instance riêng cho phép doanh nghiệp chủ động phân bổ tài nguyên GPU, hạn chế cạnh tranh tài nguyên với các workload khác và tinh chỉnh cấu hình model serving theo yêu cầu hiệu năng thực tế. Đây là lợi thế đáng cân nhắc với các ứng dụng AI production có lưu lượng ổn định và yêu cầu hiệu năng cao.
6. Yêu cầu bảo mật và tuân thủ ngày càng cao
Các doanh nghiệp trong lĩnh vực tài chính, ngân hàng, bảo hiểm (BFSI) và y tế thường phải đáp ứng những yêu cầu khắt khe về bảo mật dữ liệu và quản trị hạ tầng AI.
Doanh nghiệp không chỉ cần xác định dữ liệu được lưu trữ và xử lý ở đâu, mà còn phải kiểm soát quyền truy cập, mức độ cô lập tài nguyên và môi trường triển khai mô hình.
GPU instance riêng cung cấp tài nguyên GPU dành riêng, cho phép doanh nghiệp chủ động thiết lập các cơ chế bảo mật, phân quyền và giám sát theo chính sách nội bộ. Kết hợp với việc lựa chọn vị trí triển khai phù hợp, doanh nghiệp tăng khả năng kiểm soát hạ tầng AI và đáp ứng tốt hơn các yêu cầu về lưu trú dữ liệu (data residency) và tuân thủ.
Khi nào doanh nghiệp chưa cần chuyển sang GPU instance riêng?
Mặc dù GPU instance riêng mang lại nhiều lợi thế về khả năng kiểm soát và tối ưu hạ tầng, chuyển đổi quá sớm có thể làm tăng chi phí và gánh nặng vận hành không cần thiết. Doanh nghiệp nên tiếp tục sử dụng nền tảng ML được quản lý trong các trường hợp sau:
- Workload chưa ổn định: GPU chỉ chạy vài ngày mỗi tháng cho thử nghiệm hoặc fine-tune định kỳ.
- Chưa có đội ngũ vận hành hạ tầng: GPU instance riêng đòi hỏi đội ngũ quản lý driver, bảo mật, giám sát và xử lý sự cố.
- Use case chưa được chứng minh: cam kết chi phí cố định khi POC chưa có kết quả làm tăng rủi ro ngân sách.
- Nhu cầu chính là gọi mô hình có sẵn: nếu chỉ cần gọi LLM qua API, dịch vụ serverless inference có thể phù hợp hơn cả hai phương án trên.
Checklist ra quyết định và lộ trình chuyển đổi
Trả lời 5 câu hỏi sau trước khi quyết định. Càng nhiều câu "có", phương án GPU instance riêng càng hợp lý.
| Câu hỏi | Người trả lời |
|---|---|
| GPU có được sử dụng trong phần lớn thời gian của tháng không? | ML Engineer |
| Chi phí GPU trong 3 tháng gần nhất có cao hơn tổng chi phí thuê GPU instance ở cấu hình tương đương không? | CTO / Tài chính |
| Workload có yêu cầu tùy biến driver, CUDA, framework hoặc scheduler không? | ML Engineer |
| Doanh nghiệp có yêu cầu cao hơn về cô lập tài nguyên, bảo mật hoặc lưu trú dữ liệu không? | CTO / IT Architect |
| Đã có đội ngũ chịu trách nhiệm vận hành và quản lý môi trường GPU chưa? | CTO |
Lộ trình chuyển đổi khuyến nghị, giảm rủi ro gián đoạn:
- Đo lường hiện trạng: thống kê giờ GPU, loại GPU, chi phí và các điểm nghẽn của 2–3 tháng gần nhất.
- Chọn workload chuyển trước: ưu tiên workload chạy liên tục và ổn định nhất, thường là inference production hoặc training định kỳ lớn.
- Chọn loại GPU phù hợp: H200 cho training mô hình lớn và LLM ngữ cảnh dài; H100 cho training và inference phổ biến; RTX PRO 6000 Blackwell cho inference và fine-tune mô hình 13B–70B với chi phí thấp hơn.
- Chạy song song: giữ nền tảng ML được quản lý cho thử nghiệm, chuyển dần workload ổn định sang GPU instance riêng và so sánh hiệu năng, chi phí.
- Chuẩn hóa vận hành: thiết lập giám sát, phân quyền truy cập, sao lưu checkpoint và quy trình xử lý sự cố.
Kết luận: chuyển khi workload đã ổn định, không phải khi bắt đầu
Nền tảng ML được quản lý phù hợp để thử nghiệm nhanh và chứng minh giá trị. GPU instance riêng phù hợp khi workload đã ổn định, chạy liên tục và cần kiểm soát sâu về hiệu năng, chi phí hoặc tuân thủ. Thời điểm chuyển hợp lý là khi doanh nghiệp gặp từ hai dấu hiệu trở lên và đã có người vận hành.
GreenNode AI Platform là nền tảng ML được quản lý của GreenNode, hỗ trợ toàn bộ vòng đời phát triển mô hình trên GPU NVIDIA H100 và A100: notebook có GPU, training từ một GPU đến cụm nhiều node, model tuning với tìm kiếm hyperparameter tự động, model registry và triển khai mô hình thành REST API endpoint có autoscaling. Doanh nghiệp trả phí theo mức sử dụng và không cần tự quản lý hạ tầng.
GreenNode GPU Instances cung cấp NVIDIA H200, H100 và RTX PRO 6000 Blackwell cùng các dòng GPU khác, với quyền truy cập trực tiếp vào GPU, kết nối NVLink và InfiniBand. Hạ tầng đặt tại 6 availability zone ở TP.HCM, Hà Nội và Bangkok, đạt ISO 27001/27017/27018, SOC 2 và Tier III. Giá thuê theo tháng, không yêu cầu cam kết dài hạn.
Khách hàng đang dùng GreenNode AI Platform có thể giữ nguyên môi trường thử nghiệm và chuyển dần từng workload sang GPU Instances trên cùng hệ sinh thái.
Trao đổi với đội ngũ GreenNode để đánh giá workload hiện tại và chọn cấu hình GPU phù hợp.
Câu hỏi thường gặp
Thuê GPU riêng có đắt hơn dùng nền tảng ML được quản lý không?
Tùy mức sử dụng. Với workload theo đợt, pay-as-you-go thường rẻ hơn. Với workload chạy gần như liên tục, giá thuê tháng của GPU instance riêng thường tối ưu hơn.
Bare metal H100 khác gì GPU instance thông thường?
Bare metal giao toàn bộ máy chủ vật lý, không qua lớp ảo hóa. GPU instance gắn GPU chuyên dụng vào máy chủ ảo, linh hoạt hơn về cấu hình và triển khai. Cả hai đều cho phép truy cập trực tiếp GPU.
Có thể dùng song song nền tảng ML được quản lý và GPU instance riêng không?
Có. Cách phổ biến là giữ nền tảng ML được quản lý cho thử nghiệm, fine-tune theo đợt, và dùng GPU instance riêng cho training dài ngày hoặc inference production.
Doanh nghiệp nên chọn H100 hay H200?
H200 có 141GB HBM3e, phù hợp training mô hình trên 100B tham số và LLM ngữ cảnh dài. H100 (80GB HBM3) đáp ứng tốt phần lớn workload training và inference hiện nay. Xem thêm so sánh H100 và H200.
