
Điểm chính
- Bài viết chia sẻ cách GreenNode xây dựng một cluster AI trên nền NVIDIA H100 từ đầu đến cuối – từ data center, rack đến compute, storage, networking và phần mềm – để phục vụ distributed training quy mô lớn.
- Phần khó nhất nằm ở kiến trúc và các ràng buộc thực tế (network, interconnect, nguồn cung, ngân sách, tiến độ). Doanh nghiệp có thể học hỏi từ hành trình này để tự xây AI stack của mình, hoặc đơn giản là chạy ngay trên nền tảng AI dựng sẵn của GreenNode.
Ở Phần 1 của loạt bài này, chúng tôi đã chia sẻ bối cảnh dự án và giới thiệu những thành phần nền tảng cần có để bắt đầu dựng một cluster HPC/AI. Nếu chưa đọc, bạn có thể xem lại tại đây.
Trong phần 2, chúng tôi sẽ phân tích các thành phần kiến trúc cốt lõi của một cluster AI – bao gồm thiết kế ở cấp node, rack và cluster – và cách một team in-house như chúng tôi kết nối mọi thứ lại với nhau để hệ thống thực sự vận hành được. Hãy sẵn sàng cho những bài học xương máu và cả những lần thất bại thực tế trên hành trình này. Nhiều mẹo trong bài dựa trên kinh nghiệm chủ quan của chúng tôi; các khuyến nghị chỉ mang tính tham khảo, không phải bản thiết kế áp dụng cho mọi trường hợp.
Nhưng trước khi đi vào phần triển khai đầy “hỗn loạn” (nhưng cũng rất đáng giá), hãy cùng nhìn rõ phần kiến trúc nền tảng mà bạn cần nắm để tự xây dựng cluster AI của riêng mình.
Giải phẫu một cluster AI
Workload AI có nhiều dạng – từ training mô hình đơn giản đến tìm kiếm hyperparameter phức tạp và distributed training quy mô lớn. Mỗi dạng có yêu cầu riêng, và hạ tầng của bạn phải phản ánh đúng điều đó. Với các use case đòi hỏi hiệu năng cao như của chúng tôi, lựa chọn duy nhất là kiến trúc distributed training quy mô lớn. Mô hình này là bắt buộc khi training các mô hình khổng lồ trên nhiều node và nhiều GPU, nơi hiệu năng và khả năng mở rộng là yêu cầu không thể thỏa hiệp.
Để vận hành hiệu quả kiến trúc này, có một số yêu cầu hạ tầng không thể bỏ qua:
- Distributed training đòi hỏi giao tiếp giữa các server với độ trễ thấp và băng thông cao.
- Cluster inference phải có tính sẵn sàng cao (high availability) và chịu lỗi tốt khi xảy ra sự cố – vượt xa những gì các hệ thống server truyền thống có thể đáp ứng.
Trước khi đưa một cluster AI vào hoạt động, bạn cần lên kế hoạch và triển khai cẩn thận ở ba cấp thiết kế. Mỗi cấp được xây dựng dựa trên cấp trước đó, và sai sót ở bất kỳ tầng nào cũng có thể gây nghẽn hiệu năng, làm hệ thống thiếu ổn định hoặc tạo ra vấn đề về khả năng mở rộng về lâu dài.
- Thiết kế cấp cluster: Đây là kiến trúc tổng thể của toàn bộ hệ thống triển khai. Ở cấp này, bạn xác định nền móng chiến lược, bao gồm data center chứa rack vật lý và năng lực vận hành (hệ thống làm mát, nguồn điện…) cùng network topology và fabric.
- Thiết kế cấp rack: Tập trung vào cách bố trí vật lý và logic của vị trí node, cấu trúc cáp và port trong từng rack. Trong trường hợp của chúng tôi, toàn bộ topology và mapping phải tự xây dựng thủ công – từ sơ đồ bố trí rack đến thiết kế đi cáp cuối cùng.
- Thiết kế cấp node: Lựa chọn tổ hợp GPU, CPU, bộ nhớ và ổ NVMe phù hợp cho mỗi node dựa trên workload AI của bạn.
5 thành phần cốt lõi trong kiến trúc cluster AI
Sau khi đã lên kế hoạch cho ba cấp thiết kế (cluster, rack và node), bước tiếp theo là chia hệ thống thành năm thành phần kiến trúc chính. Đây là những khối nền tảng quyết định cluster của bạn vận hành tốt đến đâu – và dễ bảo trì ra sao về lâu dài.
- Data center: Hạ tầng điện và vật lý – bao gồm phân phối điện, hệ thống làm mát và bố trí rack – nơi đặt và vận hành toàn bộ cluster.
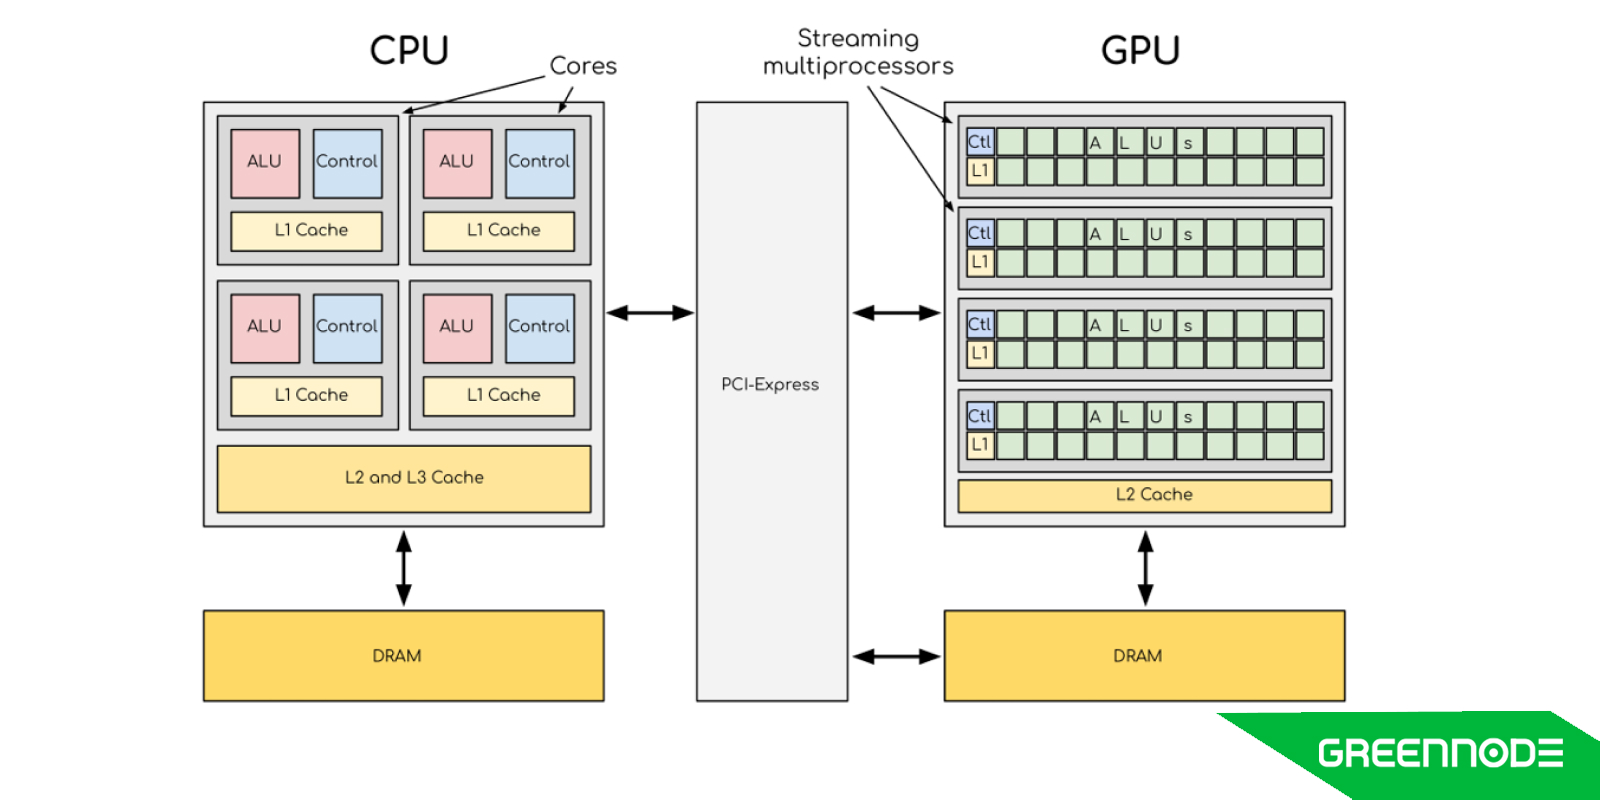
- Compute: Tổ hợp tài nguyên GPU và CPU cùng phần cứng đi kèm để xử lý workload AI – thường chạy trên nền tảng của NVIDIA, AMD, Intel hoặc các OEM như Asus, Gigabyte, Dell, HPE…
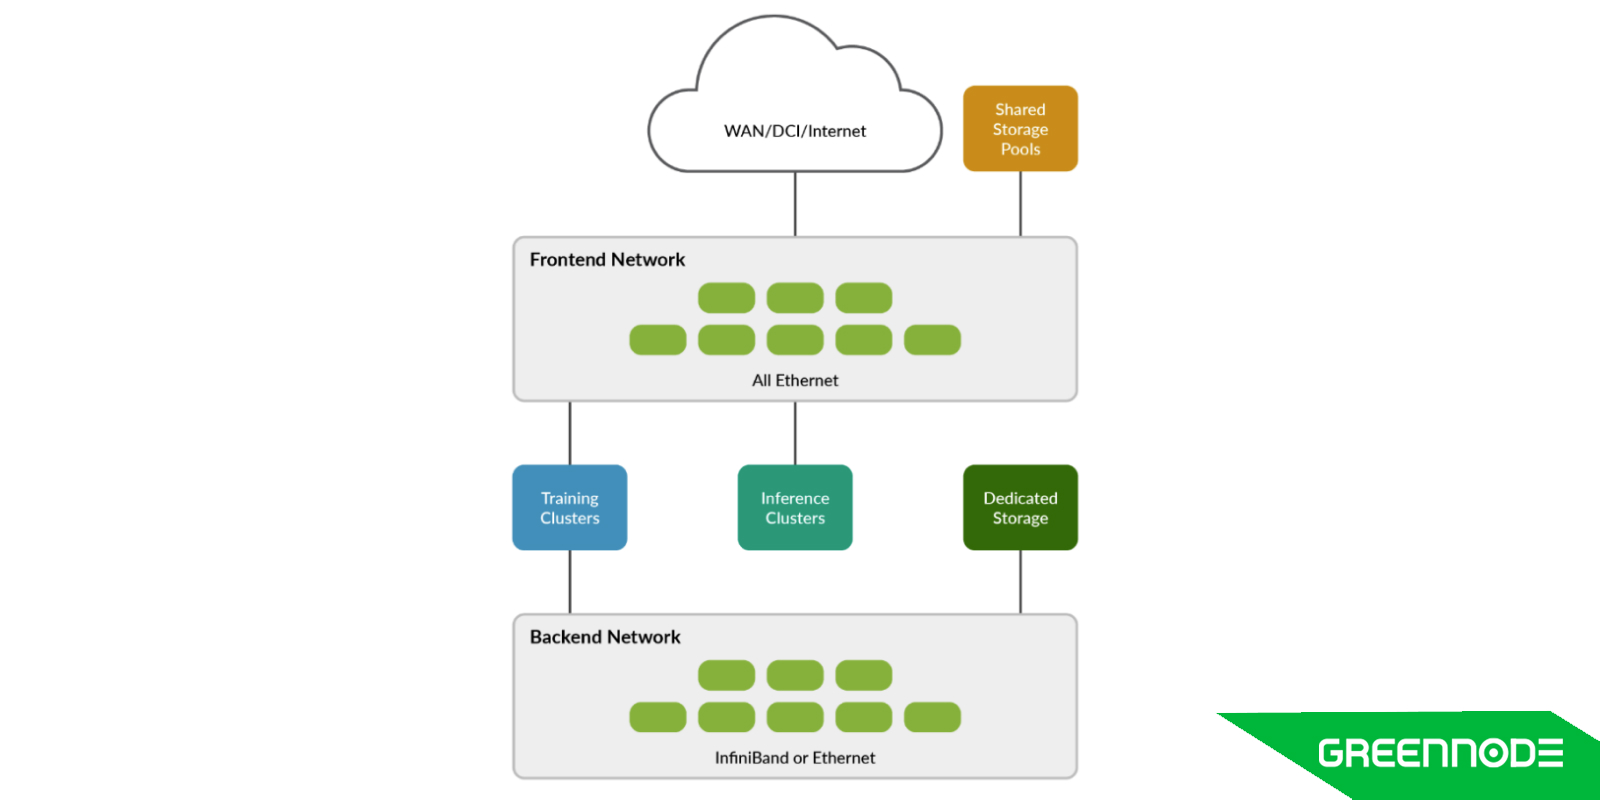
- Networking: Gồm nhiều mạng chuyên biệt cho tác vụ tính toán, lưu trữ dữ liệu, quản trị in-band và quản trị out-of-band nhằm đảm bảo hiệu năng và độ tin cậy.
- Storage: Lưu trữ và truy xuất dữ liệu hiệu quả cho các tác vụ AI hiệu năng cao, đảm bảo truy cập nhanh vào các tập dữ liệu lớn trong quá trình training và inference.
- Software: Bao gồm điều phối cluster, lập lịch job, phân bổ tài nguyên và điều phối container để quản lý workload, đảm bảo hệ thống vận hành hiệu quả và dễ mở rộng.
NVIDIA Cloud Partner
Tại GreenNode, chúng tôi chọn xây dựng cluster AI dựa trên kiến trúc tham chiếu NVIDIA Cloud Partner (NCP). Đây là bản thiết kế để xây dựng các data center hiệu năng cao, dễ mở rộng và bảo mật, đủ sức xử lý generative AI và mô hình ngôn ngữ lớn (LLM). Hiểu đơn giản, NVIDIA cung cấp cho các đối tác được lựa chọn một gói kiến trúc trọn bộ với các thành phần tương thích. Gói này bao gồm:
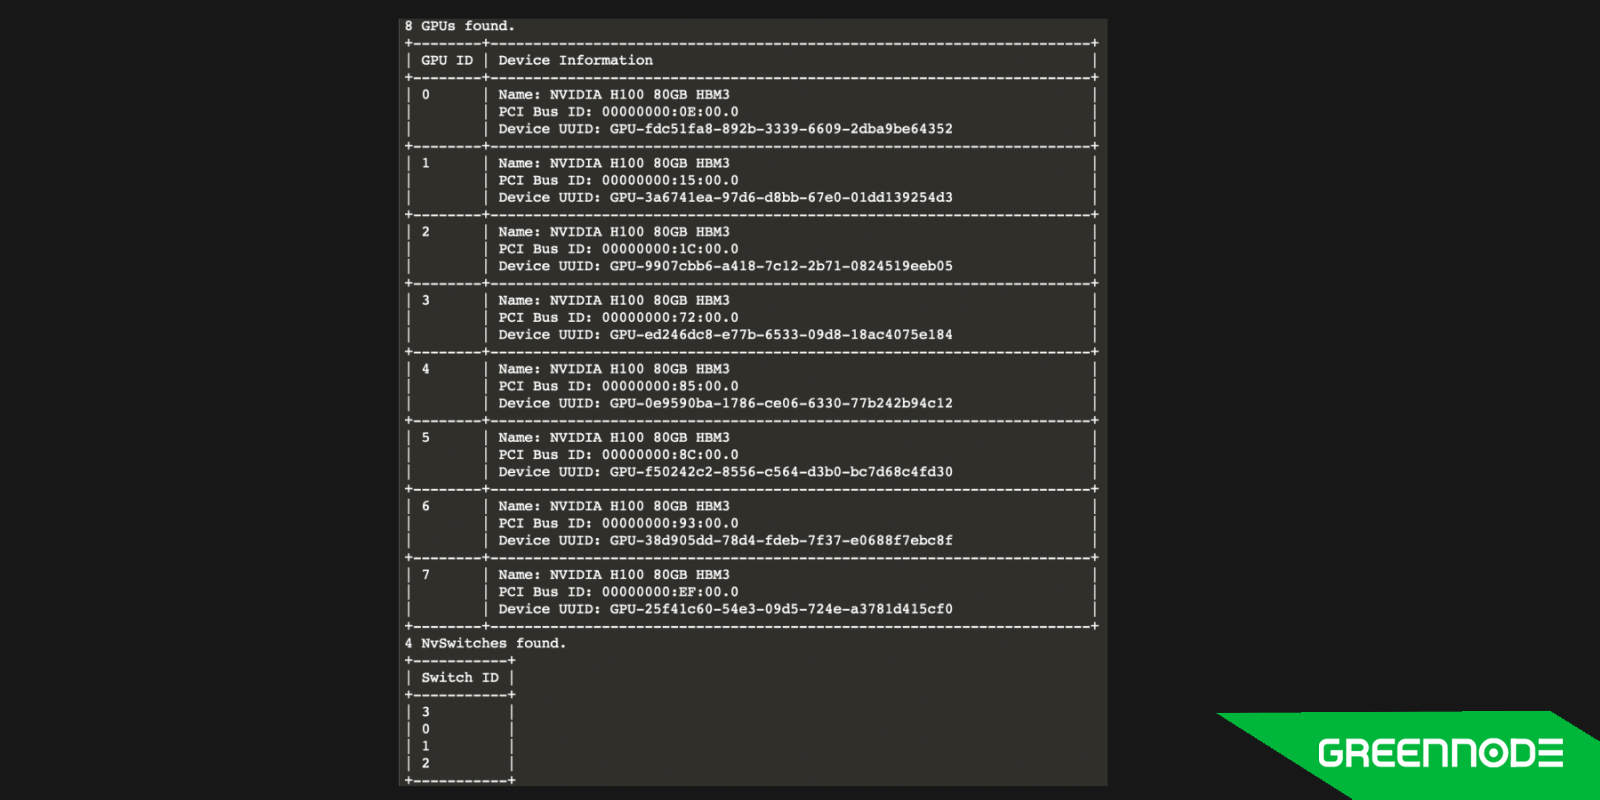
- GPU đi kèm server từ các OEM đã được NVIDIA kiểm định. Chúng tôi sử dụng 1.024 GPU NVIDIA H100 Tensor Core, tích hợp trên phần cứng server của Gigabyte – một OEM đã được kiểm định trong chương trình NCP.
- Network: Chúng tôi kết hợp hai lớp mạng – NVIDIA Cumulus Ethernet cho quản trị out-of-band và Mellanox InfiniBand cho giao tiếp tính toán in-band – đảm bảo hiệu năng GPU-to-GPU giữa các node với độ trễ thấp và băng thông cao.
- Phần mềm: Dù NCP thường đi kèm Base Command Manager (BCM) và NVIDIA AI Enterprise, chúng tôi tận dụng provisioning stack sẵn có và vận hành cluster theo mô hình điều phối hybrid: Slurm cho lập lịch job và quản lý tài nguyên, Kubernetes cho điều phối container và triển khai workload linh hoạt.
Dù NVIDIA có cung cấp Excelero NVMesh hoặc DDN trong gói, chúng tôi chọn tích hợp nền tảng VAST Data cho lớp lưu trữ. VAST Data mang lại hiệu năng, quy mô và sự đơn giản cần thiết để phục vụ các workload training AI throughput cao, đồng thời mở ra nhiều cơ hội mở rộng tốt hơn trong tương lai.
Bên cạnh đó, toàn bộ rack được chúng tôi đặt tại STT Data Center ở Bangkok, Thái Lan – một cơ sở colocation đáng tin cậy, nổi tiếng với khả năng hỗ trợ nhanh và vận hành minh bạch.
Để kết nối tất cả các thành phần – compute, storage, networking và điều phối – bạn cần một “xương sống” giao tiếp thống nhất và hiệu năng cao. Đây là lúc khái niệm AI interconnect phát huy vai trò. AI interconnect là framework đảm bảo dữ liệu được di chuyển và trao đổi hiệu quả giữa các thành phần tạo nên AI cloud.
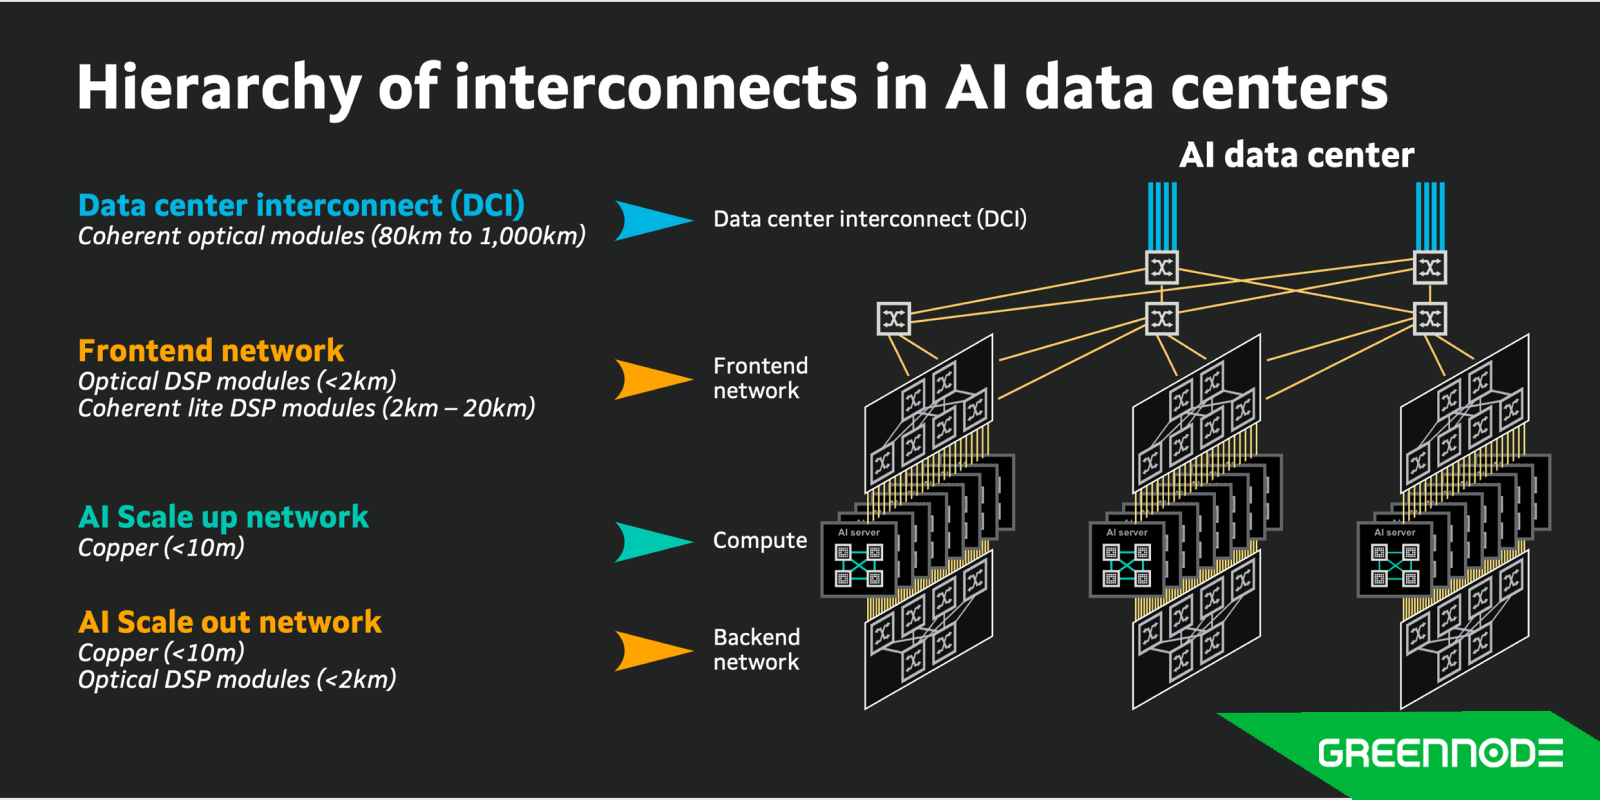
Tại GreenNode, kiến trúc interconnect phần cứng được thiết kế để tối ưu cả tốc độ lẫn độ tin cậy, dựa trên các công nghệ chủ chốt sau:
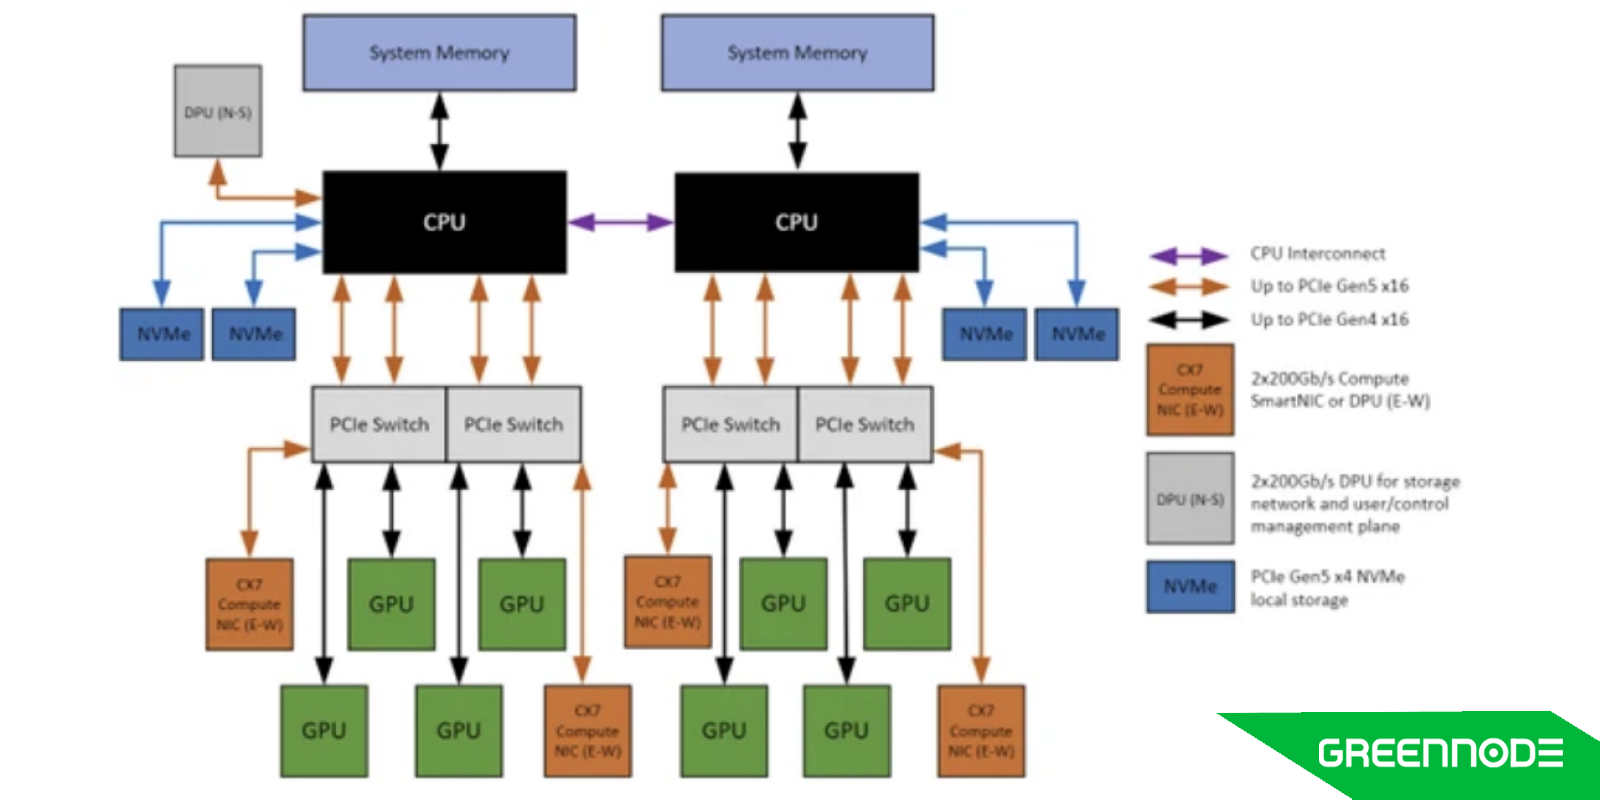
- NVLink/PCIe Switch: Cho phép giao tiếp GPU-to-GPU tốc độ cực cao, cả trong một node lẫn giữa nhiều node, giúp training mô hình lớn hiệu quả mà không bị nghẽn.
- InfiniBand (IB): Giao thức mạng tốc độ cao, lossless, độ trễ thấp, dùng cho RDMA (Remote Direct Memory Access) – lý tưởng cho distributed training và giảm thiểu overhead giao tiếp giữa các server.
- Rail topology: Triển khai nhiều đường mạng song song để vừa dự phòng vừa tăng hiệu năng, đảm bảo hệ thống vẫn hoạt động và mở rộng được ngay cả khi tải cao hoặc xảy ra sự cố.
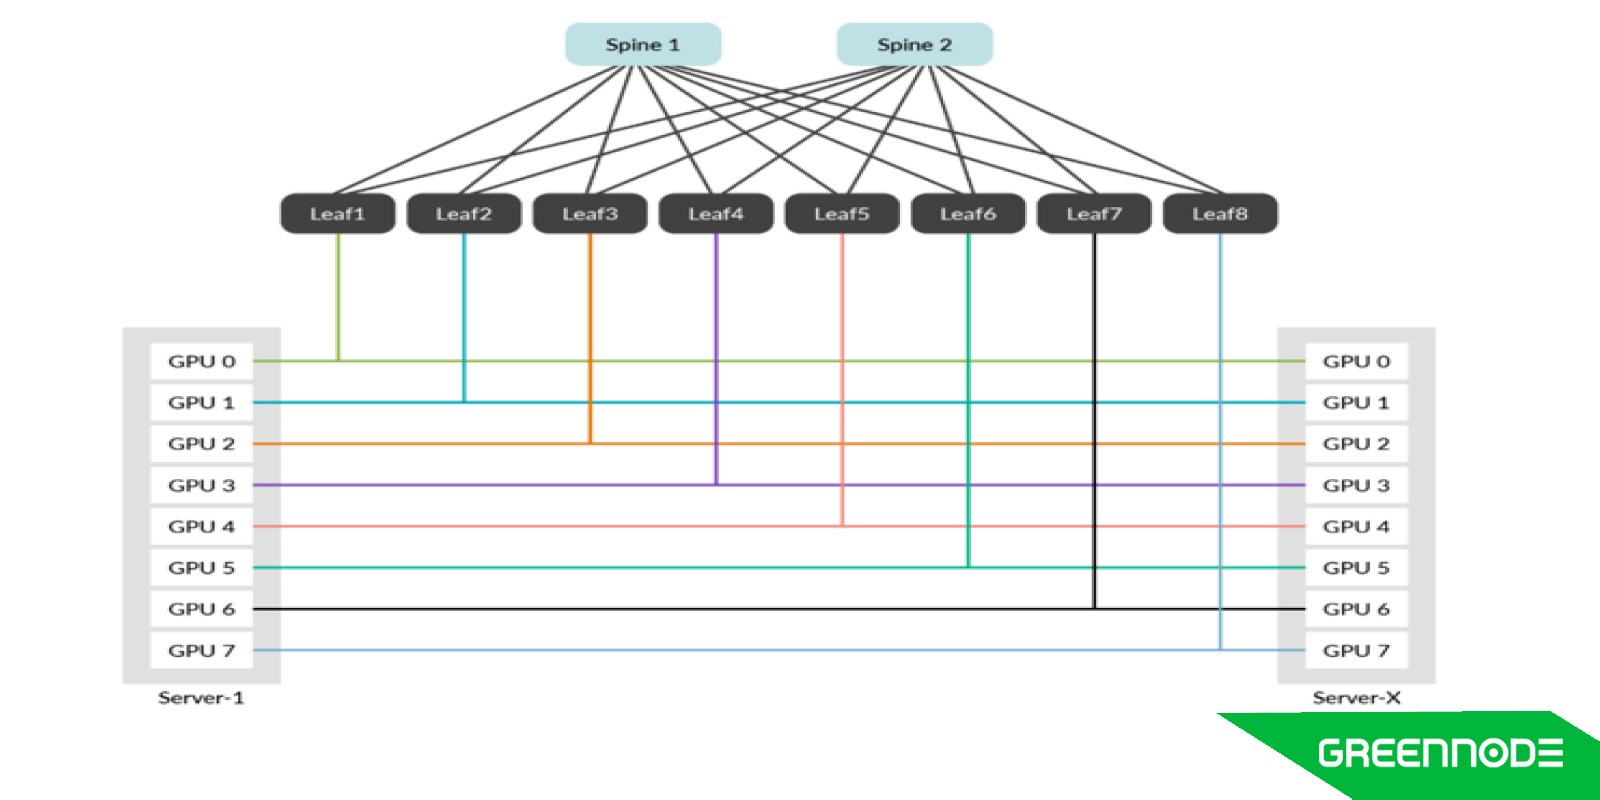
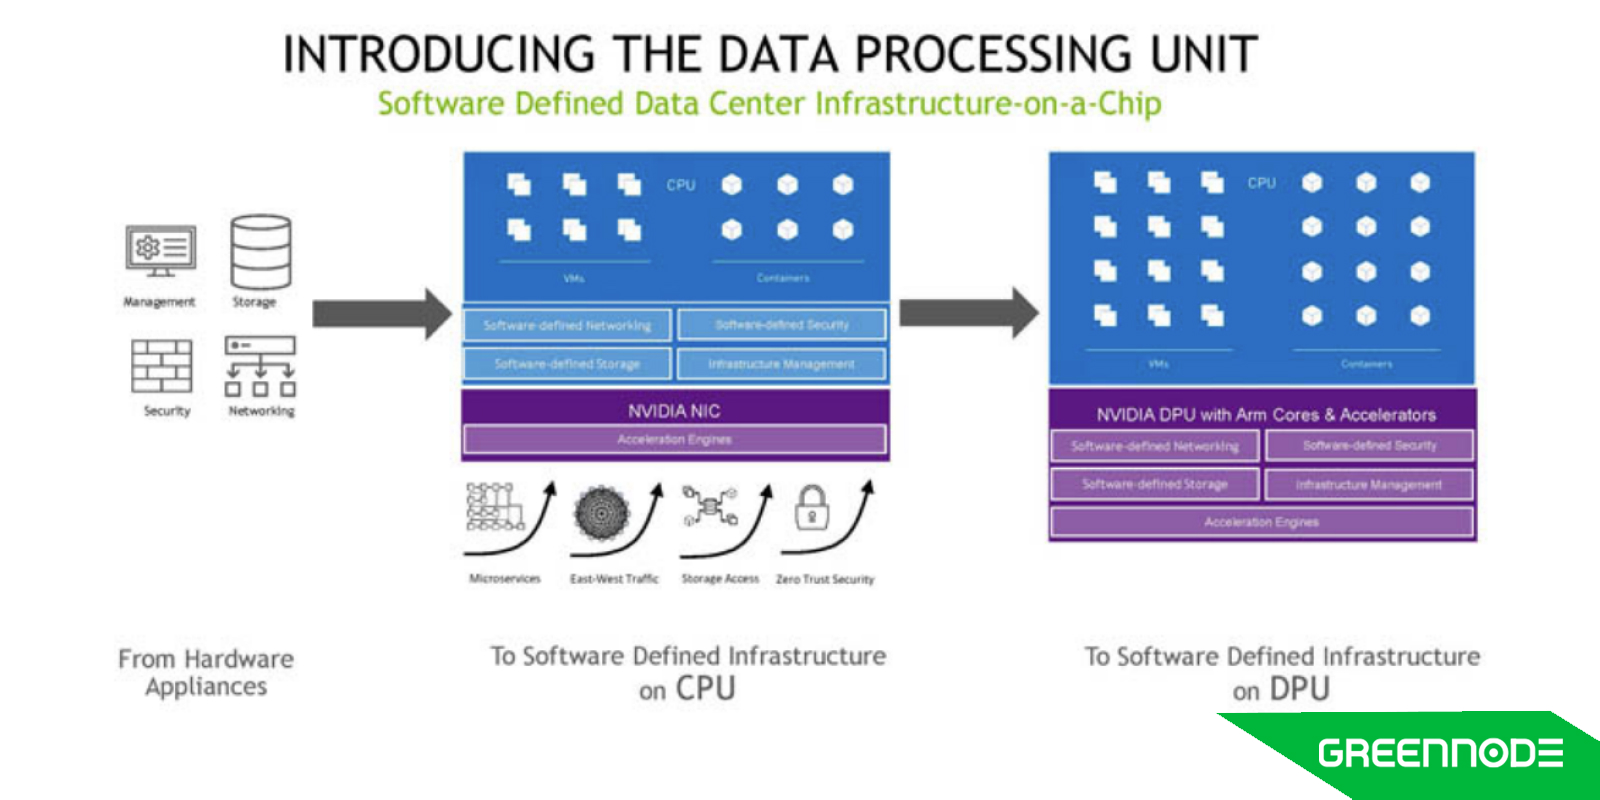
- DPU (Data Processing Unit): Về bản chất là một smart NIC, DPU gánh bớt nhiều tác vụ cho CPU như mã hóa, quản lý khóa, NVMe-over-Fabrics (NVMe-oF), nén dữ liệu… – giải phóng tài nguyên cho host, đồng thời tăng cường bảo mật và hiệu năng I/O.
Những yếu tố cần cân nhắc khi “lắp ghép” hệ thống
Dựng một cluster AI không chỉ là chọn GPU mạnh và cài đúng phần mềm. Đó là bài toán cân bằng giữa quyết định kỹ thuật, tiến độ bàn giao và ràng buộc kinh doanh – trong khi thông tin thường xuyên không rõ ràng.
Một trong những thách thức lớn nhất của chúng tôi là thiếu kiến trúc tham chiếu chính thức, đặc biệt ở phần network topology, bao gồm thiết kế PCIe và NCCL. Những gì chúng tôi nhận được chủ yếu là slide bản nháp, danh sách BOM và hướng dẫn ở mức tổng quan. Điều đó có nghĩa là chúng tôi phải tự xây dựng toàn bộ topology – từ bố trí data center đến mapping rack và đi cáp – mà không có tiêu chuẩn rõ ràng nào để làm theo.
Cùng lúc đó, thời gian chờ mua sắm thiết bị (procurement lead time) nhanh chóng trở thành nút thắt nghiêm trọng. Linh kiện được giao thành nhiều đợt, và chỉ một chậm trễ nhỏ từ một nhà cung cấp cũng có thể khiến cả quá trình triển khai bị đình trệ. Chúng tôi phải theo dõi giao hàng hằng ngày, follow-up hằng tuần và liên tục hối thúc cập nhật chỉ để bám kịp tiến độ. Tính đến giữa tháng 6/2024, một số thiết bị mạng vẫn chưa về.
Những chậm trễ này ảnh hưởng trực tiếp đến mô hình tài chính. Với khoản đầu tư lớn, mọi thay đổi đều phải được giải trình và thẩm định lại. Kiến trúc của chúng tôi đã được điều chỉnh nhiều lần dựa trên dự báo chi phí, khả năng cung ứng của nhà cung cấp và yêu cầu hỗ trợ – chẳng hạn như cân nhắc có nên giữ thiết bị Ethernet của NVIDIA để tuân thủ NCP hay không, dù chi phí cao và thời gian giao hàng dài.
Tính cấp bách của dự án càng làm mọi thứ phức tạp hơn. Chúng tôi chịu áp lực phải bàn giao một cluster AI vận hành hoàn chỉnh chỉ trong năm tháng – thời hạn xuất phát từ cam kết hợp đồng với khách hàng. Trễ hạn không chỉ khiến chi phí đội lên mà còn có thể làm mất luôn hợp đồng.
Trước áp lực lớn về thời gian và tài chính, chúng tôi nhanh chóng nhận ra rằng tự đứng ra xây dựng kiến trúc là con đường khả thi duy nhất. Nếu chỉ dựa vào cấu trúc, tài liệu hay các thiết kế tham chiếu “đã kiểm định” từ nhà cung cấp, thời gian triển khai nhiều khả năng sẽ tăng gấp đôi – thậm chí tệ hơn – vì:
- Nguồn nhân lực hạn chế
- Rào cản về địa lý
- Kiến trúc tham chiếu từ nhà cung cấp chưa hoàn thiện
Trong bối cảnh đó, tận dụng năng lực in-house và thiết kế dựa trên điều kiện thực tế – thay vì chờ đợi những template hoàn hảo – đã trở thành một lựa chọn chiến lược bắt buộc.
Những gì chúng tôi rút ra được
Hy vọng bài viết đã giúp bạn hình dung phần nào khối lượng công việc khổng lồ phía trước khi tự xây dựng cluster AI – có lẽ cũng “đau” không kém những hóa đơn cloud hằng tháng mà bạn từng phải chịu. Nhưng tin tốt là đã có người mở đường, và cuộc chơi này không còn là đặc quyền của các ông lớn công nghệ. Với cấu trúc phù hợp, bạn có thể xây dựng thông minh hơn – và tiết kiệm đáng kể chi phí cho doanh nghiệp.
Ở phần tiếp theo, chúng ta sẽ đối mặt với một sự thật phũ phàng: GPU vốn dĩ không ổn định. Và khi sự cố xảy ra (chắc chắn sẽ xảy ra), sự bất ổn đó có thể khiến bạn tốn kém không ít. Để xử lý, chúng tôi sẽ đi sâu vào các framework, hướng dẫn troubleshooting và cách khắc phục thực tế giúp bạn tiết kiệm thời gian và chi phí – đọc tiếp Phần 3 tại đây.
P.S. Nếu cả hành trình này có vẻ quá sức, bạn luôn có thể trải nghiệm GreenNode AI Platform – giải pháp one-click đáp ứng trọn vẹn nhu cầu training và inference mô hình end-to-end.
